
系列:奇幻塔防開發實錄:用 Claude 打造一款有靈魂的塔防遊戲
今日工具:git worktree + Claude Code(數據回顧)
今日進度:三筆平行開發實驗彙整、一份「何時該開 worktree」的決策準則
第二週結束。後端從一個空目錄長成了:Clean Architecture 骨架(Day 8)、劇情狀態機(Day 10)、無畫面模擬器(Day 11)、REST API 與 DynamoDB 倉儲(Day 12–13),加上 Terraform 的 serverless 地基與單表的 GSI(Day 9、13)。這週我最想回答的問題只有一個——README 開頭就承諾過的——用 git worktree 開兩個 Claude Code session 平行開發,到底有沒有比較快?
Day 12 做了第一次實驗,Day 13 又做了兩次,其中一次是刻意設計的反例。三筆數據放在一起,答案比「有」或「沒有」更有意思:它快的時候很快,慢的時候不只慢,還會留下測試抓不到的錯。
量測方式同 Day 12:序列估計用同規模任務的歷史實測推估(誤差約 ±15%),平行實測用碼表,從兩個 session 開始到合併完成、測試全綠;token 為 /cost 讀數的輸出 token;「切換」指我主動把注意力從一個終端機移到另一個的次數。
| # | 任務 A | 任務 B | 重疊檔案 | 序列估 | 平行實測 | 差異 | 切換 | 衝突 |
|---|---|---|---|---|---|---|---|---|
| 1(Day 12) | 戰鬥結果驗證 usecase + handler | 劇情 handler + mapError | router.go |
100 min | 62 min | −38% | 11 | 1 |
| 2(Day 13 上午) | DynamoDB 倉儲(item.go + save_repo.go)+ platform/dynamo.go |
Terraform 補 GSI1 + TTL + PITR |
無 | 70 min | 39 min | −44% | 6 | 0 |
| 3(Day 13 下午) | router 加 middleware 鏈重構 | auth 空殼 middleware(Day 27 前置) | router.go、middleware/ |
45 min | 51 min | +13% | 14 | 3 |
| 合計 | 215 min | 152 min | −29% | 31 | 4 |
輸出 token:三次平行合計 118k,序列估計 106k,多約 11%。
實驗 2 是最漂亮的案例:Go 與 HCL 兩種語言、兩個目錄、零交集,而且兩邊都有長等待(go test ./... 全跑、terraform init 下載 provider)。我幾乎是在兩個「等待」之間來回,6 次切換全都有意義。
實驗 3 是我刻意做的反例:兩個任務都在改 router.go 與 middleware/。結果不只慢了 13%,三次衝突裡有一次是「兩邊都把 middleware.Timeout 移到不同位置」,合併後 Timeout 被掛了兩次、順序還錯了,go test 沒抓到,是 curl 一個慢請求才發現。平行開發最貴的成本不是衝突本身,是衝突解錯了沒人知道。
把三筆數據攤開,規律很清楚:
| 適合平行 | 不適合平行 |
|---|---|
| 兩個任務碰的檔案集合幾乎不相交(實驗 2) | 兩邊都要改同一個「組裝點」(router.go、main.go) |
每個任務都有長等待(跑測試、terraform init、bun install) |
任務本身很短(< 20 分鐘),切換成本吃掉收益 |
| 需要不同環境(port、語言工具鏈、Terraform 的 provider 快取) | 任務 B 依賴任務 A 的介面(B 會猜錯 A 的命名) |
| 任務可以各自寫測試證明完成 | 完成判準是「整體行為對」,要兩邊合起來才能驗 |
把這兩欄接起來,其實是一棵深度只有三層的決策樹:
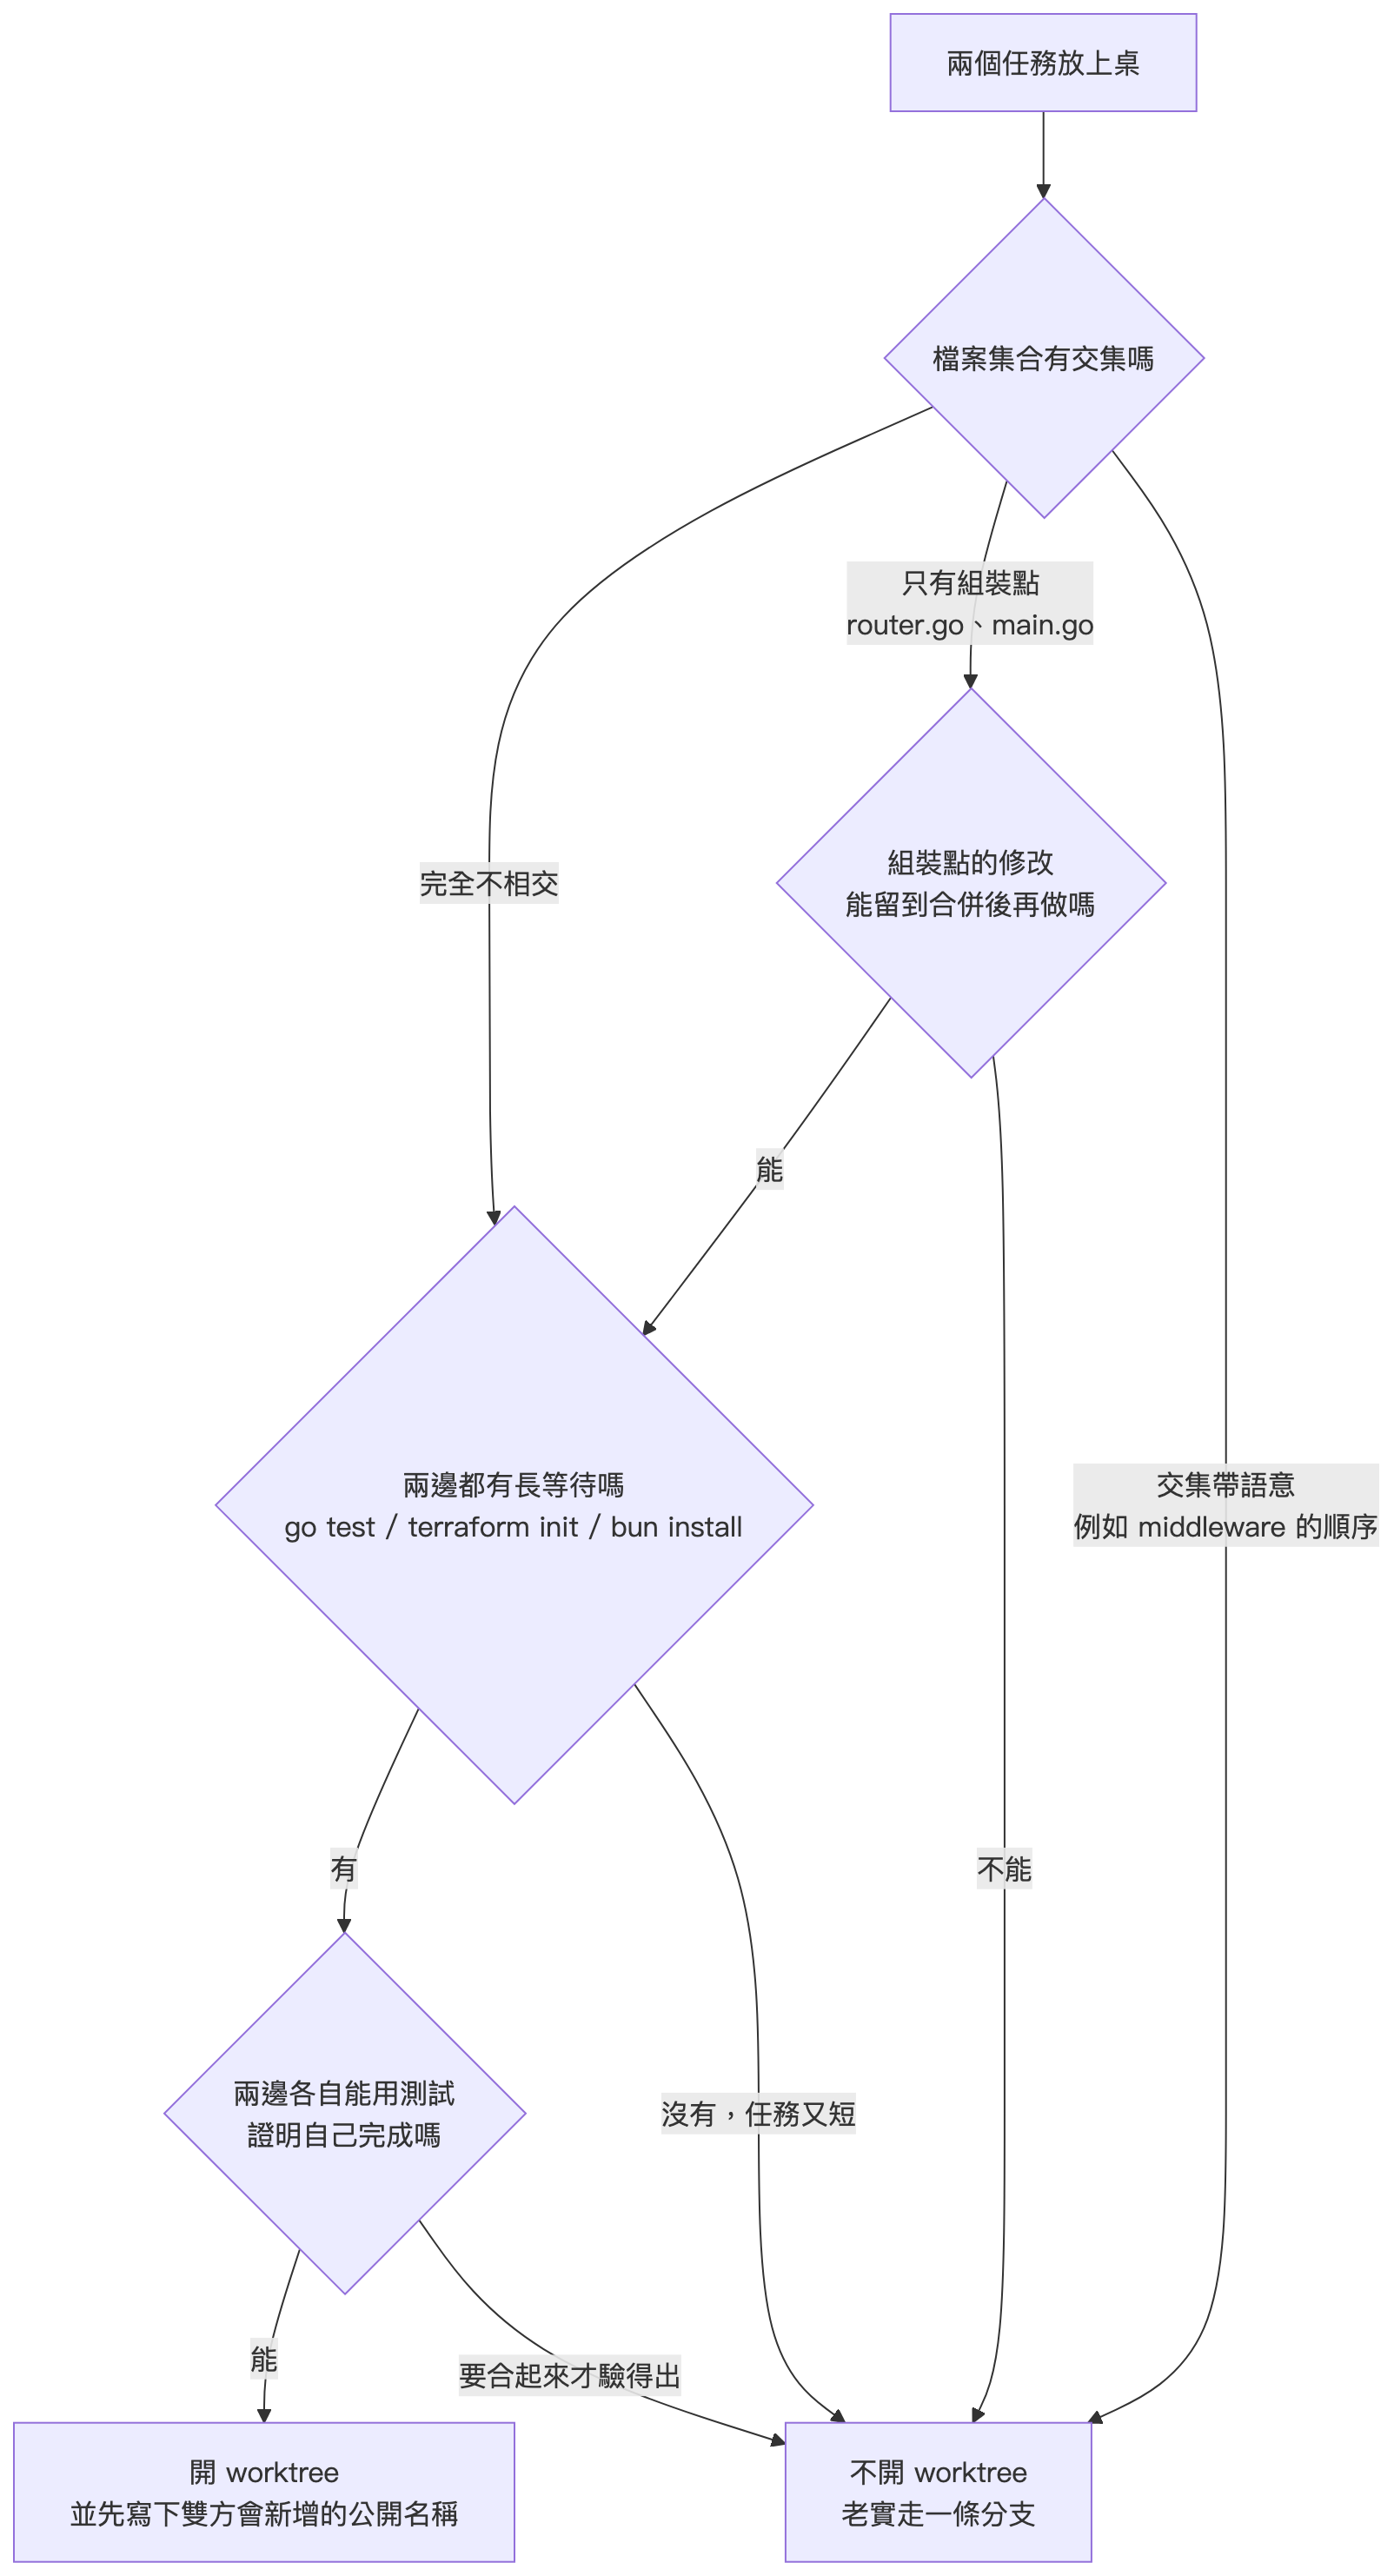
實驗 1 的 router.go 衝突之所以可接受,是因為它是可預期的、機械式的衝突——兩邊各加一行路由,Claude 三秒解完,而且解錯了測試會抓到。實驗 3 的衝突是語意衝突,兩邊對「middleware 該怎麼排」有不同想法,這種才該避免。
我把這棵樹濃縮成三句話寫進根目錄 CLAUDE.md 的「worktree 開發須知」:一、開 worktree 前先列兩個任務會動的檔案,交集只能是組裝點;二、組裝點的修改留到合併後由一個 session 做;三、每個 worktree 的 session 結束前必須 go test ./... 全綠,並跑一次 make smoke。第三條是實驗 3 的血淚。
第一條聽起來像官僚,實際上只花兩分鐘:我讓兩個 session 各自先進 Plan mode 列出「會新增或修改的檔案」,把兩份清單並排看一眼就知道該不該開。實驗 3 我當時偷懶跳過這一步,代價是 51 分鐘加上一個沒被測試抓到的 Timeout。
注意力:三次實驗總共 31 次切換。我在 Day 12 說「worktree 省的是等待、不是注意力」,這週更確定了——實驗 3 切了 14 次,超過某個門檻後我開始搞混哪個終端機是哪個分支,有一次差點在錯的 worktree 裡 git commit。claude --worktree 搭 --tmux 讓分頁名稱就是分支名,有幫助,但治標;真正的解法是任務夠獨立,讓切換次數自然降到個位數。
token:多 11% 是兩個 session 各讀一次 CLAUDE.md 與相關 domain 檔案的代價。Day 6 把 CLAUDE.md 拆成根+子目錄兩層在這裡回本了:backend/ 的 session 不會把前端規則也讀進去;實驗 2 的 Terraform session 更是完全不碰 Go 的規則。
心智模型:兩個 session 不共享記憶。實驗 1 任務 B 不知道任務 A 定義了 ErrInvalidReport,合併後 mapError 少一個 case 是我手動補的;實驗 3 兩邊對 middleware 順序的認知不同,根本原因也是這個。對策是把「這次任務會新增的公開名稱、會動的組裝點」先寫進任務描述,兩邊都看得到——這其實就是 Day 13 那張 REST 契約表的精神,只是尺度縮小到兩個分支之間。AI 同事跟人類同事一樣,需要開會。
跟第一週對照(兩週的數字都是那六天的,不含今天寫週記本身):第一週 12 個 Claude session、830 專注分鐘,全部序列;第二週 15 個 session、約 790 專注分鐘,其中 152 分鐘是平行的。做的事情明顯比第一週多,專注分鐘反而少——但我不敢把功勞全記在 worktree 上,第二週的任務本來就比較「有型」(有 ADR、有契約、有型別),Claude 猜錯的機率低很多,這可能才是主因。
還有一個沒放進表格、但我覺得最值得說的成本:worktree 讓「等待」消失,也讓「思考的空檔」消失。序列開發時,Claude 跑測試的三十秒是我重看設計、發現「這個名字取得不對」的時間;平行開發時那三十秒被另一個 session 填滿了。實驗 2 那 39 分鐘我一次都沒有停下來想架構,做完才發現 dynamo.NewSaveRepo 應該接受一個已經建好的 client,而不是自己在建構子裡 config.LoadDefaultConfig——那會讓每次 Lambda invoke 都重建一次連線。這個決定要到 Day 26 才會付出代價。
errors.Is(Day 10、12)讓 handler 的錯誤翻譯只有 12 行,之後加新錯誤只要在 mapError 加一個 case。null(Day 13)。換成 DynamoDB 之後這個坑一模一樣:cleared 是空的時候,make + copy 出來的空 slice 才會序列化成 []。這種 bug 只有真實請求打得出來。第三週是前端:Vue 3 + Canvas 引擎(Day 15)、CI/CD(Day 16)、Pinia 狀態與升級樹(Day 17)、劇情介面(Day 18)、RWD(Day 19)、自訂 workflow 除錯(Day 20)。前五天我打算全部序列,因為引擎、狀態、介面是一條依賴鏈,不符合上面那張表的任何一列——硬開 worktree 只會重演實驗 3。唯一例外是 Day 16 的 CI/CD 跟 Day 15 的引擎沒有交集,如果進度允許會平行。worktree 正式再登場是 Day 26 效能優化:前端 SpatialGrid 與後端在本機 net/http 模式下的 pprof(PPROF=1 才會起 :6060)兩條線完全不相交,是教科書等級的平行案例——Lambda 上沒有原生 pprof 可以連,所有剖析都得在本機那一半做。
worktree 有沒有比較快?任務獨立時省 38–44% 的 wall-clock,任務糾纏時反而慢 13%,而且會製造測試抓不到的語意衝突。 它省下的是等待時間,不是注意力;它需要的是事前把檔案集合與公開名稱講清楚,而這件事本身就是好的工程習慣——不管有沒有 AI。
補一句關於「週記放哪」:我沒有在倉庫裡開 docs/weekly/。週記就是這篇文章,倉庫再擺一份摘要只會多出一個永遠跟文章不同步的真相;只有那三條 worktree 規則需要進 CLAUDE.md,因為它會被 Claude 讀進去。下週見。
CLAUDE.md 新增「worktree 開發須知」三條規則Day 15:Vue 3 + Canvas:塔防戰場渲染引擎從零到一。


 iThome鐵人賽
 看影片追技術