

Day 9 跑完第一批 REAL benchmark 後,我得到了一個非常直觀的數字:
12 題答對 10 題,Accuracy = 83.33%。
如果只是做 benchmark,這個結果其實已經可以拿來比較。
但一路做到 Day 12,我反而越來越覺得:
correct / incorrect 這兩個欄位太粗了。
因為同樣是答錯,不同錯誤的風險可能完全不同。
假設模型 A 答錯時說自己只有 55% 把握。
模型 B 也答錯,但它說自己有 100% 把握。
如果最後資料裡都只留下:
correct = false
那兩個 case 在 Accuracy 裡完全沒有差別。
可是如果真的要把模型接進產品或自動化流程裡,第二種錯誤明顯更值得注意。
所以 Day 13 我決定先不要增加新的 benchmark,也沒有再呼叫模型。
今天要做的是:
把「答錯」從一個布林值,拆成可以被機器分析、追蹤,而且能回到 evidence 的 Failure Signals。
目前 Day 9 的每一筆 REAL record,其實已經包含不少資訊:
也就是說,我手上的 evidence 其實比 Accuracy 多很多。
以前這些欄位只是各自存在。
Day 13 開始,我想把它們整理成一層正式的 diagnosis。
例如一個 case 可能不只是:
incorrect_answer
它還可能同時是:
overconfident_error
甚至可能是:
high_agreement_error
這三個不是互斥類別。
它們描述的是同一筆錯誤的不同特徵。
所以 Day 13 第一個設計決定就是:
Failure taxonomy 必須支援 multi-label。
我不想硬逼每一筆錯誤只能選一個分類。
做到 failure diagnosis 時,有一個很容易掉進去的陷阱。
假設看到模型答錯一道 reasoning 題,很自然會想寫:
「這是 reasoning failure。」
甚至進一步標:
「hallucination。」
但這些已經不是單純從資料直接觀察到的事實。
例如:
模型答錯,而且 confidence = 1.0。
這是資料直接告訴我的。
但「它為什麼錯」就不一定能靠這些欄位直接判斷。
所以 Day 13 把 diagnosis 分成兩層。
第一層是 Observed Failure Signals。
這些必須可以從 records 直接、確定地算出來。
第二層是 Root-cause Hypotheses。
例如:
這些是對失敗原因的解釋。
而今天我刻意不讓另一個 LLM 來幫我貼 root cause。
原因很簡單:
如果我做的是 AI Reliability evaluator,結果 failure taxonomy 本身又依賴另一個不確定的 AI 判斷,那整條 evaluation chain 又多了一層需要驗證的東西。
所以 Day 13 採用很保守的原則:
沒有 deterministic evidence,就不要猜。
最後實際跑完後,所有 Day 9 case 的 root_cause_hypotheses 都保持空白。
這不是功能沒做完。
反而是今天刻意保留的界線。
如果我要定義什麼叫 overconfident_error,就一定要回答:
多少 confidence 才算 overconfident?
0.8?
0.9?
0.95?
如果 threshold 只是偷偷寫死在 Python 裡,未來換版本後很容易連自己都不知道以前怎麼分類。
所以 Day 13 加入 versioned diagnosis policy。
目前:
day13-observed-failure-taxonomy-v1
day13-diagnosis-policy-v1
而且 threshold 都是明確保存的。
目前規則為:
| Failure Signal | 規則 |
|---|---|
incorrect_answer |
模型答案錯誤 |
overconfident_error |
Incorrect 且 self-confidence ≥ 0.90 |
high_agreement_error |
Incorrect 且 agreement ≥ 0.80 |
low_agreement_error |
Incorrect 且 agreement ≤ 0.50 |
insufficient_information_failure |
應該 abstain 的題目回答錯誤 |
這樣未來如果 policy 改成 confidence ≥ 0.95 才算 overconfident,我不會偷偷把 Day 13 的舊結果一起改掉。
同一筆 record 加上同一份 policy,應該永遠得到相同 diagnosis。
有了多個 signals 之後,很容易再加一個:
risk_score = 87.42
看起來很精準。
但問題是:
87.42 到底代表什麼?
如果只是把各種 threshold、權重和 heuristic 混在一起,最後反而很難解釋。
所以 Day 13 沒有做黑箱分數。
目前採用簡單、可追溯的 severity rule:
| Severity | 規則 |
|---|---|
CRITICAL |
Incorrect、self-confidence ≥ 0.95,而且 agreement ≥ 0.90 |
HIGH |
Incorrect,而且 self-confidence ≥ 0.90 或 agreement ≥ 0.80 |
MEDIUM |
Incorrect,但沒有觸發上面的 escalation |
NONE |
Correct,而且沒有 observed failure signal |
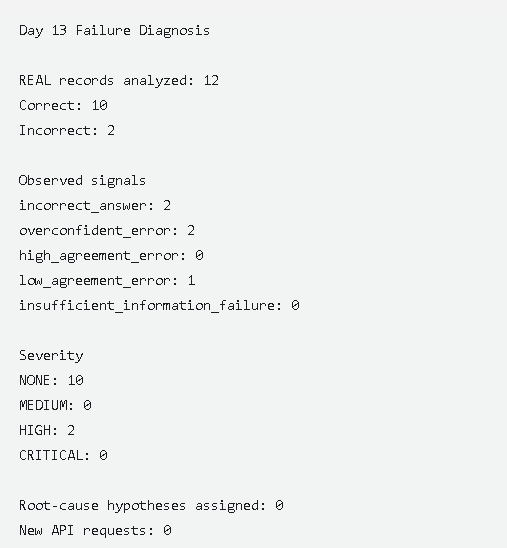
Day 13 套用在既有 Day 9 REAL records 的 diagnosis summary。兩筆錯誤都屬於 overconfident error,但目前沒有任何 high-agreement error,也沒有在缺乏 deterministic evidence 的情況下自動推測 root cause。
看到
severity 時,可以直接追回答案:
它到底踩中了哪一條規則。
今天分析的資料全部來自之前已經完成的 Day 9 REAL run。
也就是:
20260923T132132Z-d4f192b1
而且這份資料在 Day 12 已經經過 offline verifier:
PASS。
所以 Day 13 做的是:
Derived analysis of existing REAL data
不是新的 REAL model experiment。
今天的 OpenAI API requests:
0。
原本 Day 9 的 records.jsonl 也完全沒有修改。
重新檢查 SHA-256 後,仍然符合 Day 12 的 canonical manifest。
Failure diagnosis 看起來只是幾條 if statement,但其實有幾個 edge case 很容易出問題。
例如:
confidence 剛好等於 0.90 算不算 overconfident?
一筆資料可以不可以同時擁有兩個 failure signal?
如果 evidence 缺失,應該硬分類還是明確留空?
Correct case 如果 confidence = 1.0,可不可以因為「太有自信」就被標成 error?
這些都必須先固定。
因此 Day 13 加入 synthetic unit tests。
最後完整 test suite:
112 passed in 3.29s
測試確認:
overconfident_error
high_agreement_error
測試資料是 Synthetic。
真正的 Day 13 analysis 才是套用在 Day 9 已存在的 REAL records 上。
Day 9 的資料共有:
| 項目 | 數量 |
|---|---|
| Total | 12 |
| Correct | 10 |
| Incorrect | 2 |
套用 Day 13 policy 後,Observed Failure Signal 分布是:
| Signal | Count |
|---|---|
incorrect_answer |
2 |
overconfident_error |
2 |
high_agreement_error |
0 |
low_agreement_error |
1 |
insufficient_information_failure |
0 |
Severity 則是:
| Severity | Count |
|---|---|
| NONE | 10 |
| MEDIUM | 0 |
| HIGH | 2 |
| CRITICAL | 0 |
這個結果其實比我原本預期更有意思。
Day 9 唯二的 incorrect cases:
D9-009
以及:
D9-010
兩題全部收到:
overconfident_error
也就是說,在這批小型 benchmark 裡,模型目前出現的兩個錯誤都不是:
「我不太確定,而且答錯。」
而是:
「我幾乎完全確定,但我答錯。」
這跟 Day 9 當時觀察到的現象一致,但今天終於不只是文章裡的人工作者描述。
它正式變成 machine-readable failure signal。
D9-009 的 Gold Answer 是 16。
Primary answer 是 20。
所以最基本的 signal:
incorrect_answer
一定成立。
它的 self-reported confidence 是:
1.0
超過 policy 的 0.90 threshold,因此再得到:
overconfident_error
但是 agreement 是:
0.6667
它沒有達到 high_agreement_error 的 0.80 threshold,也沒有低到 low_agreement_error 的 0.50 以下。
因此最後 diagnosis 是:
incorrect_answer
overconfident_error
Severity:
HIGH
這裡我覺得最值得注意的是:
Day 9 的 samples 是 16、20、20。
也就是 sampling 裡其實有一次找到了正確答案。
這個 case 並不是「整個模型分布都非常穩定地相信 20」。
它比較像:
Primary response 非常有自信,但 repeated sampling 已經透露出不穩定。
D9-010 更明顯。
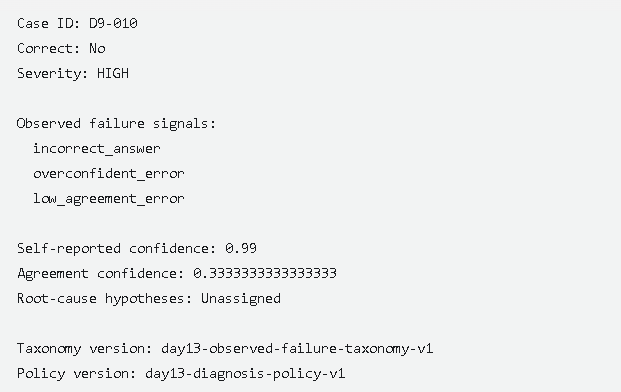
Gold Answer 是 162。
Primary answer 是 480。
Self-reported confidence:
0.99
因此它同樣收到:
incorrect_answer
overconfident_error
但是它的三個 independent samples 當時分別得到:
360、432、480。
三個答案全部不同。
Agreement 只有:
0.3333
低於 low_agreement_error 的 0.50 threshold。
因此 D9-010 最後有三個 signals:
incorrect_answer
overconfident_error
low_agreement_error
Severity 同樣是:
HIGH
為什麼不是 CRITICAL?
因為 CRITICAL 的定義要求:
Incorrect、self-confidence ≥ 0.95,而且 agreement ≥ 0.90。
D9-010 雖然 confidence 很高,但 agreement 非常低。
所以它沒有被硬升成 CRITICAL。
這正是我想要的 deterministic policy 行為。
Severity 不是:
「看起來這題很嚴重,所以我想給它最高級。」
而是:
有沒有真的滿足 policy。
 ---
Day 9 當時我其實滿關心另一種情況:
模型是不是可能很穩定地一直答錯?
例如:
Primary 錯。
三個 samples 也全部得到同一個錯誤答案。
這種 failure 會很麻煩。
因為 repeated sampling 也沒辦法簡單揭露 uncertainty。
所以 Day 13 特別加入:
high_agreement_error
目前 threshold 是:
Incorrect 且 agreement ≥ 0.80。
但是 Day 9 的實際資料裡:
Count = 0。
這點我覺得反而很好。
因為 taxonomy 並沒有為了讓結果「每一類都有資料」就硬把 case 塞進去。
這個 failure signal 現在存在,但目前 REAL evidence 沒看到它。
等未來 benchmark 擴大後,再看它會不會真的出現。
另外十筆答對的 records:
全部 severity 都是:
NONE
沒有任何正確 case 因為 confidence 很高,就被誤貼成 overconfident failure。
這點很重要。
因為 confidence = 1.0 本身不是錯。
如果模型回答正確,而且 confidence 很高,不能只因為數字很大就把它當 reliability failure。
今天的 signals 描述的是:
錯誤發生後,confidence / agreement 呈現什麼行為。
而不是單純懲罰高 confidence。
跑完 12 筆資料後:
Root-cause hypotheses assigned = 0。
D9-009 沒有被自動寫成:
「combinatorics reasoning failure。」
D9-010 也沒有被寫成:
「hallucination。」
因為目前 deterministic evidence 只能告訴我:
它答錯、很有信心,而且 samples 的 agreement 長什麼樣子。
這還不足以證明:
它為什麼錯。
我反而覺得這是 Day 13 最重要的一個設計選擇。
Reliability evaluator 不應該因為想提供更多資訊,就開始自己製造無法驗證的解釋。
有證據的先寫。
沒有證據的就留空。
Day 9 的結論原本是:
Accuracy = 83.33%。
到了 Day 13,我可以把它再拆開。
12 筆裡有:
10 筆正常正確 case。
2 筆錯誤。
而這兩筆錯誤全部具有:
overconfident_error
其中一筆另外具有:
low_agreement_error
沒有任何:
high_agreement_error
也沒有:
insufficient_information_failure
Severity 則全部集中在:
2 個 HIGH。
沒有 CRITICAL。
這仍然只是 12 筆小型 benchmark,不能推廣成整個模型的 failure profile。
但至少下一次 benchmark 擴大後,我不會只得到:
「答對幾題。」
我還能開始回答:
錯誤主要伴隨哪些可觀察的 reliability signals?
今天沒有增加新的模型資料。
沒有新的 API request。
也沒有讓另一個 LLM 幫忙解釋錯誤。
Day 13 做的是:
把既有 REAL Experiment 裡的 failure evidence,轉成 deterministic、versioned、machine-readable diagnosis。
目前完成:
完整測試:
112 passed
Day 9 REAL data:
overconfident_error
low_agreement_error
high_agreement_error
以前 AI Reliability Lab 只知道:
模型答錯了。
Day 13 之後,它開始可以回答:
這個錯誤有哪些真的能從 evidence 觀察到的危險訊號?
而下一步,我真正想做的,就是讓 benchmark 開始產生更多不同型態的 failure。
因為 taxonomy 已經準備好了。
接下來才值得重新擴大 REAL Experiment。


 iThome鐵人賽
 看影片追技術