
Hello, 各位 iT 邦幫忙 的粉絲們大家好~~~
這系列文源自這幾年在團隊裡導入 AI Coding 之後,一路踩雷、修正、再踩雷的真實過程。把這些收斂出來的方法整理成文,也許對正在煩惱同樣問題的你會有些幫助。
就當作是一份邊做邊記的工程筆記吧!
本篇是 當 AI 加入團隊:打造可審查、可驗證、會自我改善的 AI 開發工作流 系列文的 EP15。
隨著 skill 與 knowledge 越長越多,我們遇到一個反直覺的現象。
讓 AI 每次都把整個 repository 讀完,品質反而會下降。 上下文塞太多不相關的規則,AI 越容易把不相干的判斷套用到目前的任務上。
所以我們訂了一套明確的「該讀什麼」流程,用router 驅動,而不是全部載入。
讀之前先選,而不是先讀完再想哪些用得上。
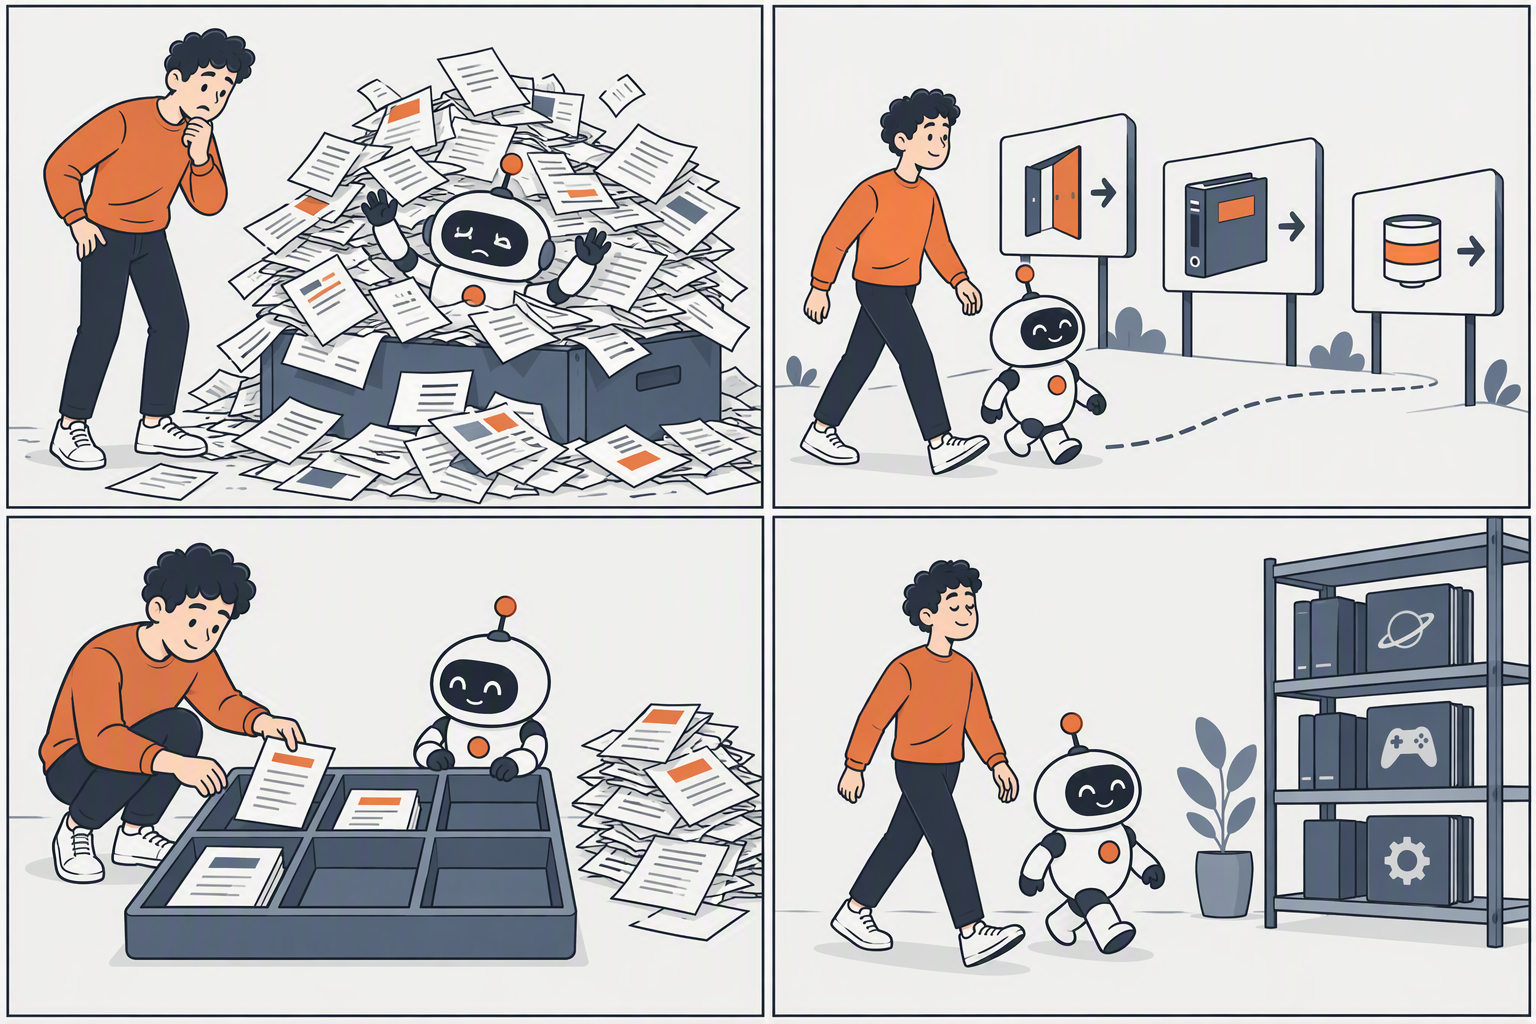
我們甚至幫每一類文件都定了一個「預設載入額度」——不是硬性上限,但超過時要有理由:
| 項目 | 預設額度 |
|---|---|
| 產品入口指標 | 1 份 |
| 共用工具箱根說明 | 1 份 |
| 主要 workflow 或 skill | 1 份 |
| 次要知識文件 | 0~2 份 |
| 團隊記憶查詢結果 | 最多前 5 筆 |
這不是單純的效能最佳化,而是一種風險控制:讀得越精準,AI 把不相干平台的規則、或不相干情境的知識,誤套到目前任務的機率就越低。反過來說,如果任務本身就明確需要更多背景,那就大方地多讀——這裡的重點是「有意識地選擇要讀什麼」,而不是「盡量少讀」。
這加起來其實就一句話:該讀什麼要用 router 有意識地選,不是把整個 repo 塞進上下文。
上下文管好了,接下來一批很扎實的教訓,來自真正在現場跑過的操作。
下一篇來聊聊那些讓我們回頭修改 skill 安全設計的現場回饋。


 iThome鐵人賽
 看影片追技術