
前一篇把 AI 功能的驗證拆成三件事:原本的 Test 確認程式有沒有正常執行;Eval 判斷 AI 有沒有把任務做好;Observability 則負責留下 Production 裡到底發生了什麼。
要把這個 Loop 真的做起來,第一步不是先寫一堆 Grader,而是讓 Production 裡的 AI Interaction 可以一路追到使用者和最後的 Product Outcome。
這篇就直接用 PostHog AI Observability 把這件事接起來。
我們繼續用一個查訂單的客服 Agent 當例子。使用者的目標不是「產生一次 Generation」,而是拿到正確的物流資訊,所以實作前可以先把幾個 Product Event 定下來:
order_tracking_started
tracking_status_viewed
support_ticket_created
tracking_status_viewed 可以當成成功 Outcome,support_ticket_created 則代表使用者最後仍然需要人工協助。
這些 Event 和 AI Event 最好使用同一個 distinct_id。後面我們才有辦法從「哪些使用者沒有成功」一路追到他當時的 AI Session、Trace 和 Generation。
最快的方式是直接執行 Wizard:
npx @posthog/wizard ai-observability
PostHog 目前支援 OpenAI、Anthropic、Vercel AI SDK、OpenRouter、LangChain 等常見 Provider 與 Framework。
如果使用 OpenAI,以 Node.js 為例,可以改用 PostHog 提供的 Wrapper:
import { OpenAI } from '@posthog/ai/openai'
import { PostHog } from 'posthog-node'

const posthog = new PostHog(
    process.env.NEXT_PUBLIC_POSTHOG_KEY!,
    {
        host: process.env.NEXT_PUBLIC_POSTHOG_HOST
    }
)

const openai = new OpenAI({
    apiKey: process.env.OPENAI_API_KEY,
    posthog
})
原本呼叫 OpenAI 的方式幾乎不用改。比較重要的是把這次 Interaction 的 Context 一起帶進去:
const traceId = crypto.randomUUID()

const response = await openai.responses.create({
    model: 'gpt-5-mini',
    input: [
        {
            role: 'user',
            content: '我的訂單現在在哪?'
        }
    ],

    posthogDistinctId: user.id,
    posthogTraceId: traceId,

    posthogProperties: {
        $ai_session_id: conversation.id,
        feature: 'order_tracking',
        prompt_version: 'v3',
        environment: 'production'
    }
})
這裡幾個欄位後面都會用到:
posthogDistinctId:把 AI Event 接回同一個使用者。posthogTraceId:把同一次 AI Interaction 裡的相關操作放在同一條 Trace。$ai_session_id:把多個相關 Trace 分在同一個 Conversation、Thread 或 Workflow。feature、prompt_version:之後比較不同功能或版本時可以直接 Filter。Wrapper 會自動 Capture $ai_generation,包含 Input、Output、Model、Token、Latency、Cost 等資訊。這些同時也是一般的 PostHog Event,所以不需要為 AI 另外建立一套和 Product Analytics 完全分離的資料系統。
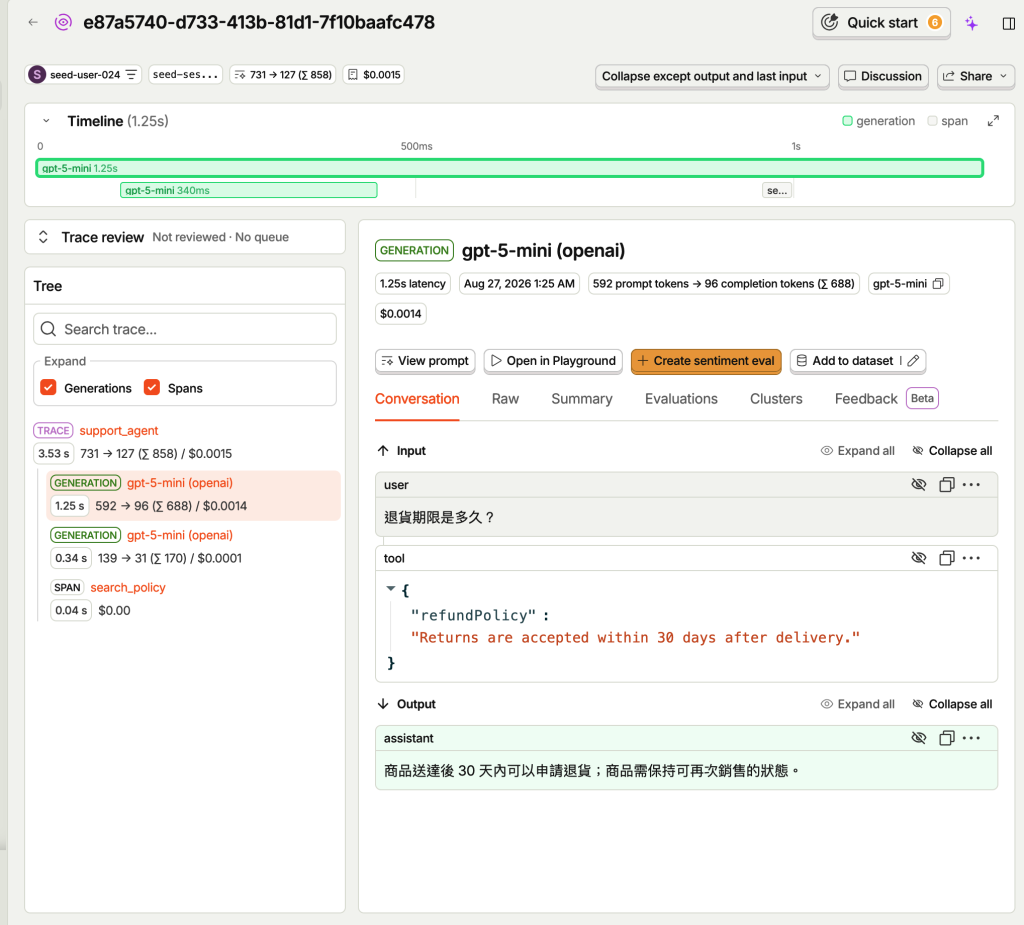
接入 AI Observability 之後,我們會開始取得 Generation Count、Token Usage、Latency 等資料。這些資料可以用來了解 AI 功能的使用量、成本與執行狀況。
如果想知道 AI 是否真的解決了使用者的問題,仍然需要回到前面定義的 Product Outcome。
以查訂單為例,一個使用者可能只產生一次 Generation,就成功看到物流資訊;另一個使用者也可能因為答案不正確而反覆詢問五次,最後仍然建立 Support Ticket。只看 Generation Count,第二種情況的使用量反而更高。
所以如果目標是讓使用者取得物流資訊,可以建立 order_tracking_started → tracking_status_viewed 的 Funnel,觀察開始使用這項功能的使用者,有多少最後真的完成目標。
如果使用者沒有完成 tracking_status_viewed,或者後面又出現 support_ticket_created,就可以再進一步查看當時的 Session、Trace 與 Generation,了解問題發生在哪裡。
如果之後要比較不同 Prompt、Model 或 Experiment Variant,也需要讓這些版本資訊能和最後的 Product Outcome 關聯。否則即使在 $ai_generation 上記錄了 prompt_version,看到 Conversion 發生變化時,仍然很難直接判斷是哪一個版本造成的。
Product Outcome 可以幫助我們找出沒有完成目標的使用者,但還不能說明問題實際發生在哪裡。
以查訂單為例,使用者最後沒有看到物流資訊,可能是 Agent 一開始就理解錯問題,也可能是查詢訂單的 Tool 失敗,或者前幾輪回答都正常,只是在後面的互動才開始出錯。
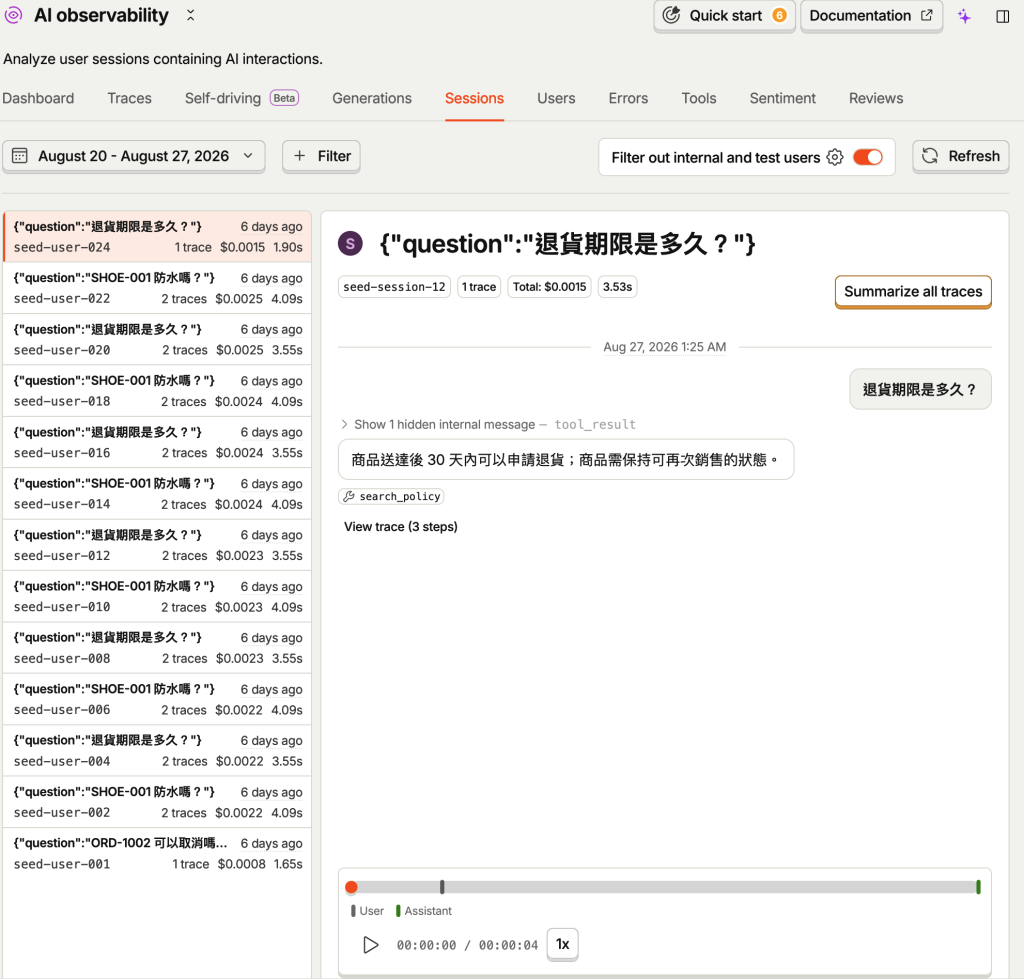
這些狀況需要看的範圍不同。要了解整段互動,可以看 Session;要確認其中一次互動發生了什麼,可以看 Trace;如果問題已經縮小到某一次模型呼叫,則可以再看 Generation。Tool、Retrieval 等中間操作的執行情況,則可以透過 Span 確認。
對聊天或 Agent 類產品來說,一次回答通常不是完整的使用者旅程。
例如,使用者先問「我的訂單在哪?」,接著追問「什麼時候會到?」,最後又說:「你確定嗎?物流頁不是這樣寫。」這幾輪訊息可能分屬不同 Trace,但仍然是同一段 Conversation。
PostHog 的 $ai_session_id 就是用來做這種分組。Session 的定義可以依產品決定,可能是 Conversation、Thread、Workflow,或其他你認為合理的 logical boundary。
如果使用者最後沒有成功,可以先看整個 Session:他問了幾輪、在哪一輪開始重複、總共花了多少 Cost,以及最後是不是轉去人工處理。
Session 特別適合回答「這個使用者整段體驗發生了什麼」,而不是 Debug 某一次 Model Call。
找到可疑的一輪之後,再往下看 Trace。
Trace 會把同一次 AI Interaction 裡相關的 AI Event 放在一起。以「我的訂單現在在哪?」這次 Request 為例,裡面可能包含:
get_order()。get_shipping_status()。Trace 很適合回答:
所以 $ai_trace_id 的價值不是多一個 ID,而是讓後面所有 AI Event 都可以被還原成同一次 Interaction。
如果 Trace 的流程看起來正常,接著就可以打開其中某個 Generation。
Generation 是一次 LLM Call,可以看到:
假設最後回答突然多出「退款期限是 90 天」,可以直接看這次 Generation 收到的 Input 裡到底有沒有這個資訊。
如果 Input 本身就是錯的,問題可能在前面的 Retrieval 或 Tool;如果 Input 沒有,則更可能是 Model 自己產生了不存在的內容。
PostHog 也會從支援的 LLM Response 格式自動擷取 Tool Call,包括 OpenAI、Anthropic、OpenAI Agents SDK、Vercel AI SDK 等,因此不需要為了知道「模型要求呼叫哪個 Tool」再額外建立 Span。
「Model 決定呼叫 get_order」和「get_order() 實際執行成功」是兩件事。
如果想知道 Tool Execution、Vector Search、Retrieval 或其他中間工作實際花多久、輸入輸出是什麼、最後有沒有 Error,可以另外 Capture $ai_span。
例如:
posthog.capture({
    distinctId: user.id,
    event: '$ai_span',
    properties: {
        $ai_trace_id: traceId,
        $ai_session_id: conversation.id,
        $ai_span_id: crypto.randomUUID(),
        $ai_span_name: 'get_order',
        $ai_input_state: { orderId },
        $ai_output_state: result,
        $ai_latency: elapsed
    }
})
這樣 Trace 裡就不只知道 Model 想呼叫哪個 Tool,也能看到 Tool 真正執行的結果。
另外,$ai_session_id 和 Session Replay 使用的 $session_id 是不同概念。前者是我們替 AI Interaction 定義的分組;後者是 PostHog 一般網站 Session。
Production 一多,不可能每個 Session 都人工閱讀。這時可以先利用 Sentiment 找出可能需要注意的對話。
這裡的 Sentiment 指的是使用者訊息呈現出的情緒或態度,不是在判斷 AI 的回答正不正確。PostHog 的 Sentiment classification 會針對使用者送出的訊息分類成 Positive、Neutral 或 Negative。
可以先用很直觀的方式理解:
它不能直接當成 Success Metric。使用者一開始說「我的包裹不見了」本來就可能是 Negative,即使 Agent 最後成功找到包裹;反過來,使用者用很平靜的語氣詢問,也不代表 AI 給出的答案一定正確。
所以 Sentiment 比較適合回答:
哪些對話可能不順利,值得優先打開?
而不是:
這次 AI Interaction 成功了嗎?
除了從行為和 Sentiment 推測,PostHog 也可以透過 Survey Feedback 把 Thumbs up / down 和 Follow-up Question 直接接到 $ai_trace_id。
這樣看到 Thumbs down 時,可以直接回到當次 Trace 看 Input、Output、Tool 和整個執行過程。
Feedback 比 Sentiment 更直接,因為它是使用者自己對這次結果的評價。
它一樣不能取代 Outcome。很多成功的使用者不會按任何按鈕;也有人可能對語氣很好的錯誤答案按下 Thumbs up。
所以比較好的做法仍然是把它當成另一個 Signal,而不是唯一的品質指標。
把這些資料放在一起後,可以依照問題所在的範圍逐步縮小:
這個順序也可以接回前一篇談的 Eval。Production 裡真的發生過的 Failure,在找出原因並修正後,可以再整理成 Eval Task 加入 Regression Suite。等 Prompt、Model 或 Tool 再修改時,就能用 Regression Test 確認同一種錯誤是否再次出現。
AI Observability 還多了一種一般 API Log 很少直接保存的東西:使用者實際問了什麼,以及產品實際回答了什麼。
這些資料本身就有產品價值。Input 可以幫我們發現真實 Use Case;Output 和 Trace 可以找出反覆出現的 Failure,後面也能整理成 Dataset 與 Eval。
同一個特性也代表不能把它當普通 Metadata 處理。使用者可能在 Input 裡貼上 Email、電話、訂單資訊,Context 也可能包含公司內部文件。
如果不需要保存 Prompt 與 Completion,可以使用 PostHog 的 Privacy Mode。在 SDK 呼叫中設定 posthogPrivacyMode: true,就會排除 $ai_input 和 $ai_output_choices。
如果需要保留這些內容來做 Debug、Clustering 或 Eval,就應該依產品自己的資料政策決定哪些資料可以 Capture、哪些要先移除。
到這裡,我們已經能從 Product Outcome 找到沒有成功的使用者,再一路往下追到 Session、Trace、Generation 與 Span。下一篇會繼續處理另一個更現實的問題:即使我們看得到 AI 怎麼失敗,它還是一定會犯錯,產品本身要怎麼把 Failure 控制在可以接受的範圍內?
如果你願意花 30 秒留下回饋,我會用這些意見來調整後續文章:分享你的意見


 iThome鐵人賽
 看影片追技術