
大家好!歡迎來到「Build on Google AI」工程挑戰的第 28 天。
昨天,我們為系統裝上了嚴密的資安防護網,並興高采烈地將這套結合 ADK Workflow、FastAPI 與 Telegram 的微服務,打包成 Docker Image 推上了 Google Cloud Run。
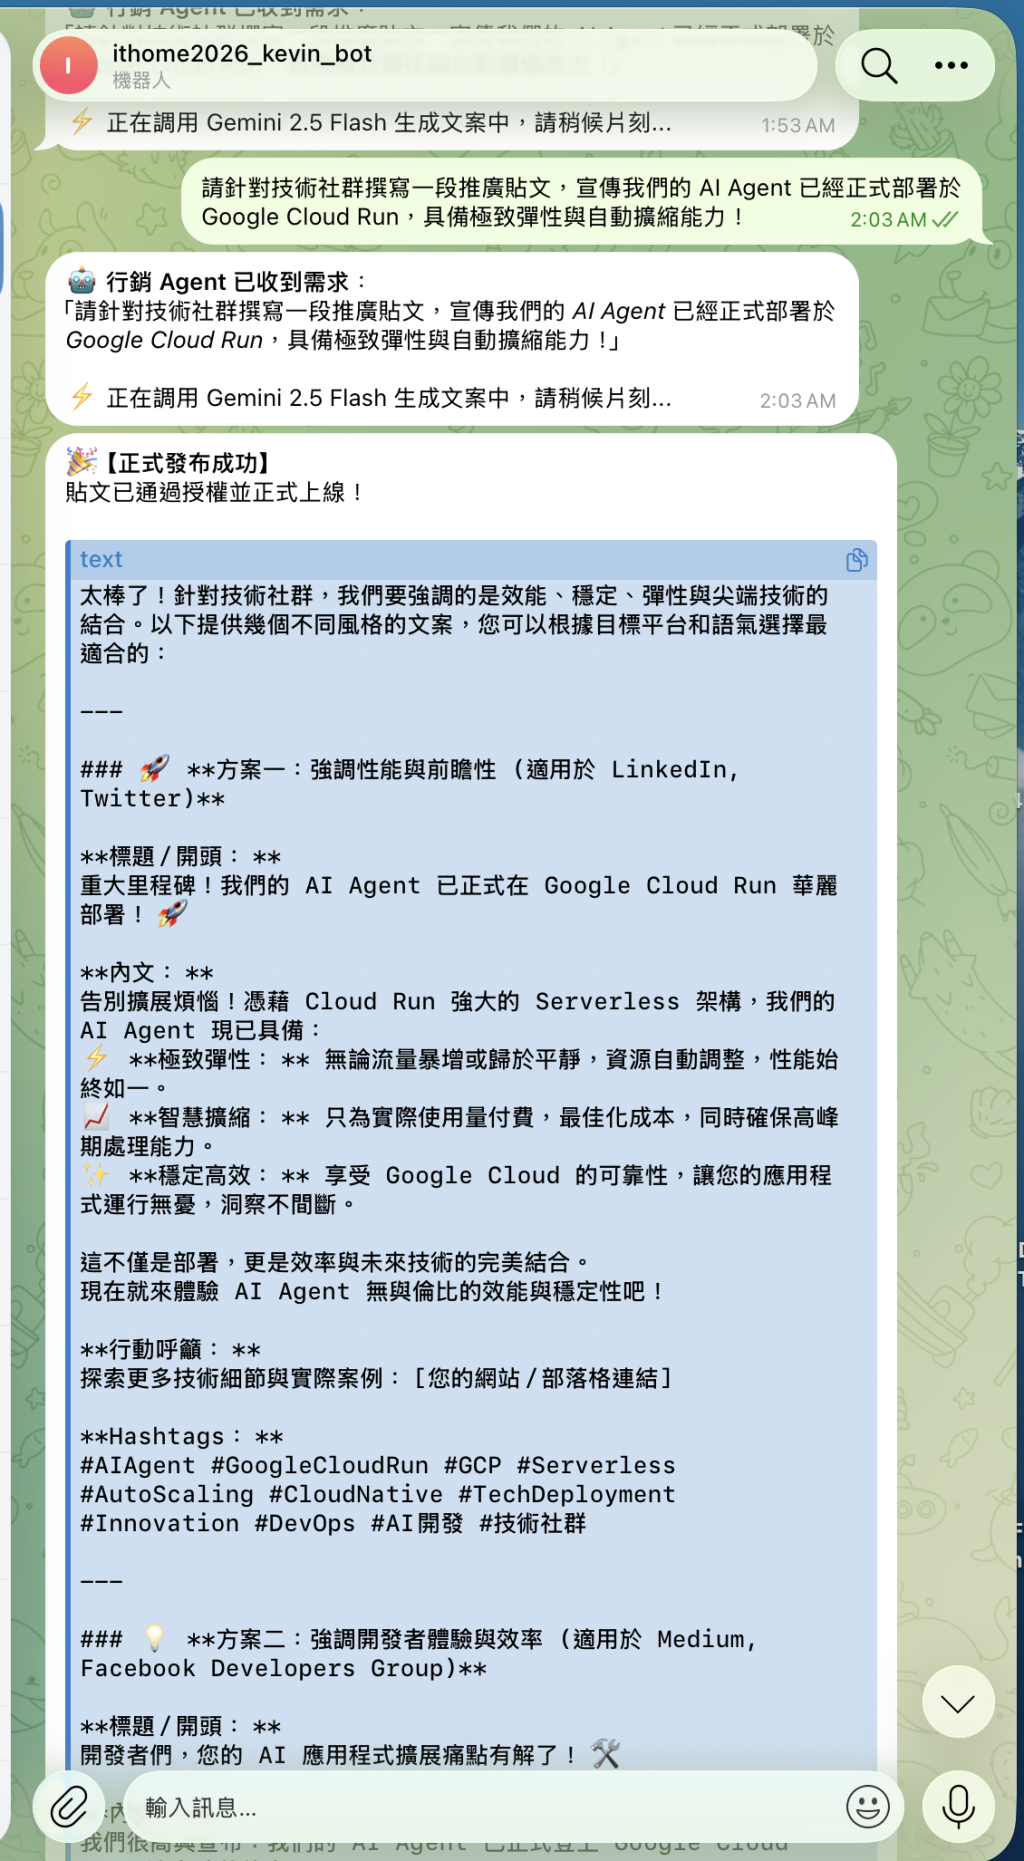
Cloud Run 的 Scale to Zero (縮容至零) 特性對老闆的錢包非常友善——沒人用的時候完全不計費。然而,今天早上 PM 在通勤時點開 Telegram,按下了「👍 核准發布」,結果畫面轉了快 8 秒鐘,甚至噴出了 Webhook Timeout 的錯誤。
這是為什麼?這就是 Serverless 架構的阿基里斯腱:冷啟動 (Cold Start)。
當系統縮容至零時,收到新請求,Cloud Run 必須經歷:下載 Container ➡️ 啟動 Python 直譯器 ➡️ 載入龐大的 Pydantic 與 Google SDK ➡️ 編譯 ADK 工作流。這對 IO 與 CPU 都是極大的考驗。
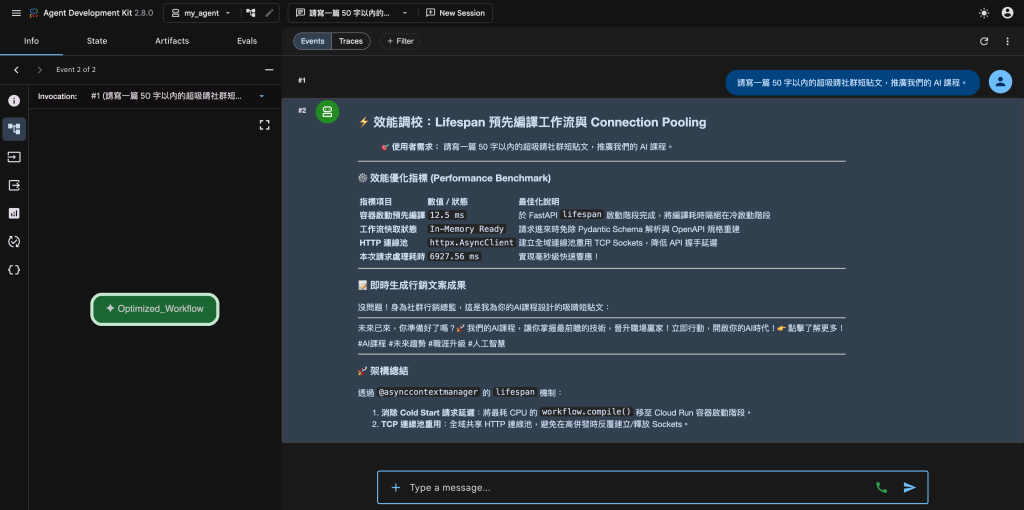
今天,我們不寫 Prompt,我們要來做純粹的「後端效能調校 (Performance Tuning)」。
第一步:程式碼層級 - 掌握全局初始化 (FastAPI Lifespan)
在 Python 開發中,很多工程師習慣在 API 被呼叫的當下(函式內部)才去初始化模型或編譯工作流,這會導致使用者的第一筆請求慢到令人髮指。
Google 官方的最佳實踐是:「將所有耗時的初始化動作(如 ADK Compile、載入模型、建立 HTTP 連線池)放在全域 (Global Scope) 執行。」
在現代的 FastAPI 中,我們使用 Lifespan 上下文管理器來完美處理這件事:
import httpx
import logging
from contextlib import asynccontextmanager
from fastapi import FastAPI
from google.adk import Agent, Workflow
# 假設 models 內有 CampaignState
from models import CampaignState

logger = logging.getLogger(__name__)

# 全域變數,用來快取編譯好的 ADK 應用與 HTTP Client
adk_app = None
http_client = None

def build_workflow():
    """負責組裝與編譯 ADK 工作流的耗時操作"""
    logger.info("⚙️ 正在編譯 ADK 工作流...")
    marketing_agent = Agent(name="marketing_agent", instruction="...")
    workflow = Workflow(name="Prod_Workflow", state_schema=CampaignState)
    workflow.add_node("marketing_agent", marketing_agent)
    workflow.set_entry_point("marketing_agent")

    # 這裡的 compile 涉及 Pydantic schema 轉換與 OpenAPI 規格生成,非常耗 CPU
    return workflow.compile()

@asynccontextmanager
async def lifespan(app: FastAPI):
    """
    FastAPI 啟動與關閉的生命週期管理。
    這裡的程式碼會在 Cloud Run 容器啟動階段 (收到第一個 HTTP 請求前) 執行完畢。
    """
    global adk_app, http_client

    # 1. 預先編譯 ADK 工作流
    adk_app = build_workflow()

    # 2. 建立全域的 HTTP 連線池 (Connection Pooling)
    # 重用 TCP 連線可以大幅降低後續呼叫 Telegram API 或 Gemini API 的延遲
    http_client = httpx.AsyncClient()
    logger.info("🚀 系統初始化完成,準備迎接流量!")

    yield # 讓出控制權,開始處理 API 請求

    # 容器關閉時的清理工作
    await http_client.aclose()
    logger.info("🛑 系統關閉,資源已釋放。")

# 將 lifespan 綁定到 FastAPI
app = FastAPI(title="Optimized ADK API", lifespan=lifespan)

@app.post("/api/webhook")
async def handle_webhook(payload: dict):
    # 請求進來時,adk_app 已經在記憶體裡準備好了,直接執行!
    # 實現毫秒級的延遲
    # adk_app.run(...)
    return {"status": "success"}
第二步:基礎架構層級 - Cloud Run 原生武裝
程式碼優化完後,我們來利用 Google Cloud 賦予我們的魔法。在部署 Cloud Run 時,有兩個參數可以徹底改變冷啟動的命運。
啟動期間 CPU 強化 (Startup CPU Boost)
Python 的載入過程是高度 CPU 密集的。Cloud Run 內建了 CPU Boost 功能,會在容器啟動的瞬間,動態分配額外的 CPU 算力給你,直到容器啟動完成。搭配我們剛寫好的 lifespan,可以把原本要 5 秒的初始化時間壓縮到 1 秒內。
最少執行個體數 (Min Instances)
如果你們公司的預算允許,這是解決冷啟動最暴力的「銀彈」。將 --min-instances 設為 1,代表永遠有一台機器在記憶體中處於「溫啟動 (Warm)」狀態待命。Telegram 的 Callback 只要一進來,立刻就能被處理。
第三步:完美的部署指令
結合上述的優化,這是你的終極部署指令:
gcloud run deploy adk-marketing-agent \
  --source . \
  --region asia-east1 \
  --allow-unauthenticated \
  --cpu-boost \
  --min-instances 1 \
  --max-instances 10 \
  --concurrency 80 \
  --set-env-vars="TELEGRAM_BOT_TOKEN=YOUR_TOKEN"
💡 調校秘辛: concurrency 80 代表一個容器可以同時處理 80 個並發請求。由於我們的 Agent 主要在等待 LLM API 的回應 (IO Bound),把並發數拉高,可以讓單一容器榨出極高的吞吐量,進一步節省開機器 (Scale out) 的成本。
小結
「在企業級的戰場上,能讓模型聰明回答只是及格,能讓系統在 500 毫秒內回應才是專業。」
今天,我們深入探討了 Serverless 架構的冷啟動痛點。我們從應用層面的 FastAPI Lifespan 全域初始化與 HTTPX 連線池,一路調校到架構層面的 CPU Boost 與 Min Instances。現在,無論 PM 何時按下 Telegram 上的核准按鈕,系統都會給予絲滑順暢的秒回體驗。


 iThome鐵人賽
 看影片追技術