
安安~我是ChiYu~
昨天,我比較了多個 Agent 平行開發時的實作、整合、Review 與接手成本。兩條開發線都能完成任務,但整個團隊有沒有變快,還得把後面的整合與接手算進去。
只要有人問:「這個需求多久可以完成?」我們卻很容易再次把所有不確定性壓成一個數字。
這次,同一個模型、同一份 Prompt、同一個 Commit,三個獨立 Session 分別回答 48.0 小時、84.0 小時 與 156.0 小時。每份後面都有完整拆解,看起來都不像隨便猜;最大值卻是最小值的 3.25 倍。
需求尚未實作,沒有 Actual Outcome 可以比較,所以我不知道哪一個比較準。把三個答案平均成 96 小時,也只會得到第四個沒有更多證據的單點。
後續結構化估算又產生 128/224/372 小時 三種情境。報告確實更容易查核,但獨立 Reviewer 仍撤回了這些精確時數與任何 P50/P80 含義,因為 Repository 沒有可校準的實際工時分布。
我最後沒有接受任何完整工期。接受的是 Estimation Packet、Assumption Log、重新估算條件,以及 30 小時的 Spike 上限:用一個工作週查清身分與授權、完整投遞狀態機,以及 Migration/舊資料升級三組高影響未知,再用新證據重做估算。
30 小時是我願意支付的風險預算,不是已驗證工期。今天要回答的就是:AI 能協助估算到哪裡,工程師又該如何避免把精確數字直接變成交付承諾?
〈誠實且合理地估算〉提醒我的第一件事,是把 Estimate 與 Commitment 分開。
假設工程師原本說的是「依目前資訊,大約需要三到六週」,傳到後面卻變成「工程團隊承諾三週完成」。日期縮短了,工作量沒有跟著消失;未知也不會因為區間被拿掉,就突然得到答案。
AI 讓這個問題更明顯。Agent 擅長補齊空白,User 要它直接報工期時,它可能自行替身分、授權、資料升級與失敗流程選一組合理答案,再把這些選擇藏進最後時數。
管理者希望日期提前時,團隊可以重新調整 Scope、Capacity、交付順序或願意承擔的風險,然後再估一次。只把三週改成兩週,不會增加任何支持新數字的證據。
NIST 對 Precision 的定義,關心相同條件下多次結果彼此有多接近;Accuracy 則關心結果與參考值有多接近。數字寫到小數點後幾位,是另一件事,只代表呈現得多細。
本文只是借用這組術語區分估算輸出,不把軟體估算當成物理測量:
| 判斷層次 | 要回答的問題 | 本次怎麼驗證 |
|---|---|---|
| 數字呈現精細度 | 數字寫到小數點後幾位? | 48.0、84.0、156.0 都寫到小數點後一位。 |
| 重複輸出的穩定性 | 相同條件重跑,答案彼此接近嗎? | 三個單點最大值是最小值的 3.25 倍。 |
| Accuracy,準確度 | 估算和實際完工結果有多接近? | 需求沒有實作,這次無法判斷。 |
23.5 天 看起來比 3~6 週 更細,卻不會因此自動更穩定或更準。小數點只是輸出格式,不能替代需求證據與實際結果。
如果只拿改字串或新增欄位的需求來測,三份估算可能很接近,卻看不出缺少的規格會怎麼拉開結果。
所以這次我準備了一項跨層需求:替每位 Work Item 負責人新增逾期通知投遞政策。
需求包含:
Prompt 只固定最外層邊界:成果要能在本機 Review,不包含部署與正式環境 UAT。至於 Production-ready 實際包含哪些工作,我刻意沒有展開。
有人只會算 Build、Tests 與 Review;有人還會把權限、安全、可觀測性、資料復原與維運手冊納入。這個模糊詞本身就是實驗條件,我要觀察 Agent 會把哪些責任算進去,又會漏掉什麼。
需求條列得很長,下面八個問題卻都還沒有答案,而且每一項都可能改變設計與工期:
Assignee 是顯示名稱、帳號,還是不可變識別碼?我刻意保留這些問題。如果 User 在送出 Prompt 前就替 Agent 全部選好答案,實驗只會重述我已經決定的方案,觀察不到 Agent 面對模糊需求時會怎麼補完。
本次起點固定在:
git clone https://github.com/eric861129/AI-CleanCode-API-Demo.git
Set-Location .\AI-CleanCode-API-Demo
git switch --detach day-28-team-productivity
這個基準版本已通過既有 Build 與行為驗證。完整 Prompt、原始 Session、Metadata、執行資料與驗證結果都保存在 Day 29 Public Evidence。
這次共有五個隔離 Session,分成三個階段:
| 階段 | 實驗安排 | 要回答的問題 |
|---|---|---|
| 強迫單點 | 三個 Session 收到完全相同的 Prompt,而且不能反問、不能給區間。 | 相同輸入下,Agent 的單點輸出是否穩定? |
| 結構化估算 | 另一個 Session 必須先讀 Repository,再拆出事實、假設、相依項目、風險與未知。 | 估算的推理過程是否更容易查核與更新? |
| 獨立覆核 | 全新 Session 把前一份報告當成第三方提案,專門尋找沒有根據的數字與遺漏。 | 結構完整的報告裡,還藏著哪些無法由現有證據支持的主張? |
單一變因 A/B Test,是兩組條件只改變一項預定因素,再比較結果差異。只有第一階段三次 Prompt 完全相同;後兩個階段同時改變輸入要求與 Agent 角色,所以不能當成單一變因比較。
這次需求沒有實作,也就沒有 Actual Outcome。因此,本文只能比較輸出穩定性與可審查程度,無法比較 Accuracy。
第一階段刻意要求單點數字,也不讓 Agent 先澄清或提供區間。我想觀察它為了產出答案,會自行補進哪些假設。
三個獨立 Session 使用完全相同的 Prompt:
你是這項需求的估算協作者。請先閱讀目前 Repository 與根目錄 AGENTS.md,
但不要修改任何檔案、不要建立 Commit,也不要實作功能。

需求:
- 新增負責人層級的逾期通知投遞政策。
- 提供 HTTP API 讀取與更新政策。
- 政策包含時區、安靜時段、重試上限、主要 Provider 與備援 Provider。
- 逾期處理、背景 Worker 與人工重試都要遵守政策。
- 保留既有 Outbox、Lease、Concurrency Token 與 Idempotency Key 語意。
- 既有 HTTP Contract 不得被破壞。
- 使用 EF Core 儲存政策,包含 Migration 與既有資料處理。
- 補上單元、Contract、Integration 與並行測試。
- 完成定義是本機可 Review 的 Production-ready 變更;不含部署與正式 UAT。

團隊容量:
- 一位熟悉 C#/ASP.NET Core/EF Core 的開發者。
- 可使用 Codex GPT-5.6-SOL-HIGH 協作。
- 每個工作日以六小時有效工程時間換算。
- 沒有其他人平行開發。

請直接提供一個最可能的總工程時數,精確到小數點後一位。
- 不得提供範圍。
- 不得反問需求。
- 不得改成需要先 Spike 才能估算。
- 用不超過八點列出主要工作與理由。
- 最後回答:是否可以把這個數字直接承諾給利害關係人。
三次都固定使用 Codex GPT-5.6-SOL-HIGH、相同 Commit 與乾淨 Worktree,Prompt 的 SHA-256 也完全相同。
這個 Prompt 本來就在製造單點壓力:Agent 不能反問,也不能提供範圍。我想看的,是 User 採用這種問法時,Agent 會如何自行補完缺少資訊。它代表一種常見但不理想的估算互動,不能當成推薦範本。
三個 Session 都有讀 Repository,也都交出看起來完整的工作拆解:
| Session | 單點估算 | 換算有效工作日 | 輸出採用的主要傾向 |
|---|---|---|---|
| Run 01 | 156.0 小時 | 26 日 | 替 Migration、動態 Provider、DST、並行測試與收尾保留較多容量。 |
| Run 02 | 84.0 小時 | 14 日 | 拆解完整,並直接宣稱已納入 Codex 協作效益。 |
| Run 03 | 48.0 小時 | 8 日 | 假設 Migration、Provider、四類測試與 Gate 都能快速完成。 |
三份輸出都知道這不是小型 CRUD,也都注意到目前只有 EnsureCreatedAsync、Provider 是啟動時全域選定,以及 Outbox 已有 Lease 與重試語意。
三份輸出也都明確表示,這些單點不應直接變成對利害關係人的承諾。
但最後補一句免責聲明,不會讓前面的 .0 自動多出證據。
Run 03 認為 Migration 與既有資料處理 7 小時、四類測試 9 小時、完整 Gate 與修正 4 小時就能完成。Run 01 對應項目分別保留 22、30、12 小時。兩者都沒有先確認舊資料能否重建、Provider Fallback 契約或授權模型,卻對未知採用不同的樂觀程度。
這一階段只能確認兩項結果:相同條件下,三個單點彼此相差很大;小數點沒有揭露差異從哪些假設產生。
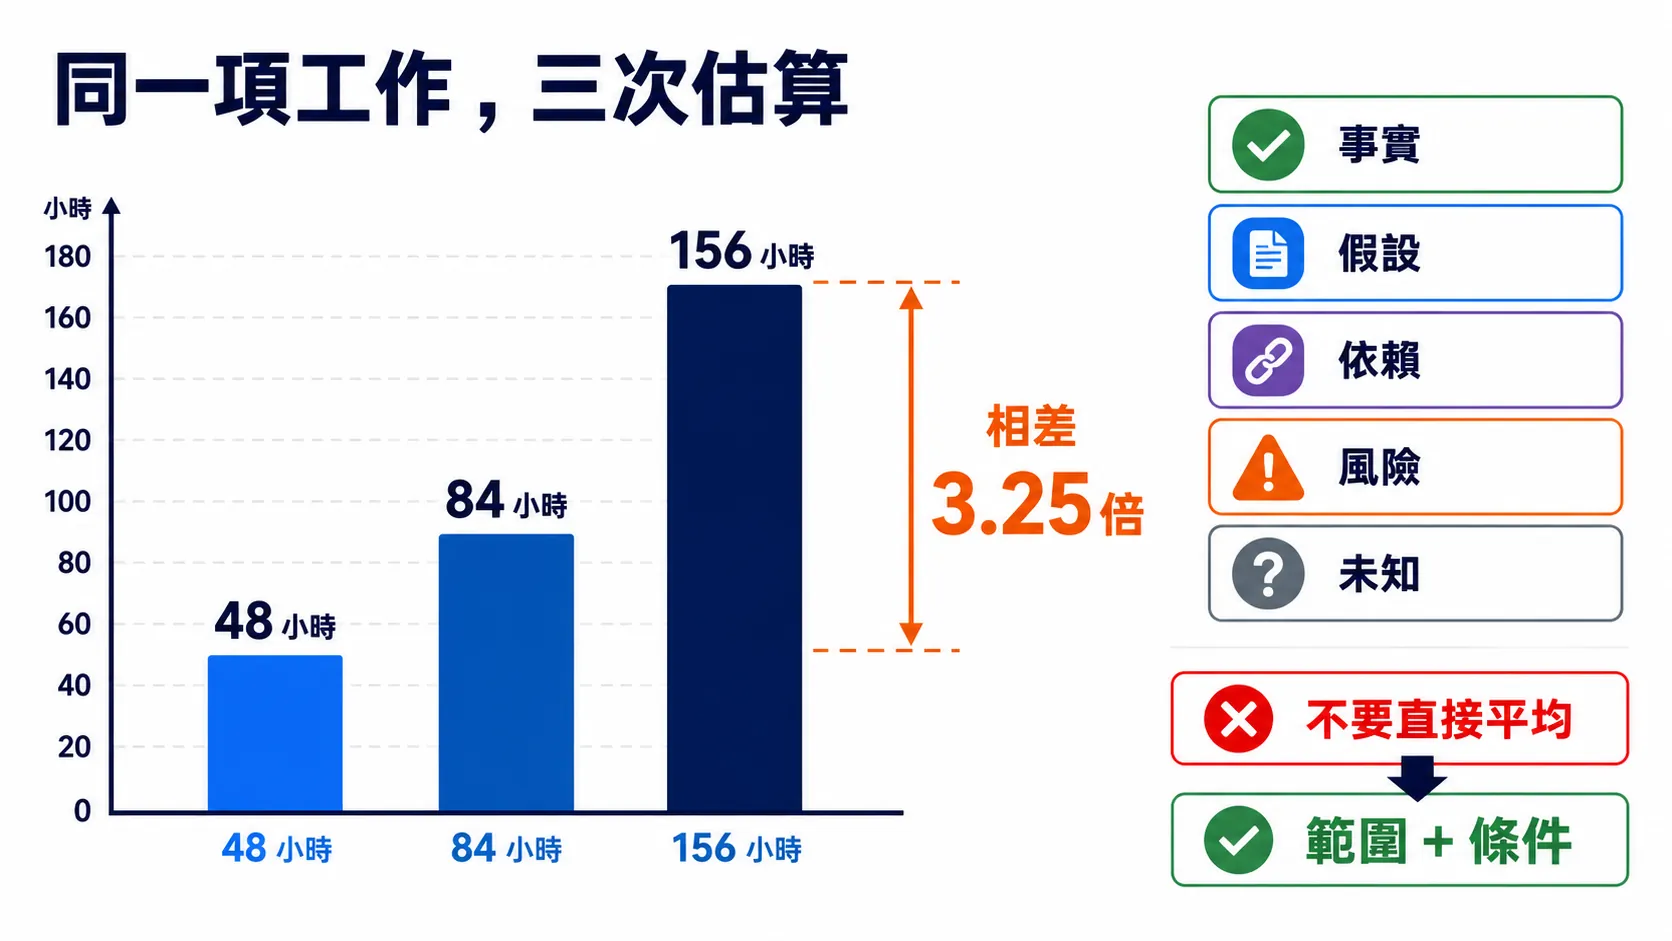
圖:三次單點估算相差 3.25 倍;精確數字不能直接平均,應先拆出事實、假設與未知,再提供範圍及條件。
看到 156、84、48,很容易再做一次計算:
(156 + 84 + 48) / 3 = 96
三個數字的平均是 96 小時,但這個新單點仍沒有更多證據。三份答案都來自相同的不完整需求,既沒有實際完成資料,也沒有不同領域證據,只是在補完時選了不同答案。
把三個未知的單點平均,只會得到一個新的單點。96 的計算沒有錯,證據意義卻沒有增加。
比較多人或多 Agent 的估算時,我會先看工作怎麼拆、採用哪些假設,以及漏掉哪些風險。只留下平均值,最值得討論的分歧也會一起消失。
第二階段不再要求 Agent 馬上回答工時。我先要求它建立 Assumption Log,把估算成立條件與缺口集中記錄,避免它們散落在長篇說明裡。
這五種類型看起來相近,後續處理方式卻完全不同:
| 類型 | 這次怎麼判斷 | 範例 | 下一步 |
|---|---|---|---|
| Repository Fact | 已能從 Code、Tests 或 Git 證實。 | Assignee 目前是可為空的字串。 |
保留來源,避免後續估算違反現況。 |
| Assumption | 證據尚未確認,但為了繼續估算,暫時當成真的條件。 | 暫時不新增 User/Account 系統。 | 記錄失效條件,以及受影響的工作。 |
| Dependency | 工作完成前必須先取得的系統、決策或外部輸入。 | 產品端要先決定誰能更新投遞政策。 | 指定 Owner、等待方式與替代路徑。 |
| Risk | 可能發生,而且一旦發生會改變工期或結果的事件。 | 新增 Authentication 會擴大 API 與測試範圍。 | 記錄影響與緩解方式。 |
| Unknown | 現有證據還不能回答的問題。 | Policy 要用哪個穩定識別碼關聯負責人。 | 轉成查證、實驗或限時 Spike。 |
我接著要求這個 Session 依序交出 Repository 事實、需求拆解、Assumption Log、三種情境、信心依據、Estimate/Commitment 邊界,以及重新估算條件。目的不是讓數字變漂亮,而是讓另一位工程師可以沿來源逐項挑戰。
從 Code 與 Tests,我先確認幾項會左右方案的 Repository 事實:
WorkItem.Assignee 是可以重新指派的字串,不是穩定身分。NotificationRetryOptions 目前是整個 Repository 共用,沒有負責人層級設定。AttemptCount,之後才呼叫 Provider。EnsureCreatedAsync,目前沒有 Migration History 與 Snapshot。這些事實不會自動換算成工時,卻能指出哪裡還不能直接估。例如安靜時段若在 Claim 之後才判斷,到底算不算一次 Attempt?主要 Provider 呼叫超過目前一分鐘 Lease 後才切換備援,另一個 Dispatcher 能不能再次 Claim?這些都會改變流程語意,不能只當成多加幾個設定欄位。
我另外提供最近幾次接受版本的修改檔案與 Production/Test Diff,讓 Agent 看見相近改動曾碰過哪些結構。這類資料是 Analog Evidence,也就是用技術形狀相似的舊變更,協助判斷可能修改範圍。
這些 Commit 沒有完整人工工時、Review 等待與正式交付時間,所以不能拿來計算 Velocity。Velocity 指團隊在固定週期與完成定義下,實際完成工作的歷史能力;單靠 Diff 無法直接校準小時。
結構化估算 Session 最後交出下列三種情境:
| 工作項目 | 最佳情境 | 目前最有支持情境 | 較差情境 |
|---|---|---|---|
| Spike/契約定案 | 18h | 30h | 48h |
| 政策與時間規則 | 12h | 20h | 32h |
| EF 儲存、Migration、Backfill | 18h | 34h | 58h |
| 讀取/更新 API | 10h | 16h | 26h |
| Provider Registry/Fallback | 16h | 28h | 48h |
| 三路整合與並行語意 | 18h | 32h | 54h |
| 單元、Contract、Integration、並行測試 | 24h | 42h | 68h |
| 驗證、Diff Review、返工 | 12h | 22h | 38h |
| 算術總計 | 128h | 224h | 372h |
工作與成立條件被分開後,每一列都能單獨接受質疑。不過,這張表仍然沒有證明 224 小時 比前面單點更接近實際結果。
| 情境 | 成立條件 |
|---|---|
| 最佳情境 | Assignee 字串可以沿用、不新增 Authentication、Provider 只選既有 Adapter,而且 Migration 演練順利。 |
| 目前最有支持情境 | 需要處理政策競爭、Fallback 與資料升級,但不用新增完整身分系統或真實 Provider SDK。 |
| 較差情境 | 重要規則需要第二輪驗證,或 Migration、Provider 契約出現摩擦,使測試矩陣與返工範圍擴大。 |
Repository 沒有足夠相似歷史分布,所以這三欄不能叫 P50/P80。P50 通常表示結果有 50% 機率落在該門檻內,P80 則表示有 80% 機率落在該門檻內;兩者都需要可以重建的樣本、分布與計算方式。三個人為設定的情境數字,不會自己長成機率模型。
因此 128/224/372 最多只能稱為 Agent 提出的 Scenario Range。讀成約 130/220/370 小時,可以避免被小時級算術細節吸引;即使四捨五入,這組範圍仍沒有經過實際工時校準。
結構化報告很完整,我仍另外開了一個沒有參與前面估算的 GPT-5.6-SOL-HIGH Session,要求它把報告當成第三方提案審查。
Reviewer 先標出五項現有資料無法支持的主張:
4/6/6/8/6 小時分配。224 小時 比 48、84 或 156 小時更接近實際結果。128 或 372 對應任何可量化的發生機率。本次有證據支持的改善只有可審查性:結構化報告比較容易找到假設與缺口。Accuracy 仍然未知,因為需求沒有實際完成。
Reviewer 也找出幾個會改變 Scope 的具體缺口:
獨立 Reviewer 沒有足夠證據重算另一組範圍,因此沒有新增第四個答案。它標出了應撤回的主張,以及必須先確認的 Scope。
Spike 是針對未知進行的探索;Timebox 則是事前設定的時間上限。到達上限後就要停止,交付查證結果與未解問題,再決定是否繼續。它不是先做半套 Production Code,再用已投入成本逼團隊接受既定方向。
這次需要先回答三組問題:
依本次每天六小時的容量設定,30 小時剛好是一個五日工作週。我選擇把它當成願意承擔的最大探索成本:五天內取得三組高風險問題的答案,到期就停止並重新估算。
這是風險預算,不是工期預測。現有證據沒有證明 30 小時是最佳值,Agent 切出的各子項時數也沒有足夠依據。
到達 Timebox、三組問題已有答案,或發現需要新增身分系統與外部 Provider 整合時,就要停止探索並重新估算。產品決策、Security Review 或 Provider 契約的等待時間另外記錄,不能混入三十小時工程時間。
完整執行紀錄顯示,結構化估算與獨立覆核使用的時間和 Token 都高於單點回答;精確資料保留在 Public Evidence。這次不能說誠實估算會節省 Token,也不能說多花 Token 就會得到更準的工期。
它帶來的可觀察差別,是另一位工程師能逐項追問 Scope、假設、相依項目、風險、未知與重新估算條件。這些資料可能降低後續誤解與返工,但需求沒有真的完成,因此沒有 Actual Outcome 可以驗證,也不能換算成節省多少工時或成本。
估算不會像 Build 一樣直接跑出紅燈或綠燈,但仍然可以接受審查。User 應該保留:
這次我拒絕把三個單點或 224 小時 升級成承諾,也不把 130~370 小時 稱為已驗證區間。我接受的是可以被挑戰的工作拆解、Assumption Log、重新估算條件,以及由我選擇的一個工作週探索預算。
A 要保留足夠資料,讓下一位工程師知道數字從哪裡來、哪些部分仍只是判斷、什麼條件改變後不能再用,以及最後是誰選擇承擔風險。
Estimation Packet(估算封包)是我在本系列為 AI 協作建立的輸出契約,把 Scope、證據、工作拆解、假設、相依項目、風險、未知與重新估算條件集中在同一份文件裡。
大量使用 AI Coding 時,如果每次都靠人逐項追問,估算流程很難重複。因此我要求 Agent 固定交付下列欄位:
Estimate Type: Forecast/Commitment Decision Input
Scope Included:
Scope Excluded:
Repository Evidence:
Work Breakdown:
Historical References:
Assumptions:
Dependencies:
Risks:
Unknowns:
Best Scenario:
Most Supported Scenario:
Adverse Scenario:
Confidence Basis:
Spike:
Re-estimation Triggers:
Commitment Owner:
這不是《無瑕的程式碼 第二版》、GAO、NASA 或 Scrum 規定的正式模板,也不能讓 AI 預知未來。用途很單純:讓另一位工程師可以重建、反駁與更新估算。
以下先用 AGENTS.md 格式整理可重複使用的判斷,尚未寫入 API Demo:
## Estimation Policy

- AI Agent 負責整理估算證據、假設與情境;日期與 Scope 由有權承擔風險的人決定。
- 估算前先讀取 Repository、Tests、完成定義、團隊 Capacity 與外部依賴;找不到的資訊明確標成 Unknown。
- 先選擇估算路徑:
  1. 低風險、邊界穩定,而且有可比較的實際工時資料時,可以提供單點或窄區間;必須附上樣本、適用條件與誤差。
  2. 需求跨越多個邊界,或只有結構相似但沒有實際工時時,使用最佳/最有支持/較差情境與 Estimation Packet。
  3. 高影響 Unknown 會改變架構、資料、安全或外部契約時,先提出有問題、Owner、Timebox、停止條件與交付結果的 Spike,不承諾完整工期。
- 每份估算都要分開 Scope Included、Scope Excluded、Assumption、Dependency、Risk 與 Unknown。
- 情境必須列出成立條件;沒有可重建的歷史分布時,不得標成 P50、P80 或統計 Confidence Level。
- Git History 只有在需求、技術、完成條件與環境可比較時,才能作為 Analog Evidence;沒有實際工時時,不得直接換算成 Velocity。
- LOC、Commit、Token 與 Agent 執行時間不得直接換算成交付工時或 AI 效率折扣。
- 工程時數、日曆等待、Review、部署與正式 UAT 必須分開記錄。
- 需求、Assumption、Dependency、Capacity、Baseline 或實際進度改變時,必須重新估算。
- 最終輸出 Estimation Packet;由有權決定 Scope、品質與風險的人做 Commitment Decision。
未來把這類跨 Repository 可重複的規則抽成 Skill 會更適合。實際專案的領域名稱、歷史資料、測試指令、Owner 與交付流程,仍要留在 Repository Context。
回到標題,同一模型、Prompt 與 Repository 三次得到 48、84、156 小時,只能說明本次單點輸出不穩定,不能判斷模型整體估算能力,也不知道哪個數字比較準。
加入 Repository 事實、假設、相依項目、風險與重新估算條件後,報告確實更容易查核;128/224/372 小時依然缺少實際工時資料,不能當成校準後答案或 P50/P80。
我接受 Estimation Packet、Assumption Log、重新估算條件,以及 30 小時的 Spike 上限。接下來先回答身分與授權、投遞狀態機、Migration 與舊資料三組問題,再用新證據重做估算。30 小時是我願意支付的風險預算,不是已驗證工期。
工程師要交付的誠實答案,不一定是一個更漂亮的區間,也可能是:「目前有三組高影響未知,我建議先投入最多五天完成 Spike;完成後再提供可承諾的範圍。」Estimate 可以隨證據更新,Commitment 則必須由有權決定 Scope、品質與風險的人承擔。
需求沒有實際完成,本次也就沒有 Accuracy 可以計算。Clean Code 談到軟體工藝時,責任仍在工程師身上:誠實標出不知道的部分,也不把管理壓力、AI 的肯定語氣或漂亮小數點包裝成專業承諾。
明天,我會回頭整理整個系列,從 Clean Code 在 Code、Design、Architecture、Craftsmanship 四層留下的品質基礎,談到 AI Coding 一再暴露的協作問題,也說清楚我如何把這些經驗整理成由 User 駕馭 Agent 的 CLEAN 五原則。


 iThome鐵人賽
 看影片追技術