
上一篇用陣列和鏈結把二元樹建立起來了,但要怎麼確定 A 的左邊真的接到 B、B 的右邊真的接到 D,而沒有接錯位置?最直接的檢查方法,就是從根節點出發,把樹裡的每個節點都拜訪一次、把資料依序印出來,再和心中預期的樹比對。
這種「依照固定規則,把樹中每個節點都拜訪恰好一次」的動作,稱為走訪(traversal)。走訪本身不會改變樹的連結方式,只決定節點被處理的先後次序。
站在二元樹的任何一個節點上,要做的事只有三件:
| 代號 | 動作 |
|---|---|
| L | 走訪左子樹(Left) |
| D | 處理目前這個節點的資料(Data) |
| R | 走訪右子樹(Right) |
這裡的 D 指的是「目前所在的節點」,也就是這棵子樹的根節點,不只是整棵樹最上方的根節點。「處理」可以是印出資料、加總數值或其他動作;本篇用印出資料當作例子。
L、D、R 三件事排列起來共有 3! = 6 種順序。不過一般習慣約定先左後右,也就是 L 一定排在 R 前面,於是只剩下三種:
| 順序 | 名稱 | D 的位置 |
|---|---|---|
| DLR | 前序走訪(preorder) | 最前面 |
| LDR | 中序走訪(inorder) | 中間 |
| LRD | 後序走訪(postorder) | 最後面 |
三種走訪的名稱,就是依照「處理目前節點(D)」排在第幾個來命名的。
接下來三種走訪都用同一棵樹示範,方便比較結果:
        A
       / \
      B   C
     / \   \
    D   E   F
A、B 有兩個子節點;C 只有右子節點,左子節點的位置是空的;D、E、F 是葉節點。
走訪的關鍵在於:走到左子樹或右子樹時,要在那棵子樹裡重新套用同一套規則。例如前序走訪進入 B 的子樹後,B 就成了這棵子樹的根,同樣要照 DLR 的順序處理 B、D、E。遇到空的子樹時沒有節點可以處理,直接返回上一層。這種「用相同方法處理規模較小的同類問題」的做法,稱為遞迴(recursion),後面的程式碼也會直接用遞迴寫出來。
前序走訪的規則是:先處理目前節點,再走訪左子樹,最後走訪右子樹。下面每往右縮排一層,就代表進入下一層子樹:
        A
       / \
      B   C
     / \   \
    D   E   F
進入 A → 印出 A → 走左子樹 B
  進入 B → 印出 B → 走左子樹 D
    進入 D → 印出 D → 左、右都是空的 → 返回 B
  回到 B → 走右子樹 E
    進入 E → 印出 E → 左、右都是空的 → 返回 B
  B 的子樹完成 → 返回 A
回到 A → 走右子樹 C
  進入 C → 印出 C → 左邊是空的 → 走右子樹 F
    進入 F → 印出 F → 左、右都是空的 → 返回 C
  C 的子樹完成 → 返回 A
結果是 A B D E C F。前序走訪一進入節點就先處理它,所以根節點 A 一定是第一個。
中序走訪的規則是:先走訪左子樹,再處理目前節點,最後走訪右子樹。進入一個節點時先不要急著印出,要等它的左子樹全部走完:
        A
       / \
      B   C
     / \   \
    D   E   F
進入 A → 先走左子樹 B
  進入 B → 先走左子樹 D
    進入 D → 左邊是空的 → 印出 D → 右邊是空的 → 返回 B
  回到 B → 印出 B → 走右子樹 E
    進入 E → 左邊是空的 → 印出 E → 右邊是空的 → 返回 B
  B 的子樹完成 → 返回 A
回到 A → 印出 A → 走右子樹 C
  進入 C → 左邊是空的 → 印出 C → 走右子樹 F
    進入 F → 左邊是空的 → 印出 F → 右邊是空的 → 返回 C
  C 的子樹完成 → 返回 A
結果是 D B E A C F。根節點 A 出現在中間,A 左邊的 D、B、E 都屬於左子樹,右邊的 C、F 都屬於右子樹。
後序走訪的規則是:先走訪左子樹,再走訪右子樹,最後才處理目前節點。一個節點要等左右子樹都走完才會被印出:
        A
       / \
      B   C
     / \   \
    D   E   F
進入 A → 先走左子樹 B
  進入 B → 先走左子樹 D
    進入 D → 左、右都是空的 → 印出 D → 返回 B
  回到 B → 走右子樹 E
    進入 E → 左、右都是空的 → 印出 E → 返回 B
  回到 B → 左右子樹都完成 → 印出 B → 返回 A
回到 A → 走右子樹 C
  進入 C → 左邊是空的 → 走右子樹 F
    進入 F → 左、右都是空的 → 印出 F → 返回 C
  回到 C → 左右子樹都完成 → 印出 C → 返回 A
回到 A → 左右子樹都完成 → 印出 A
結果是 D E B F C A。和前序正好相對:前序的根節點排在第一個,後序的根節點 A 則一定是最後一個。
三種走訪的次序整理在同一張圖中,節點旁的數字表示它被印出的次序:
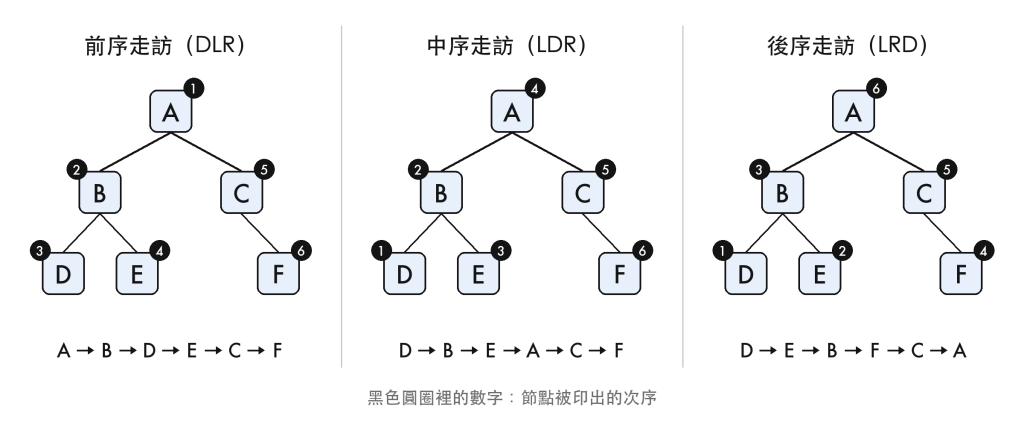
沿用 Day 14 的鏈結表示法,每個節點有 left、data、right 三個欄位。三個走訪函式的結構幾乎一樣,差別只在 printf 放在兩次遞迴呼叫的前面、中間還是後面:
#include <stdio.h>
#include <stdlib.h>

// 每個節點存一筆資料,left、right 分別指向左、右子節點;沒有子節點時為 NULL。
typedef struct TreeNode {
    char data;
    struct TreeNode *left;
    struct TreeNode *right;
} TreeNode;

// 配置並初始化一個新節點;配置失敗時結束程式。
static TreeNode *createNode(char value) {
    TreeNode *newNode = malloc(sizeof *newNode);

    if (newNode == NULL) {
        fprintf(stderr, "記憶體配置失敗\n");
        exit(EXIT_FAILURE);
    }

    newNode->data = value;
    newNode->left = NULL;
    newNode->right = NULL;
    return newNode;
}

// 前序走訪:D → L → R
static void preorder(const TreeNode *node) {
    if (node == NULL) {
        return;  // 空的子樹,沒有節點可處理。
    }

    printf("%c ", node->data);  // D
    preorder(node->left);       // L
    preorder(node->right);      // R
}

// 中序走訪:L → D → R
static void inorder(const TreeNode *node) {
    if (node == NULL) {
        return;
    }

    inorder(node->left);        // L
    printf("%c ", node->data);  // D
    inorder(node->right);       // R
}

// 後序走訪:L → R → D
static void postorder(const TreeNode *node) {
    if (node == NULL) {
        return;
    }

    postorder(node->left);      // L
    postorder(node->right);     // R
    printf("%c ", node->data);  // D
}

// 用後序走訪釋放整棵樹:子樹都釋放完,才釋放目前節點。
static void freeTree(TreeNode *node) {
    if (node == NULL) {
        return;
    }

    freeTree(node->left);
    freeTree(node->right);
    free(node);
}

int main(void) {
    TreeNode *root = createNode('A');
    root->left = createNode('B');
    root->right = createNode('C');
    root->left->left = createNode('D');
    root->left->right = createNode('E');
    root->right->right = createNode('F');

    printf("前序:");
    preorder(root);
    printf("\n中序:");
    inorder(root);
    printf("\n後序:");
    postorder(root);
    printf("\n");

    freeTree(root);
    return 0;
}
執行結果:
前序:A B D E C F
中序:D B E A C F
後序:D E B F C A
程式的執行過程和前面的追蹤完全對應:
main 依照範例樹建立六個節點,再用 left、right 把它們接起來。node == NULL。遇到空的子樹就直接 return,這是遞迴停止的條件;少了它,程式會試著透過 NULL 讀取 data、left 等欄位,通常會直接當掉。preorder(node->left) 會把左子節點當成新子樹的根,再做一次完整的前序走訪;等那棵子樹全部走完,才回到原本的函式繼續執行下一行。freeTree 也是一種後序走訪。節點必須等左右子樹都釋放後才能釋放;若先釋放目前節點,就無法再透過它的 left、right 找到子節點。設 n 是樹中的節點數。三種走訪都會讓每個節點被處理一次,而每個節點只做固定數量的工作(檢查、印出、兩次遞迴呼叫),所以時間複雜度都是 O(n)。
除了樹本身,遞迴呼叫還需要額外空間記住「走完子樹後要回到哪裡」。每往下走一層,就多一個還沒結束的函式呼叫,這些呼叫最多疊到和樹的高度 h 差不多,所以額外空間是 O(h)。樹形平均時 h 比 n 小很多;但如果是 Day 14 提到的傾斜樹,h 會等於 n,額外空間就變成 O(n)。
開頭提到可以把樹走一遍來檢查建立結果,但只看一種走訪結果,通常無法確定樹的形狀。例如下面兩棵樹:
左邊的樹        右邊的樹
    A               A
   /                 \
  B                   B
兩棵樹的前序走訪都是 A B,只看前序結果分不出 B 在左邊還是右邊;中序走訪則分別是 B A 和 A B,可以分辨。實務上檢查時,可以同時比對前序和中序的結果:只要節點資料彼此不重複,前序加中序就能唯一決定一棵二元樹。
走訪就是依照固定規則,把二元樹中的每個節點都拜訪一次。前序、中序、後序的差別只在「什麼時候處理目前節點」,而這個時機正好決定它們適合做什麼事。前序先處理父節點,適合「先有上層,才能處理下層」的工作,例如複製一棵樹時要先建好父節點,才能把子節點接上去;列出資料夾結構時,也是先印資料夾名稱,再印裡面的內容。中序照著「左、根、右」的位置輸出,之後學到左小右大的二元搜尋樹時,用中序走訪就能由小到大印出資料;下一篇的二元運算樹,也能用中序走訪寫回平常習慣的算式(需要時再補上括號)。後序等左右子樹都處理完才處理父節點,適合「先知道下層結果,才能決定上層」的工作,例如本篇的 freeTree 要先釋放子節點,計算資料夾總大小也要先算出每個子資料夾的大小。當然,把樹走一遍、印出結果,也是檢查樹有沒有建對最直接的方法。
今日重點:
下一篇會把今天的走訪反過來用:看看如何從「前序加中序」或「中序加後序」的結果,還原出唯一的一棵二元樹,並認識用二元樹表示算式的二元運算樹。


 iThome鐵人賽
 看影片追技術