
前三個回答品質指標,看的都是單輪問答。但使用者不會只問一句話就走,尤其是客服機器人、HR 助理這類系統,對話中很容易出現「跑題」的狀況。今天是回答品質的最後一個指標:Topic Adherence(主題連貫性)。
Topic Adherence 評估的是,在多輪對話中,AI 有沒有守在預先定義好的主題範圍內。它同時關心兩件事:不該回答的主題,有沒有亂答;該回答的主題,有沒有漏答。假設我們做了一個 HR 助理,設定的主題範圍是「請假規定、加班規定、薪資計算」,這組主題就是參考主題(Reference Topics)。一段對話裡,使用者先問了特休怎麼申請,接著突然問「今天午餐吃什麼」,最後又問加班費怎麼算。
計算的做法是抽主題、比對、再看有沒有回答。首先請 LLM 從整段對話中,抽取出討論過的主題,接著把每個主題和參考主題比對,判斷它是「主題內」還是「主題外」,最後檢查 AI 對這個主題有沒有實際回答。結果一樣分成三類:主題內而且 AI 有回答,算 TP;主題外但 AI 還是回答了,也就是該拒答卻沒拒答,算 FP;主題內但 AI 沒有回答,也就是該答卻沒答,算 FN。最後再計算 Precision 與 Recall,通常用 F1 作為最終分數。
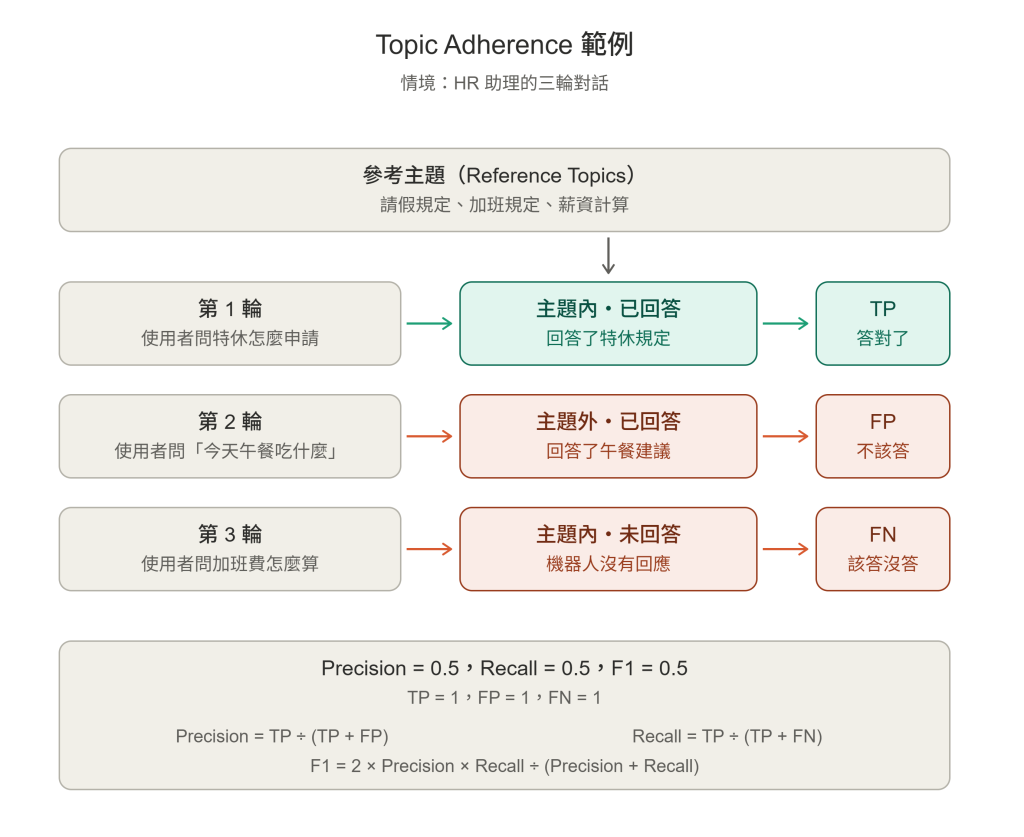
以上面的對話為例,特休是主題內且有回答,算 TP;午餐是主題外卻被回答,算 FP;加班費是主題內卻沒有回應,算 FN。Precision = 0.5、Recall = 0.5,F1 = 0.5。這個結構和 Day12、Day13 的 Precision 與 Recall 很像,Precision 看有沒有亂答,Recall 看有沒有漏答,一個管「不該答的別答」,一個管「該答的要答」。
有一點要特別留意,Topic Adherence 只看主題範圍,不看回答內容對不對。機器人針對特休給了錯誤的天數,只要這個主題在範圍內、也有回答,它就算 TP;至於答得對不對,是 Factual Correctness 要處理的事。另外,它是整段對話層級的評測,需要完整的對話紀錄,跟前面單輪問答的指標不同。
當分數偏低時,要先分辨是 Precision 還是 Recall 出了問題。Precision 偏低,通常是 System Prompt 沒有定義主題邊界與拒答策略,或缺少 Guardrail,使用者一閒聊,模型就跟著聊;Recall 偏低,則可能是模型過度保守,連主題內的問題也拒答,或是主題範圍寫得太窄。另外,使用者一直換話題,也可能把模型帶偏,讓它忘記自己的角色。
到這裡,回答品質的四個指標就都介紹完了:Answer Relevancy(答案相關性)看回答有沒有對準問題,Faithfulness(忠實度)看回答有沒有超出 Context,Factual Correctness(事實正確性)看回答有沒有和標準答案吻合,Topic Adherence(主題連貫性)則看多輪對話有沒有守住主題。不過這四個指標各自對照的對象不同,分數偏低時要檢查的環節也不一樣。下一篇,我們就把這四個指標整合起來,看它們怎麼搭配使用,以及回答不理想的時候,該從哪裡開始找問題。


 iThome鐵人賽
 看影片追技術