
Day18 的 Faithfulness 檢查回答有沒有超出 Context,但它有一個盲點,如果 Context 本身是錯的,模型忠實照抄,分數依然很高。今天要看的 Factual Correctness(事實正確性),就是直接拿回答去跟標準答案比。
Factual Correctness 衡量的是,模型的回答,在事實上和參考答案(Reference)吻合到什麼程度。注意它需要事先準備好標準答案,這一點和前面幾個指標不太一樣。假設「特休一天需要提前幾天申請?」的標準答案包含三項事實:提前 3 天向主管申請、核准後才可休假、緊急時可事後補單。模型的回答是:「特休需提前 3 天向主管申請,核准後才能休假,另外可以隨時取消。」這個回答對了兩項,漏了一項,還多說了一項標準答案裡沒有的內容。Factual Correctness 要量化的,就是這種「講對多少、講錯多少、漏掉多少」。
這個指標的做法是雙向拆解、逐項比對。它會先把模型回答與標準答案,各自拆成獨立的陳述(claim),再用 NLI(Natural Language Inference,自然語言推論)判斷,回答的每個 claim 有沒有被標準答案支持,標準答案的每個 claim 有沒有出現在回答裡。比對完之後,結果會分成三類:回答有說、標準答案也有的事實算 TP;回答有說,但標準答案沒有(或與之矛盾)的內容算 FP;標準答案有,但回答漏掉的事實算 FN。最後依這三類計算 Precision 與 Recall,預設用兩者的 F1 分數。
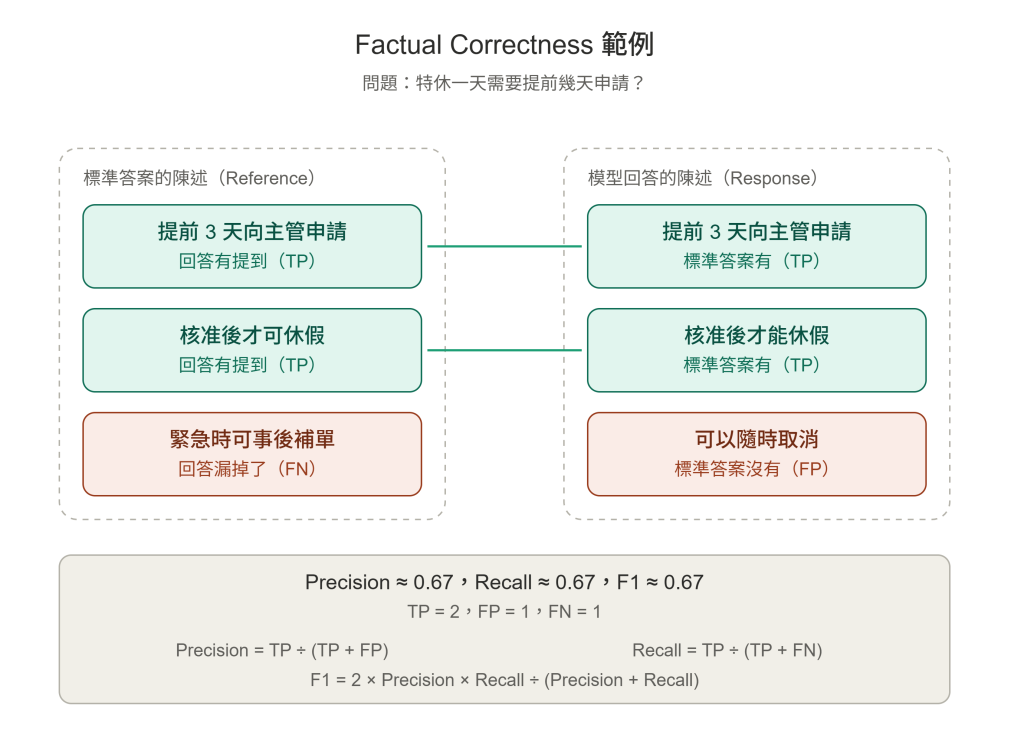
以上面的例子來看,TP = 2、FP = 1、FN = 1,Precision ≈ 0.67、Recall ≈ 0.67,F1 也約 0.67。Precision 偏低代表「講了不該講的」,Recall 偏低代表「該講的沒講全」,可以依需求切換成只看其中一種。
Factual Correctness 和 Faithfulness 很容易混在一起,因為兩個指標都會把回答拆成 claim。差別在於「拿什麼來對照」,Faithfulness 對照的是檢索到的 Context,不需要標準答案,主要抓亂加內容與幻覺;Factual Correctness 對照的是標準答案,需要事先準備,主要抓講錯與漏講。實務上兩者要搭配使用,Faithfulness 高但 Factual Correctness 低,可能代表模型很老實,但拿到的資料本身有問題或不完整;反過來,Faithfulness 低但 Factual Correctness 高,可能是模型憑自己的知識蒙對了,這樣的答案在企業情境裡並不穩定。
當分數偏低時,可以檢查的方向有幾個,檢索是否漏掉了關鍵資訊,這時可以回頭看 Context Recall 與 Context Entities Recall;模型是否產生幻覺、自行捏造細節;知識庫的內容是不是過時或本身有誤。還有一點最容易被忽略,就是標準答案本身也可能不完整或已經過期,這也是使用這個指標的隱藏成本,標準答案需要有人維護。
到目前為止,三個回答品質指標,都是在看單一輪的問答。但真實的使用情境往往是多輪對話,使用者可能問到一半就開始閒聊。下一篇,我們來看最後一個指標 Topic Adherence(主題連貫性)。


 iThome鐵人賽
 看影片追技術