
Day 15:併發限制,用 Semaphore 保護下游別被打爆 結尾留下一個問題:Semaphore 確實能保護下游資源不被瞬間打爆,但如果同時湧入的請求量遠遠超過允許通過的數量,排隊等候的協程可能要等上相當長一段時間,如果使用者早就等得不耐煩放棄了,這個還在排隊或執行中的協程該怎麼處理?今天要正式回答這個問題。
先把 Day 15 的疑問收個尾。排隊等候 Semaphore 名額的協程如果等太久,某種程度上還算是個「幸福的煩惱」,因為它至少知道自己在排隊,也知道前面卡著多少人。
真正麻煩的情況是另一種。
不只是排隊等候會等太久,任何一次呼叫,查詢資料庫、呼叫外部服務,都有可能因為對方異常而遲遲沒有回應。這種情況下,協程不是在排隊,它已經被放行、正在執行,卻卡在某個等待點上動彈不得。
如果沒有任何機制主動介入,這個協程可能無限期地等下去,持續佔用資源,沒有人會主動來告訴它「該放棄了」。
用示範情境把這件事具體化。
假設確認庫存的內部服務因為某種異常,遲遲沒有回應,如果沒有逾時機制,等待這個回應的協程會一直卡在那裡。
即使 Day 15 的 Semaphore 已經限制了同時執行的數量,這個卡住的協程也持續佔用著一個寶貴的名額,排隊等候的其他協程因此被拖得更久,形成連鎖效應。原本 Semaphore 設計來保護下游的機制,反而因為一個卡住的協程而讓整體吞吐量雪崩式下滑。
更值得留意的是對使用者體驗的影響。
如果使用者已經因為等太久而放棄或重試,這個仍在背景執行的協程其實已經沒有意義,卻還在消耗資源,這是一種浪費。Day 06:Structured Concurrency,為什麼協程不能亂長亂放 提過協程洩漏的概念,一個沒有被適時終止的協程,本質上就是一種資源洩漏。
差別只在於,Day 6 談的洩漏是「父範圍沒有機制去約束子協程」,今天談的是即使結構完整,協程本身也可能因為外部依賴異常而卡住不放,兩者是同一種代價在不同成因下的重複上演。
因應這種場景,Kotlin 協程提供 withTimeout 這個機制,可以為一段協程程式碼設定執行時間上限。如果超過這個時間仍未完成,協程會被主動取消,並拋出對應的例外通知呼叫端逾時已發生。
回到示範情境,把呼叫確認庫存內部服務的程式碼包裹在 withTimeout 裡,設定一個合理的秒數上限。如果這次呼叫在時間內完成,就正常回傳結果;如果超過時間仍未完成,就主動放棄這次等待,讓協程結束,並讓上層邏輯決定如何處理逾時,例如回應使用者稍後再試。
class StockService(
    private val stockClient: StockClient,
) {
    private val stockCallSemaphore = Semaphore(permits = 20)

    suspend fun checkStockAvailability(orderId: String): StockResult {
        return stockCallSemaphore.withPermit {
            try {
                withTimeout(2_000) {
                    stockClient.checkStock(orderId)
                }
            } catch (e: TimeoutCancellationException) {
                StockResult.Unavailable(reason = "查詢庫存逾時,請稍後再試")
            }
        }
    }
}
withTimeout(2_000) 設定了兩秒的執行時間上限,包住呼叫下游服務的那段邏輯。如果 stockClient.checkStock 在兩秒內回應,withTimeout 就直接回傳結果,程式碼幾乎感覺不到它的存在。如果兩秒內沒有回應,withTimeout 會主動取消這段執行中的程式碼,並拋出 TimeoutCancellationException,外層的 try-catch 接住這個例外後,回傳一個明確的「暫時無法確認庫存」結果,而不是讓呼叫端跟著一起無限期等下去。
這裡值得停下來想一下,逾時時間該設多長。這是一個需要依據實際情境權衡的設計決策,過短可能把正常但稍慢的回應誤判為逾時,過長則失去主動介入的意義,具體數值沒有放諸四海皆準的答案,這裡不展開建議,只點出這是設計時必須認真面對的取捨。
withTimeout 觸發的取消,不是一個憑空冒出來的獨立機制,它走的正是 Day 06:Structured Concurrency,為什麼協程不能亂長亂放 定案的規則三,取消與例外沿結構傳播。當 withTimeout 判定逾時、觸發取消時,這個取消訊號會沿著這個協程與其底下所有子協程的父子結構往下傳播。如果這個逾時的協程內部還有其他正在進行的子操作,這些子操作也會一併被要求結束,不會出現只有最外層被標記逾時、內部子操作卻渾然不覺地繼續執行的狀況。
Day 08:Coroutine Context 與例外處理,協程出錯了誰負責 補上了這件事在實作層面的樣貌,取消訊號能夠沿結構傳播,靠的是每個協程對應的 Job 記錄著自己的執行狀態與父子關聯。withTimeout 判定逾時時,本質上是把對應的 Job 標記為取消狀態,這與 Day 8 建立的「Job 記錄協程執行狀態」機制是同一套底層邏輯的延伸應用。withTimeout 只是提供了一個方便的語法,讓開發者不需要手動操作 Job,就能觸發這整套取消機制。
用示範情境把這件事走一遍。假設確認庫存這個逾時的協程內部,其實還平行發起了另一個記錄稽核日誌的子協程:
suspend fun checkStockWithAudit(orderId: String): StockResult = coroutineScope {
    withTimeout(2_000) {
        launch {
            auditLogClient.record("開始確認庫存:$orderId")
        }
        stockClient.checkStock(orderId)
    }
}
如果 stockClient.checkStock 遲遲沒有回應,導致 withTimeout 判定逾時,這個取消訊號不會只停在最外層。它會沿著結構往下傳播,記錄稽核日誌的那個子協程,即使自己完全沒有出任何問題,也會因為結構化並發的取消傳播而一併結束,不會繼續留在背景寫著一筆已經沒有意義的日誌。
這種「整組收拾乾淨」的行為,正是結構化並發設計的核心價值,取消一件事的時候,牽動的是整個協程家族,而不是只砍斷最外層、卻留下內部殘留的協程繼續遊蕩。
看到這裡,可能會覺得 withTimeout 像是一把萬能的剪刀,時間一到就能立刻剪斷任何正在執行的程式碼。這個想像需要修正一下。
取消是一種協作式的機制,cooperative cancellation。協程需要在適當的時機點檢查自己是否已被要求取消,並主動配合結束,這不是外部強制介入中斷執行緒的機制,而是依賴協程自身的配合。這句話光用文字描述還是有點抽象,接下來用一組最精簡的對照,把它變成看得見的行為差異。
首先我們把 withTimeout 包住的區塊內部,分別替換成 delay(...) 與 Thread.sleep(...) 兩種寫法,搭配一個遠短於睡眠或延遲時間的逾時上限。
先看 delay 版本:
suspend fun demoWithDelay() {
    val start = System.currentTimeMillis()
    try {
        withTimeout(1_000) {
            delay(5_000)
            println("這行不會被印出來")
        }
    } catch (e: TimeoutCancellationException) {
        val elapsed = System.currentTimeMillis() - start
        println("delay 版本在 ${elapsed}ms 後結束,提早被取消")
    }
}
delay(5_000) 原本打算暫停五秒,但外層 withTimeout 只給了一秒的上限。因為 delay 本身是 suspend function,會在掛起點主動檢查取消狀態,withTimeout 一判定逾時,delay 會提早結束並拋出取消例外,實際執行結果會落在一秒附近就結束,而不是傻傻等滿五秒。
再看 Thread.sleep 版本:
suspend fun demoWithThreadSleep() {
    val start = System.currentTimeMillis()
    try {
        withTimeout(1_000) {
            Thread.sleep(5_000)
            println("這行會被印出來,但已經沒有意義了")
        }
    } catch (e: TimeoutCancellationException) {
        val elapsed = System.currentTimeMillis() - start
        println("Thread.sleep 版本在 ${elapsed}ms 後才結束")
    }
}
同樣是一秒的逾時上限,內部換成 Thread.sleep(5_000),結果完全不同。因為 Thread.sleep 不是 suspend function,它會直接把底層執行緒卡住整整五秒,不會在任何時間點檢查自己是否已被取消。withTimeout 設定的一秒上限在這裡完全不會被理會,協程實際上要等到 Thread.sleep 睡滿五秒才會繼續往下走,這時候才會補上拋出的取消例外,取消訊號形同虛設,晾在一旁整整多等了四秒。
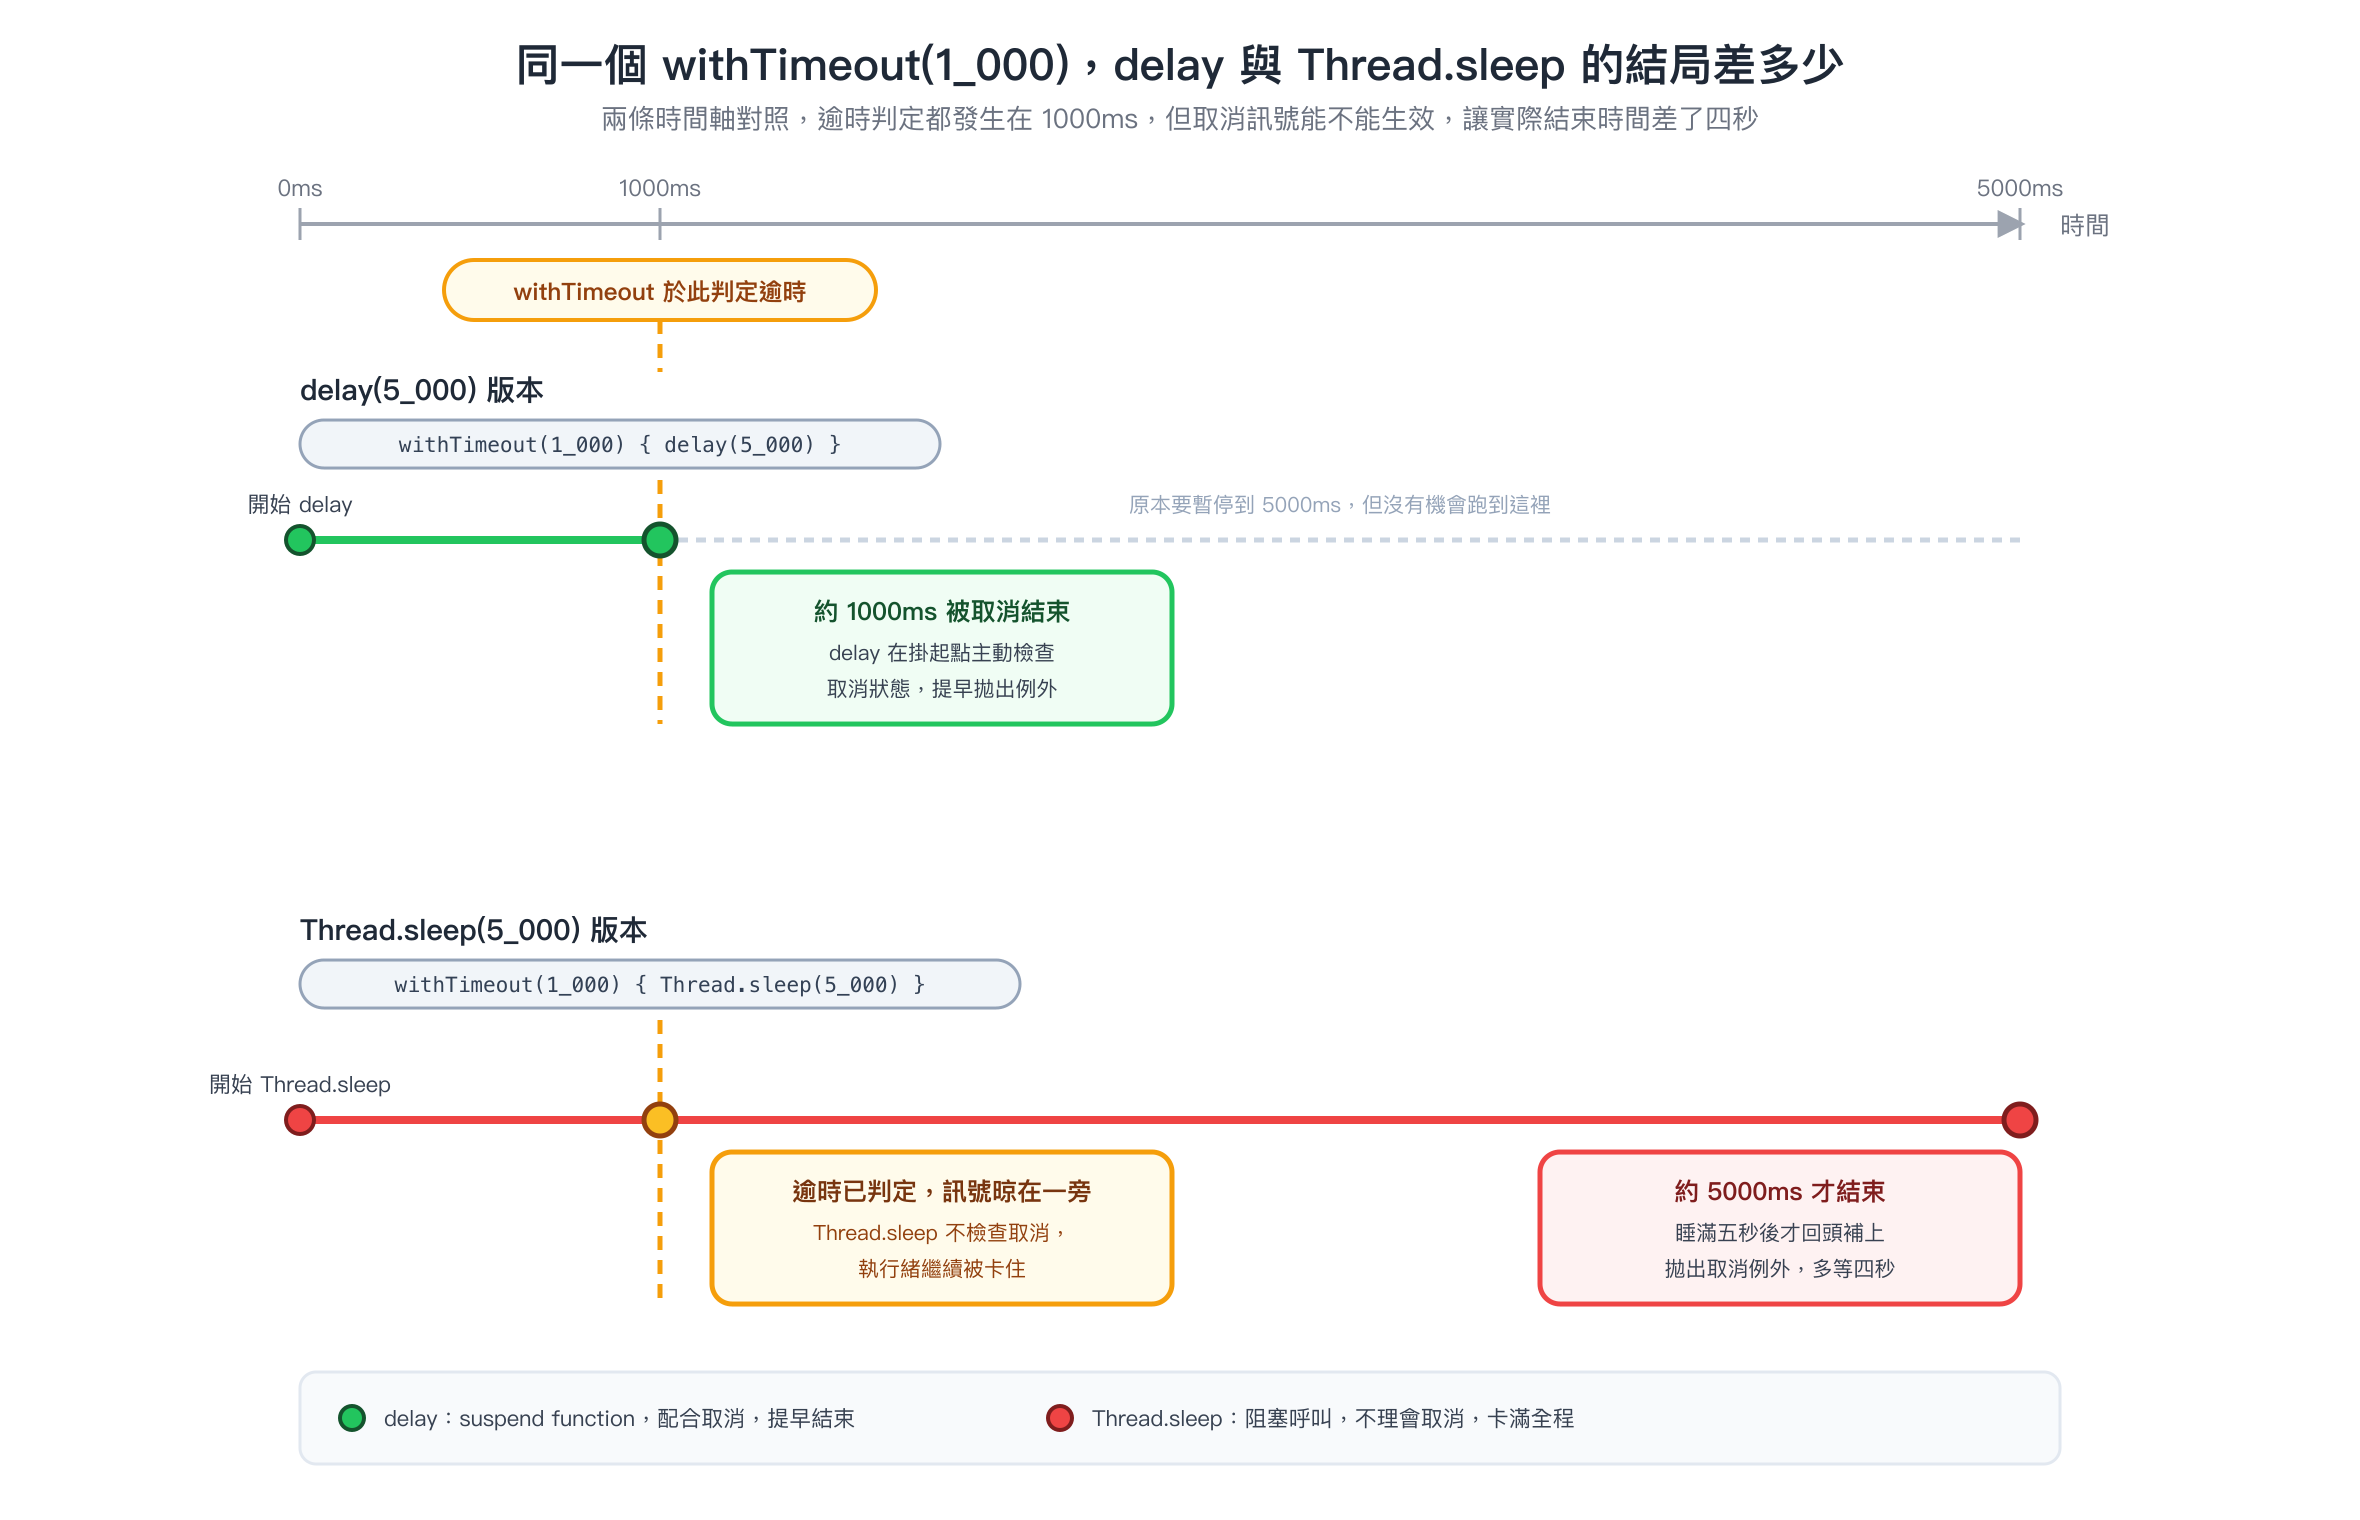
這組對照正是 Day 03:第一個 suspend function,協程到底暫停了什麼 建立的「暫停不等於阻塞」心智模型的延伸。delay 讓出執行緒的同時,也保留了被取消的機會;Thread.sleep 卡住執行緒的同時,也讓協程對取消訊號完全沒有反應的餘地。兩者的差異不只是有沒有浪費執行緒資源,更是能不能被正確取消,這是同一個心智模型在取消機制上的另一種展現。
這裡有兩個延伸提醒。第一,如果協程內部正在執行一段沒有機會檢查取消狀態的長時間運算,例如一段緊密迴圈的純運算邏輯,即使沒有像 Thread.sleep 這樣明顯的阻塞呼叫,取消訊號一樣可能無法立即生效,這件事先點到為止建立正確預期就好,如何在自訂運算邏輯中主動檢查取消狀態,不是今天要展開的內容。第二,對於呼叫外部服務或資料庫這類本身就是 suspend function 的操作,通常已經內建了對取消訊號的正確回應,因此本篇示範情境中呼叫下游服務的場景,一般不需要額外擔心取消不生效的問題。這個限制主要提醒讀者該避免的是,自行撰寫長時間不理會取消訊號的運算邏輯,或者誤用 Thread.sleep 這類阻塞式 API。
今天正式定案了逾時與取消機制,withTimeout 為協程設定執行時間上限,逾時後觸發的取消沿著 Day 6 定案的結構化並發父子關係傳播,本質上是把對應的 Job 標記為取消狀態,這與 Day 8 建立的機制一脈相承。也用 delay 對照 Thread.sleep 具體驗證了 cooperative cancellation 這件事,協程的取消依賴自身在掛起點主動配合,不是外部強制介入的中斷。
但這套機制解決的,是「某個協程異常地卡住太久」這個問題。如果問題根本不是某個協程卡住,而是整體資料產生的速度,本來就持續比處理速度快,這種結構性的速度落差,逾時取消解決不了。設再短的逾時上限,也無法讓下游追上生產端源源不絕湧入的資料,逾時只會讓越來越多請求提早失敗,卻沒有真正緩解速度落差本身。
下一篇會正式認識這個問題的答案:背壓。


 iThome鐵人賽
 看影片追技術