
Day 11:WebFlux 是什麼,協程與反應式模型的分工 停在一個尚未回答的風險上:即使應用程式用 WebFlux 搭配協程,整條請求處理鏈路理論上可以是非阻塞的,但如果中間查詢資料庫這一步用的還是傳統阻塞式的存取方式,前面辛苦建立起來的非阻塞優勢會不會前功盡棄。
今天要正面回答這個問題。
答案是:會,而且代價不小。這也是今天要補上的最後一塊拼圖。
先把這個風險講得更具體一點。多數工程師寫 Controller 或 Service 時,一旦養成用 suspend function 或 WebFlux 風格撰寫程式碼的習慣,很容易產生一種錯覺,以為只要外層程式碼看起來是非阻塞的寫法,整條鏈路自然就是非阻塞的。
這個錯覺之所以危險,是因為它讓人忽略了一件事:suspend function 或 Mono、Flux 這類型別,只保證你呼叫它們的那一層程式碼具備暫停與恢復的能力,並不保證它內部實際呼叫的底層驅動程式也具備同樣的能力。
資料庫存取,正好是這條鏈路裡最容易被忽略的一段。
查詢訂單、寫入庫存異動這些操作,最終都要透過某個資料庫驅動程式送出去,如果這個驅動程式骨子裡還是阻塞式的,套再多層 suspend function 或反應式包裝都沒有用,真正卡住執行緒的動作,發生在驅動程式那一層,外層的非阻塞語法只是把這個問題包了一層糖衣,沒有真正解決它。
要看清楚問題根源,得回到 JDBC 這個多數 Java 後端工程師都熟悉的資料庫存取方式,拆解它實際的呼叫方式。
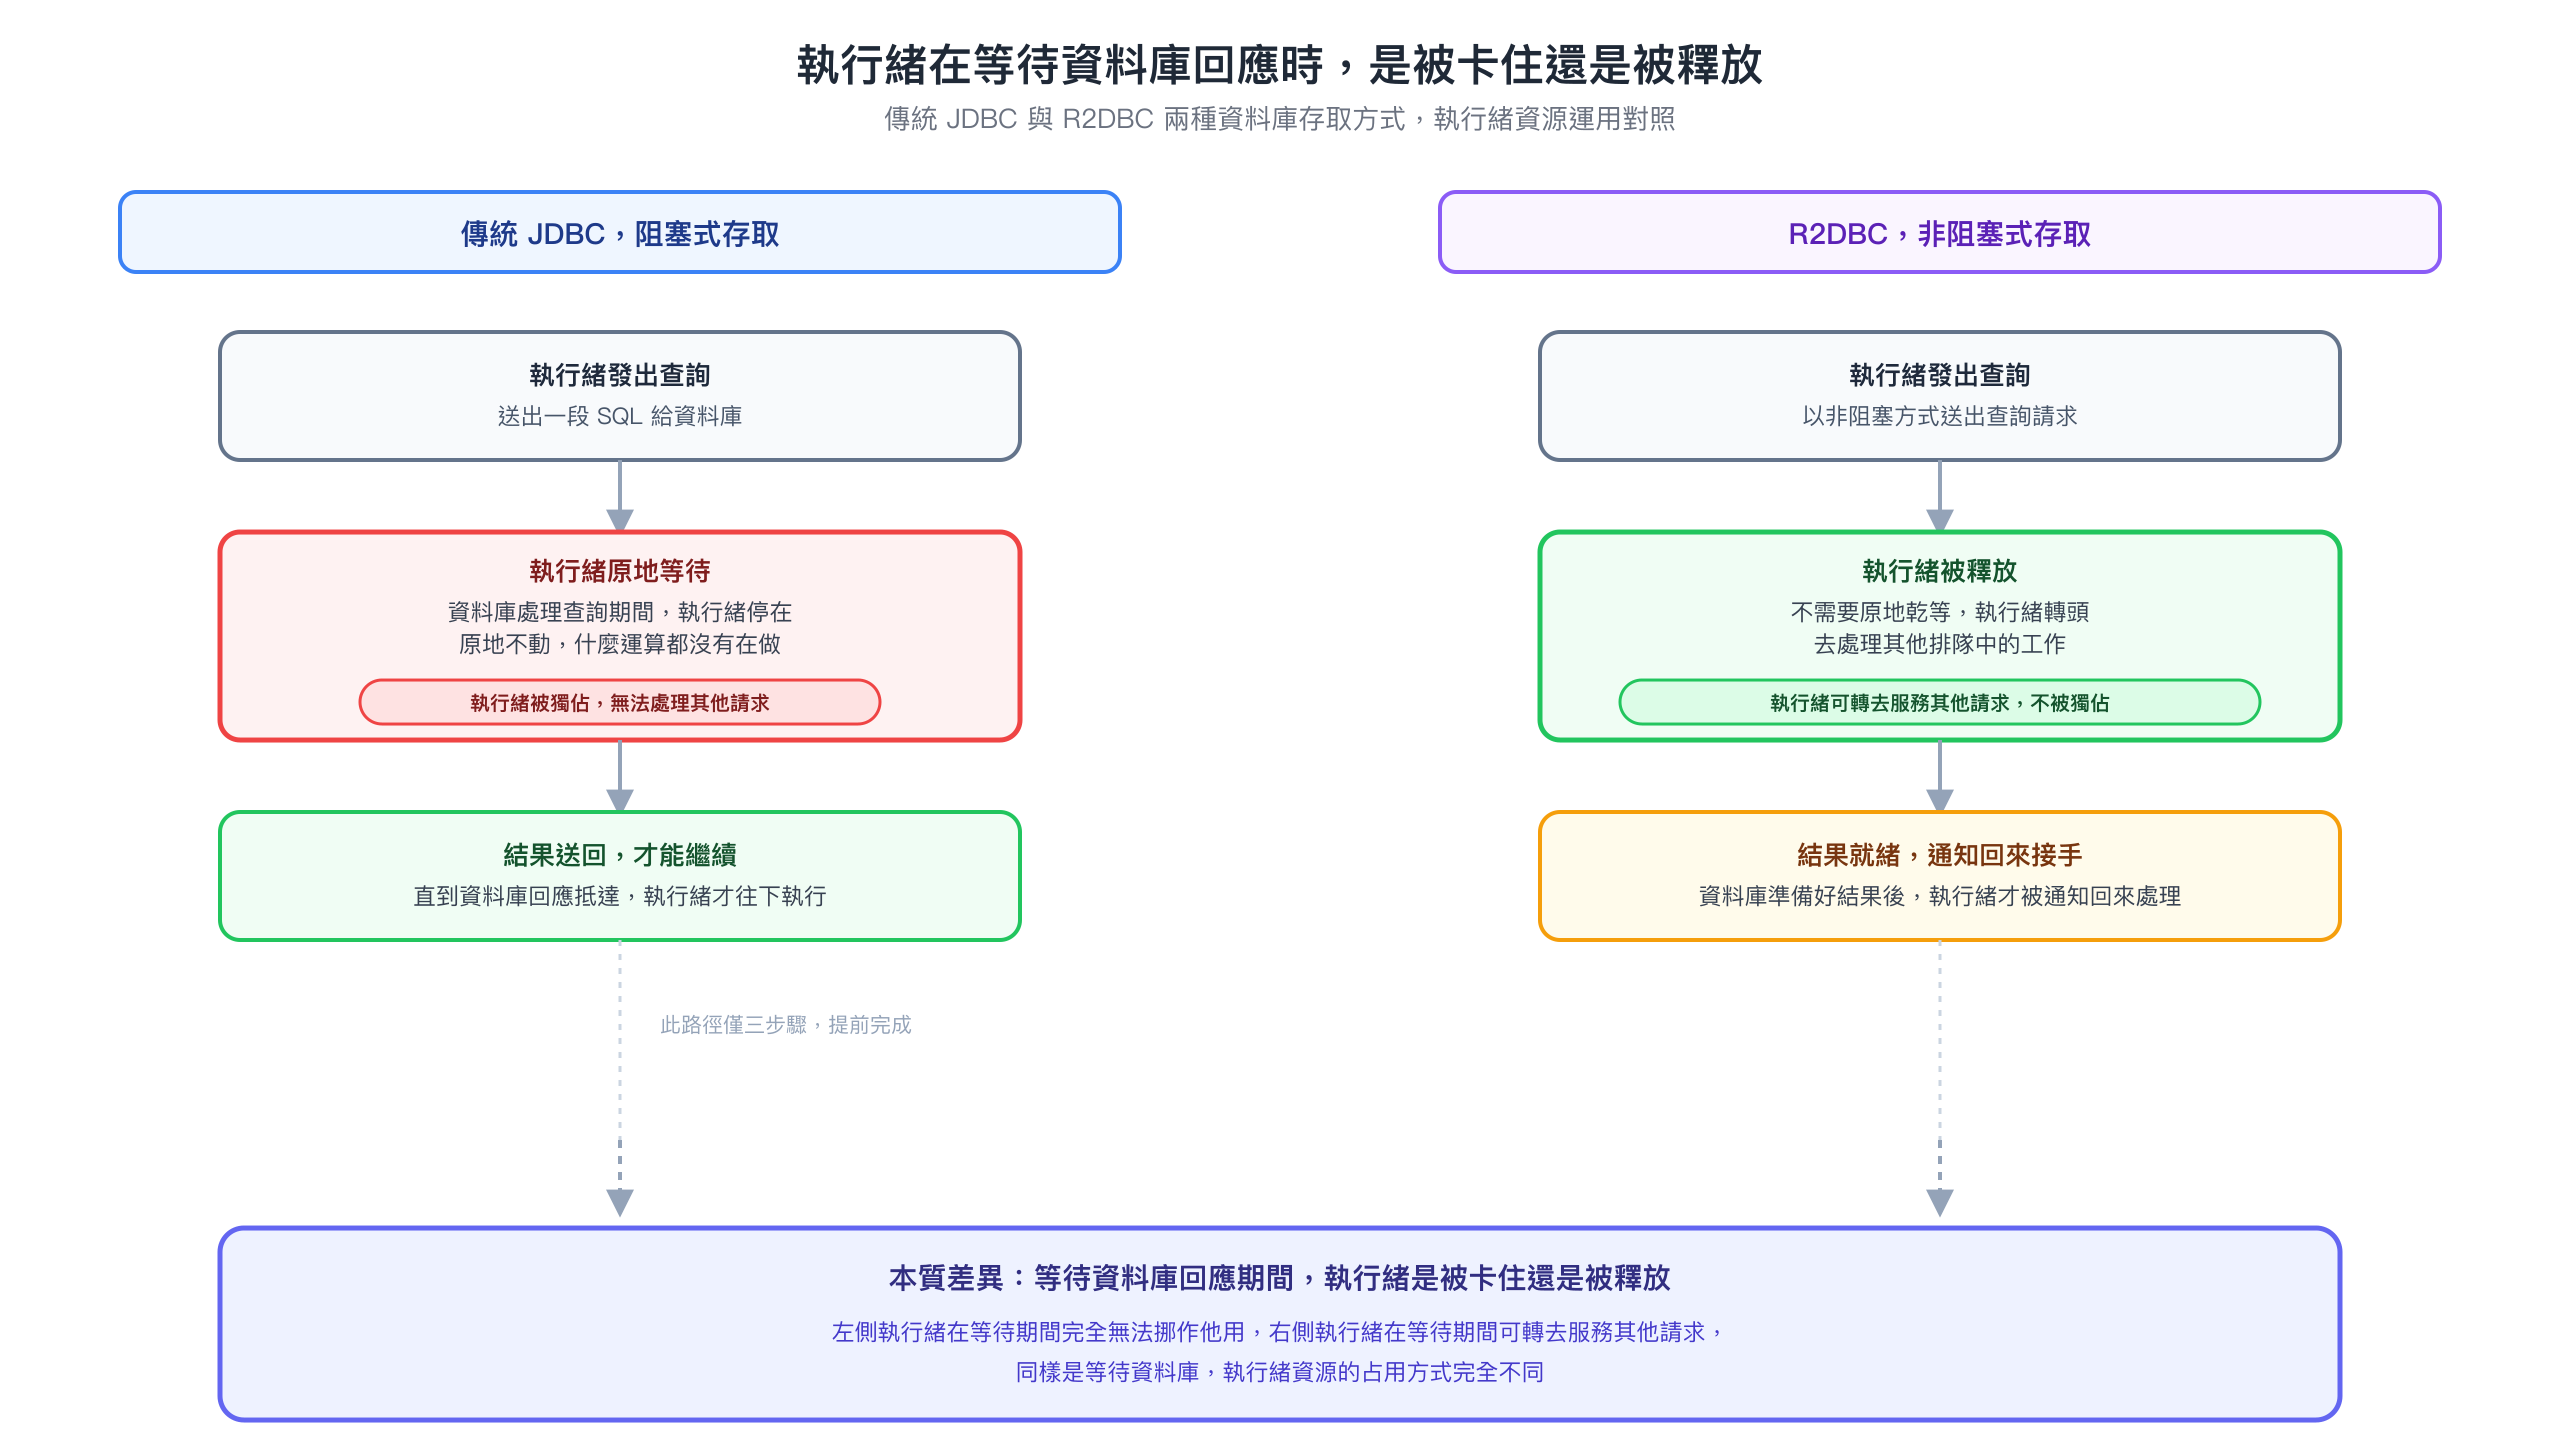
傳統 JDBC 的呼叫方式很直觀:執行緒呼叫查詢方法,例如送出一段 SQL,接著這條執行緒就停在原地,等資料庫把結果送回來,才能繼續往下執行程式碼。這段等待期間,執行緒什麼運算都沒有在做,純粹卡在那裡,直到資料庫回應抵達為止。
回頭看 Day 02:Thread-per-Request 模型的極限,搞懂你原本在用什麼 定案的「阻塞」定義:一條執行緒在等待某個操作完成之前,無法去處理任何其他請求,即使它自己當下什麼都沒在做。JDBC 這種呼叫方式完全符合這個定義,執行緒發出查詢後原地等待,等待期間無法被挪去處理別的請求,這正是阻塞的兩個構成要件同時成立的狀況。
拿示範情境具體化一下。假設訂單查詢與扣庫存服務的 Controller 已經照 Day 11:WebFlux 是什麼,協程與反應式模型的分工 的方式用 WebFlux 撰寫,Service 層也全都改寫成 suspend function,看起來整條鏈路乾乾淨淨,沒有一處阻塞。但如果內部查詢訂單這一步呼叫的是傳統 JDBC,這一步依然會讓執行它的執行緒陷入阻塞,而且問題在 WebFlux 情境下會被放大。
Day 11 提到,WebFlux 底層只用少量固定數量的事件循環執行緒輪詢大量連線,如果被 JDBC 卡住的正好是這幾條數量稀少的執行緒之一,影響範圍會比 Thread-per-Request 模型下更明顯。因為 Thread-per-Request 模型至少還有一整個執行緒池分攤壓力,事件循環執行緒卻是少數幾條被共用的資源,一條被卡住,等於同時拖累它原本要輪詢的所有其他連線。
問題根源找到了,接下來正式帶出解法:R2DBC。
R2DBC,全稱 Reactive Relational Database Connectivity,是一套讓關聯式資料庫存取也能以非阻塞方式進行的規格。
R2DBC 的基本原理,與前面幾篇建立的心智模型並不衝突,甚至可以說是同一套邏輯延伸到資料庫這一層。R2DBC 的資料庫操作以非阻塞方式發出請求,執行緒送出查詢後不需要原地乾等回應,而是可以先被釋放去處理其他事情,等資料庫真正把結果準備好,執行緒才被通知回來接手處理結果。
細心的讀者可能會發現,這與 Day 03:第一個 suspend function,協程到底暫停了什麼 建立的暫停恢復心智模型,方向完全一致,只是這次「暫停」的對象換成了資料庫查詢,而不是泛稱的某個操作。
這裡要正式把一件重要的事寫進正文:本系列對資料庫的技術堆疊定案為 PostgreSQL 搭配 R2DBC。全系列不引入 Redis,任何後續談到快取、分散式協調,或併發控制正確性的情境,一律回頭引用資料庫層級機制處理,不會另外拉進一套外部協調服務。
R2DBC 除了查詢與寫入這兩個最基本的操作之外,也有連線池的概念,同時允許交易操作。這兩塊今天只點出它們存在,具體的連線池大小設定與高併發下的風險情境,會留到 《Day 18:協程遇上 R2DBC 連線池,小心連線被偷偷耗盡》 深入處理;交易搭配協程處理併發控制正確性的完整做法,則會留到 《Day 24:庫存扣減的併發正確性,用資料庫機制取代分散式鎖》 展開。
今天只需要知道,非阻塞不代表這些機制消失了,它們依然存在,只是換了一種不阻塞執行緒的方式運作。
把前面的原理落到程式碼上。改用 Spring Data R2DBC 讓 Repository 方法可以直接宣告成 suspend function,內部呼叫 R2DBC 提供的非阻塞查詢能力,寫法上與熟悉的 Spring Data JPA 相當接近,差異主要在函式簽章多了 suspend 這個關鍵字。
以查詢單筆訂單為例:
interface OrderR2dbcRepository : CoroutineCrudRepository<Order, Long> {
    suspend fun findByOrderNumber(orderNumber: String): Order?
}
CoroutineCrudRepository 是 Spring Data R2DBC 提供給協程情境使用的介面,裡面內建的方法,例如 findById,本身就已經是 suspend function。這裡額外宣告的 findByOrderNumber 同樣直接標上 suspend,代表呼叫這個方法時,具備暫停與恢復的能力,不需要另外包一層轉換。範例刻意保持精簡,只示範單一查詢方法本身該怎麼宣告,不展開複雜的查詢條件、不涉及多表關聯,那些屬於更深入的查詢語法細節,超出今天要建立的認識範圍。
呼叫這個查詢方法時發生的事,正好可以回扣 Day 03 建立的暫停恢復心智模型。
執行到 findByOrderNumber 這一行,協程會在等待資料庫回應的那一刻暫停,執行它的執行緒被釋放,去處理其他排隊中的工作,等資料庫真正把結果送回來,協程才恢復執行,繼續往下處理拿到的訂單資料。這與 Day 3 那個最小化範例裡「暫停發生在等待的那一行,恢復發生在結果送回之後」的行為完全一致,只是這一次,等待的對象具體換成了資料庫查詢,不再是泛指的某個操作。
今天把非阻塞鏈路裡最後一塊容易被忽略的拼圖補上了。傳統 JDBC 為什麼是阻塞式的、R2DBC 怎麼用非阻塞的方式解決同樣的問題、以及 suspend function 怎麼把這個能力自然包裝進 Repository 方法裡,這三件事今天都講清楚了。全系列資料庫技術棧也在今天正式定案為 PostgreSQL 搭配 R2DBC,不引入 Redis,這個結論會一路沿用到系列後段。
但資料庫存取這一段的非阻塞問題解決了,並不代表整條請求鏈路就此高枕無憂。真實的訂單查詢與扣庫存流程,往往不只跟資料庫打交道,可能還需要呼叫其他內部服務確認庫存狀態,或者在扣庫存成功後發送一則通知訊息。這些呼叫又該怎麼處理,才不會重蹈今天講的覆轍,讓某個環節悄悄變回阻塞式呼叫,把辛苦建立起來的非阻塞鏈路再次拖垮?
下一篇 《Day 13:協程搭配訊息佇列與外部 API 呼叫的常見模式》,會接著討論協程搭配訊息佇列與外部 API 呼叫的常見模式。


 iThome鐵人賽
 看影片追技術