
上一篇知道了資料要保存下來就需要資料庫,也決定這次先使用 SQLite。
今天就來認識關聯式資料庫最基本的東西:
Table、Row、Column、id,還有 SQL 的 SELECT 和 INSERT。
關聯式資料庫把資料存在「表格」裡,可以先想成 Excel。
Table(資料表)
一張表格,用來存同一種資料。
例如 tasks 這張表就專門存作業。
Column(欄位)
表格的「直的」那一排,代表這種資料有哪些屬性。
例如 id、name、completed。
Row(資料列)
表格的「橫的」那一列,代表一筆資料。
例如「洗碗,未完成」就是一筆 Row。
畫成表格大概是這樣:
tasks
| id | name | completed |
|---|---|---|
| 1 | 洗碗 | 0 |
| 2 | 寫 Day 18 | 0 |
其實這跟我們前面寫的程式很像:
Day 14 我們用
tasks = [
    {"id": 1, "name": "洗碗", "completed": False},
]
List → 對應 Table(整張表)
Dict → 對應 Row(一筆資料)
Dict 的 key → 對應 Column(欄位)
所以概念上沒有變,只是換成存在資料庫裡。
Day 14 我們自己幫每一筆資料加了一個 id,用來指定要操作哪一筆。
資料庫也有同樣的概念,叫做 Primary Key(主鍵)。
主鍵的規則是:
不能重複
不能是空的
有了主鍵,就可以精準地指到某一筆資料,像是:
「把 id = 1 的那一筆的 completed 改成 1」
在 SQLite 中,如果把 id 設成:
id INTEGER PRIMARY KEY AUTOINCREMENT
資料庫就會幫我們自動編號,不用像 Day 14 那樣自己維護 next_id。
SQL = Structured Query Language(結構化查詢語言)。
它是拿來跟關聯式資料庫溝通的語言。
我們想對資料做的事情,其實就是 Day 14 的 CRUD:
新增 → INSERT
查詢 → SELECT
修改 → UPDATE
刪除 → DELETE
對照起來會發現,其實跟 HTTP Method 是同一組概念,只是一邊是對 API 說,一邊是對資料庫說:
POST → INSERT
GET → SELECT
PUT → UPDATE
DELETE → DELETE
CREATE TABLE tasks (
    id INTEGER PRIMARY KEY AUTOINCREMENT,
    name TEXT NOT NULL,
    completed INTEGER NOT NULL DEFAULT 0
);
一行一行看:
id INTEGER PRIMARY KEY AUTOINCREMENT
→ id 是整數、是主鍵、自動編號
name TEXT NOT NULL
→ name 是文字,而且不可以是空的(NOT NULL)
completed INTEGER NOT NULL DEFAULT 0
→ completed 是整數,不可以空白,沒給值的話預設是 0
這裡有一個要注意的地方:
SQLite 沒有真正的布林(Boolean)型別,習慣上會用 0 代表 false、1 代表 true。
所以我們 API 裡的 completed: false,存進 SQLite 會變成 0。
(之後使用 ORM 的時候,這個轉換會由套件幫我們處理,不用自己換。)
另外像 NOT NULL 這種規定,就是上一篇說的「資料庫可以幫忙把關資料規則」,資料不符合規定時它會直接拒絕。
INSERT INTO tasks (name, completed) VALUES ('洗碗', 0);
意思是:在 tasks 這張表新增一筆,name 是「洗碗」,completed 是 0。
因為 id 設定了 AUTOINCREMENT,所以不用自己填,資料庫會給。
查全部:
SELECT * FROM tasks;
也可以只查需要的欄位:
SELECT id, name FROM tasks;
加上條件:
SELECT * FROM tasks WHERE completed = 0;
WHERE 就是條件,這句的意思是「查出所有還沒完成的作業」。
查某一筆:
SELECT * FROM tasks WHERE id = 1;
這裡可以回頭對照 Day 14:
GET /tasks → SELECT * FROM tasks;
GET /tasks/1 → SELECT * FROM tasks WHERE id = 1;
前面我們是自己寫 for 迴圈一筆一筆找,資料庫則是用 WHERE 幫我們找。
UPDATE tasks SET completed = 1 WHERE id = 1;

DELETE FROM tasks WHERE id = 1;
這兩個一定要記得寫 WHERE。
如果寫成:
DELETE FROM tasks;
那就是把整張表的資料全部刪掉,而且不會跳出「確定嗎?」。
(這是很有名的慘案來源,練習的時候就養成先寫 WHERE 的習慣比較好。)
光看 SQL 沒什麼感覺,我們直接用 Python 內建的 sqlite3 跑一次。
在專案資料夾建立一個新檔案:
db_demo.py
import sqlite3

# 連線到 demo.db(檔案不存在就會自動建立)
conn = sqlite3.connect('demo.db')
cursor = conn.cursor()

# 建立資料表
cursor.execute("""
CREATE TABLE IF NOT EXISTS tasks (
    id INTEGER PRIMARY KEY AUTOINCREMENT,
    name TEXT NOT NULL,
    completed INTEGER NOT NULL DEFAULT 0
)""")
# 新增兩筆資料
cursor.execute("INSERT INTO tasks (name, completed) VALUES (?, ?)", ("洗碗", 0))
cursor.execute("INSERT INTO tasks (name, completed) VALUES (?, ?)", ("寫 Day 18", 0))

# 存檔(很重要)
conn.commit()

# 查詢全部
print("=== 全部作業 ===")
rows = cursor.execute("SELECT id, name, completed FROM tasks").fetchall()
# 把 id = 1 改成已完成
for row in rows:
    print(row)

cursor.execute("UPDATE tasks SET completed = 1 WHERE id = ?", (1,))
conn.commit()

print("=== 還沒完成的作業 ===")
for row in rows:
    print(row)

conn.close()
執行:
python db_demo.py
終端機會看到類似:
=== 全部作業 ===
(1, ‘洗碗’, 0)
(2, ‘寫 Day 18’, 0)
=== 還沒完成的作業 ===
(2, ‘寫 Day 18’)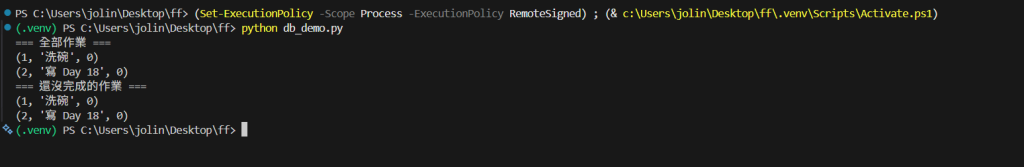
終端機執行 db_demo.py 的輸出結果
而且資料夾裡會多出一個檔案:
demo.db
這就是 SQLite 的資料庫檔案,整個資料庫就是這一個檔案。
資料夾裡出現 demo.db 這個檔案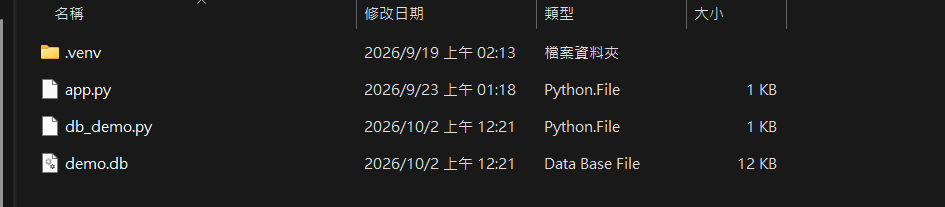
最重要的是:
再執行一次 python db_demo.py
會發現資料變成四筆了(原本兩筆 + 新增的兩筆)。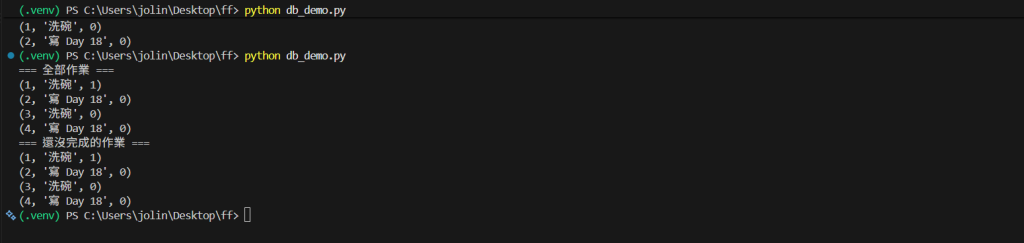
這就代表資料真的存到硬碟上了,不像前面存在記憶體那樣一關就沒。
(如果想重新開始,把 demo.db 刪掉再執行一次就可以了。)
第一,conn.commit()
SQLite 在做新增、修改、刪除之後,要 commit 才會真的寫進資料庫。
如果忘記寫,程式結束後會發現資料沒有存進去。
第二,為什麼是問號?
cursor.execute("INSERT INTO tasks (name, completed) VALUES (?, ?)", ("洗碗", 0))
這裡沒有把資料直接接在 SQL 字串裡面,而是先寫問號,再把值另外傳進去。
這叫做參數化查詢,跟資安有關,是防止 SQL Injection 的關鍵。
Day 27、Day 28 會專門講這件事,現在先記得:
不要用字串把使用者的輸入直接拼進 SQL。
Table → 一張表,存同一種資料
Column → 欄位,例如 id、name
Row → 一筆資料
Primary Key → 每筆資料的唯一編號
INSERT / SELECT / UPDATE / DELETE → 對應 CRUD
也實際用 Python 操作了一次 SQLite,看到資料真的被保存下來。
不過今天的程式全部都是自己寫 SQL 字串,看起來跟我們的 Flask API 還是兩回事。
如果每次要操作資料庫都要自己寫 SQL、自己轉成字典,好像有點麻煩。
下一篇就來看看 ORM 是什麼,以及 Flask 要怎麼連資料庫。


 iThome鐵人賽
 看影片追技術