
第六天,我們要進入資料分析實務中最耗時、但也最關鍵的環節——資料清洗(Data Cleaning)。在現實世界中收集到的數據很少是完美無瑕的,常因為問卷漏填、感測器斷線或系統傳輸遺漏而產生空值。在 Pandas 中,這些缺失值通常會以 NaN(Not a Number)呈現。今天我們以純 Python 腳本建立 day06_data_cleaning_nan.py,掌握缺失值的偵測、刪除與補值三大基本招式。
第一部分
新建 day06_data_cleaning_nan.py。首先建立一組包含 None 與 np.nan 的髒資料,並使用 .isna() 與 .sum() 統計各欄位的缺失狀況: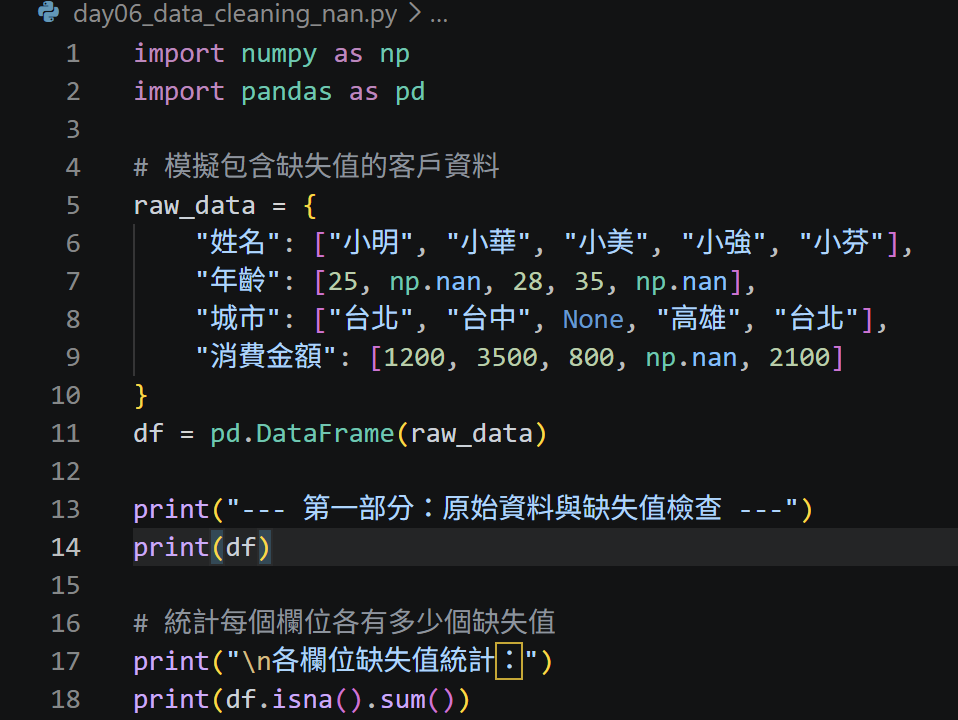
第二部分
當資料量龐大且缺失比例極低,或是某筆紀錄完全沒有分析價值時,最快的方式是直接「刪除(Drop)」。我們可以使用 dropna() 進行列刪除,或針對特定關鍵欄位進行過濾: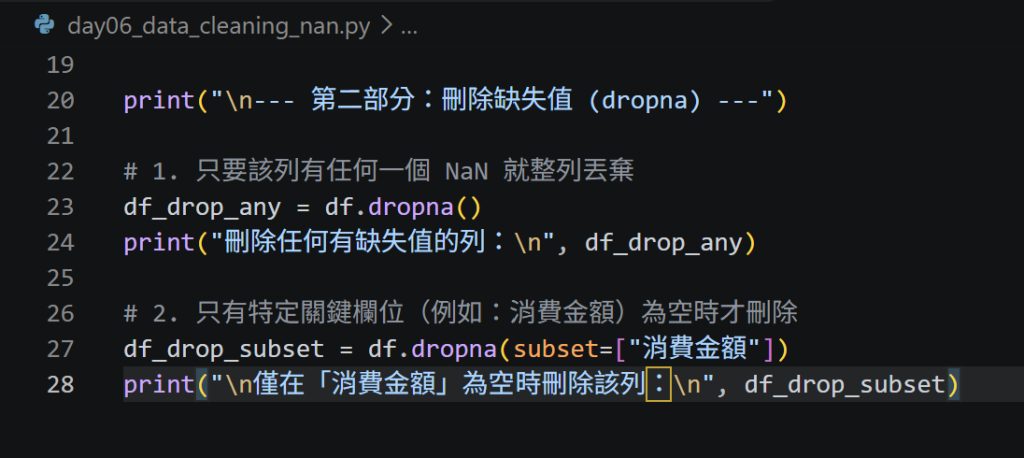
第三部分
在大部分情況下,直接刪除資料會損失過多樣本,因此更常見的策略是「填補(Imputation)」。我們可以使用 fillna(),依欄位特性填入固定字串、平均值或中位數: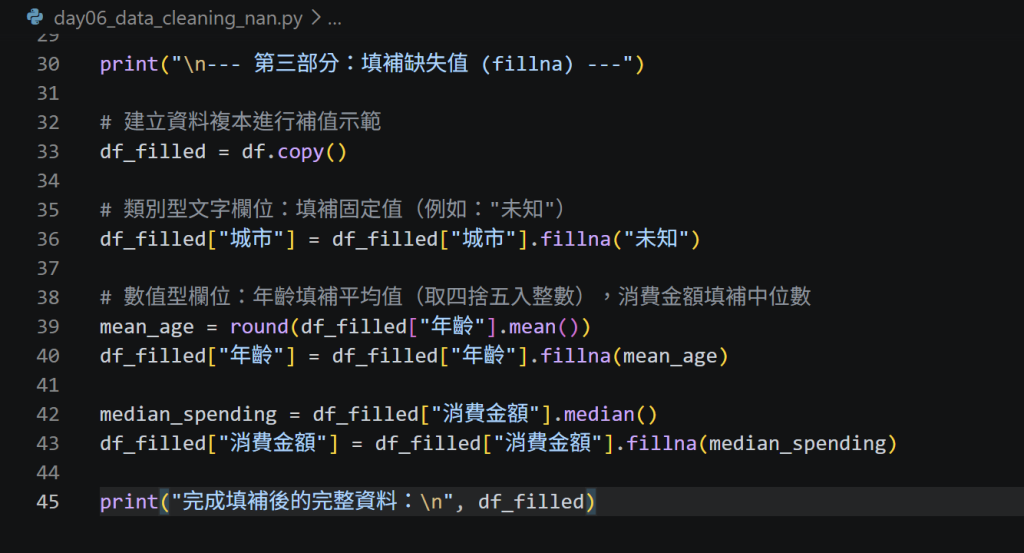
第四部分
在終端機執行 python day06_data_cleaning_nan.py 驗證,確認缺失值統計與補值運算皆正常輸出。接著按 Ctrl + S 儲存檔案,並推送到遠端儲存庫: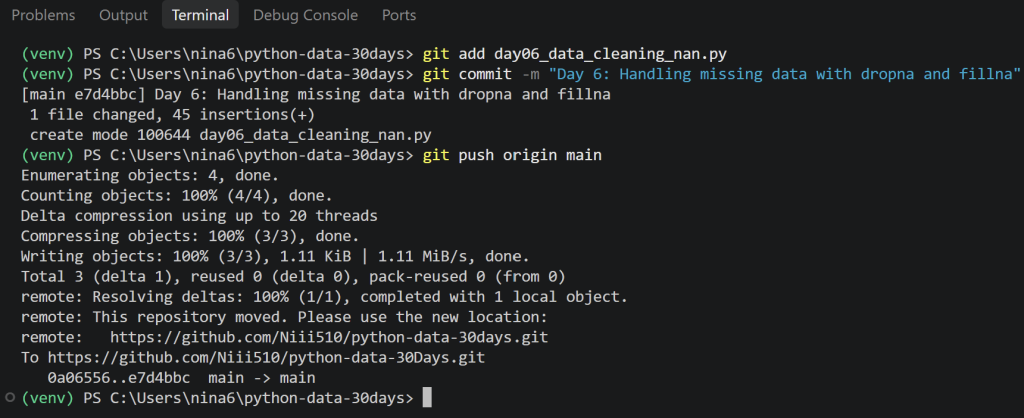
終端機提示推送成功,回到 GitHub 重新整理頁面,就能看到今天寫好的程式檔。
今日心得/遇到的問題
今天學會了面對數據缺失時的兩大核心處理策略:刪除與補值。在決定使用哪種方法前,一定要先用 df.isna().sum() 釐清缺失比例;隨意刪除可能會造成樣本偏差,但若是直接用平均數補值,在遇到有極端值的欄位時(如薪資收入),改用中位數填補會更貼近真實分佈,是資料清理時需要特別考量的細節。

 niii

 iThome鐵人賽
 看影片追技術