

Day 17 在同通路、同受眾裡比完,有人物的圖點擊率是 1.28 倍、按鈕在右下是 1.13 倍、暖色是 1.08 倍,今天把新客受眾裡點擊率最低的三張圖拉出來,Meta 的大浴巾 cr-meta-evg-p2 是 1.58%、Meta 的洗臉毛巾 cr-meta-aut-p1 是 1.60%、LINE 的訓練襪 cr-line-trn-p1 是 1.66%,三張都沒有人物,按鈕不是放在中間就是沒有按鈕,主色不是冷色就是中性色,等於 Day 17 找到有效的三個特徵它們一個都沒有。
只挑新客受眾是因為再行銷受眾的點擊率本來就比較高,全部放在一起排,最低的永遠是新客的圖,這一點 Day 17 已經看過了。
改版的方向看起來很清楚,但實際打草稿時麻煩的是細節,標題要寫什麼、副標放哪個賣點、按鈕上的字要不要換,今天把 Day 17 的倍數表、原圖和商品資料一起交給 Gemini,請它在 BigQuery 裡直接交出結構固定的草稿,再用同一份題目做兩個版本,一版沒寫品牌規則,一版在最後多加四條規則,看規則到底擋掉了什麼。
今日核心目標:
| 步驟 | 做什麼 | 產出 |
|---|---|---|
| 準備參考表 | 商品事實照抄 Day 04 小店的商品頁,另建一份不能寫進廣告的詞 | ref_product_facts 5 列、ref_claim_terms 38 列 |
| 打草稿 | 3 張圖 × 2 版題目 × 各 2 次,response_schema 規定 14 個欄位 | mm_drafts_log 呼叫紀錄 |
| 整理 | 每份草稿一列,算好照成效改了沒、引用的倍數對不對、冒出哪些詞 | mart_creative_drafts 12 列 |
| 檢查與報表 | 14 項流程檢查、八段報表 | check.sql、report.sql |
| 延伸 | rules 版一份草稿的畫面描述交給 Veo 3.1 Lite | 素材 bucket 的 veo/ 資料夾 |
💡 核心工程理念:
generate.sql 每次執行都從 mart_creative_lift 讀出來組成一段文字,Day 17 的資料更新之後重跑,題目裡的數字跟著變題目開頭先交代角色和品牌,接著分成四段,第一段是商品資料,取自 Day 04 小店商品頁的名稱、副標、說明、故事、材質與產地,第二段是這張圖的現況,用的是 Day 16 AI 看圖讀出來的特徵,題目裡寫的是「另一個模型看過這張圖」,第三段是倍數表,第四段是要交出的欄位,最後是上面那句「請盡量發揮創意」,倍數表那一段由 mart_creative_lift 組出來,Gemini 看到的是這樣:
person 畫面有真人:點擊率 1.28 倍,轉換率 1.09 倍(95% 信賴區間 0.93–1.28,區間包含 1,看不出差別)
cta 按鈕放在右下角:點擊率 1.13 倍,轉換率 1.13 倍(95% 信賴區間 0.94–1.37,區間包含 1,看不出差別)
warm 主色是暖色:點擊率 1.08 倍,轉換率 1.03 倍(95% 信賴區間 0.85–1.26,區間包含 1,看不出差別)
text 標題之外還有賣點或標籤:點擊率 0.97 倍,轉換率 1.08 倍(95% 信賴區間 0.91–1.29,區間包含 1,看不出差別)
只給分層後的倍數,不給不分層的,Day 17 已經看過不分層的右下按鈕連轉換率的方向都會反過來,轉換率的區間都包含 1,所以每一行都直接寫明看不出差別,轉換率的部分不需要模型自己判斷,點擊率只給倍數沒有給區間,文字量的 0.97 在 Day 17 判定為看不出差別,題目裡沒有註明,四捨五入也在組文字時就做好,mart.sql 檢查引用的倍數時用同一個取到小數兩位的值比對。
每份草稿要交 14 個欄位,標題、副標、標籤、按鈕文字、按鈕位置、要不要有人、主色、文字量、構圖說明、給生圖或生影片模型用的英文畫面描述、改了什麼、最主要依據哪個特徵、那個特徵的倍數、預期效果。
第一輪用的是 Day 16 的寫法,output_schema 只鎖型別,free 版 6 份都合格,rules 版 6 份只有 3 份合格,一份寫了 4,081 個 Token 撞到輸出上限被截斷,另外兩份在 text_density 的 high 後面多接了一串英文,其中一份是一大段自問自答要填 high 還是 low,型別是字串,所以 output_schema 照收,選項外的值在 generate.sql 的成功定義裡算失敗,不會進草稿表。
這和 Day 15 的結論一樣,output_schema 鎖得住型別,鎖不住選項,Day 15 六張圖的分類題兩種鎖法看不出差別,今天題目變長、要寫文案,差別就出來了,第二輪改用 response_schema,把按鈕位置、主色、文字量和引用的特徵用 enum 鎖在選項裡,為了讓兩版用同一種鎖法比較,free 版也一起重跑,兩版 12 次全部重來,第一輪的紀錄留在 mm_drafts_log,method 欄位是空的那 12 筆就是第一輪的結果,費用照算,下面是 14 個欄位裡的節錄:
"response_schema": {"type": "OBJECT", "properties": {
  "headline": {"type": "STRING"},
  "cta_position": {"type": "STRING", "enum": ["center", "bottom_right", "none"]},
  "dominant_color": {"type": "STRING", "enum": ["warm", "cool", "neutral"]},
  "text_density": {"type": "STRING", "enum": ["low", "high"]},
  "cited_feature": {"type": "STRING", "enum": ["person", "cta", "warm", "text"]},
  "cited_ratio": {"type": "NUMBER"}
}}
第二輪 12 次全部合格,沒有一次撞到輸出上限,輸入平均每次約 2,240(free)與 2,390(rules)個 Token,輸出約 270 到 370 個 Token。
rules 版在題目最後多四條規則:
ref_claim_terms 先準備了 38 個不能寫進廣告的詞,功效 13 個、醫療 10 個、絕對用語 15 個,比對標題、副標、標籤和按鈕這四個會出現在廣告上的欄位,結果兩版都抓到 0 個,free 版沒有寫出抗菌、除臭,也沒有寫醫療或第一名。
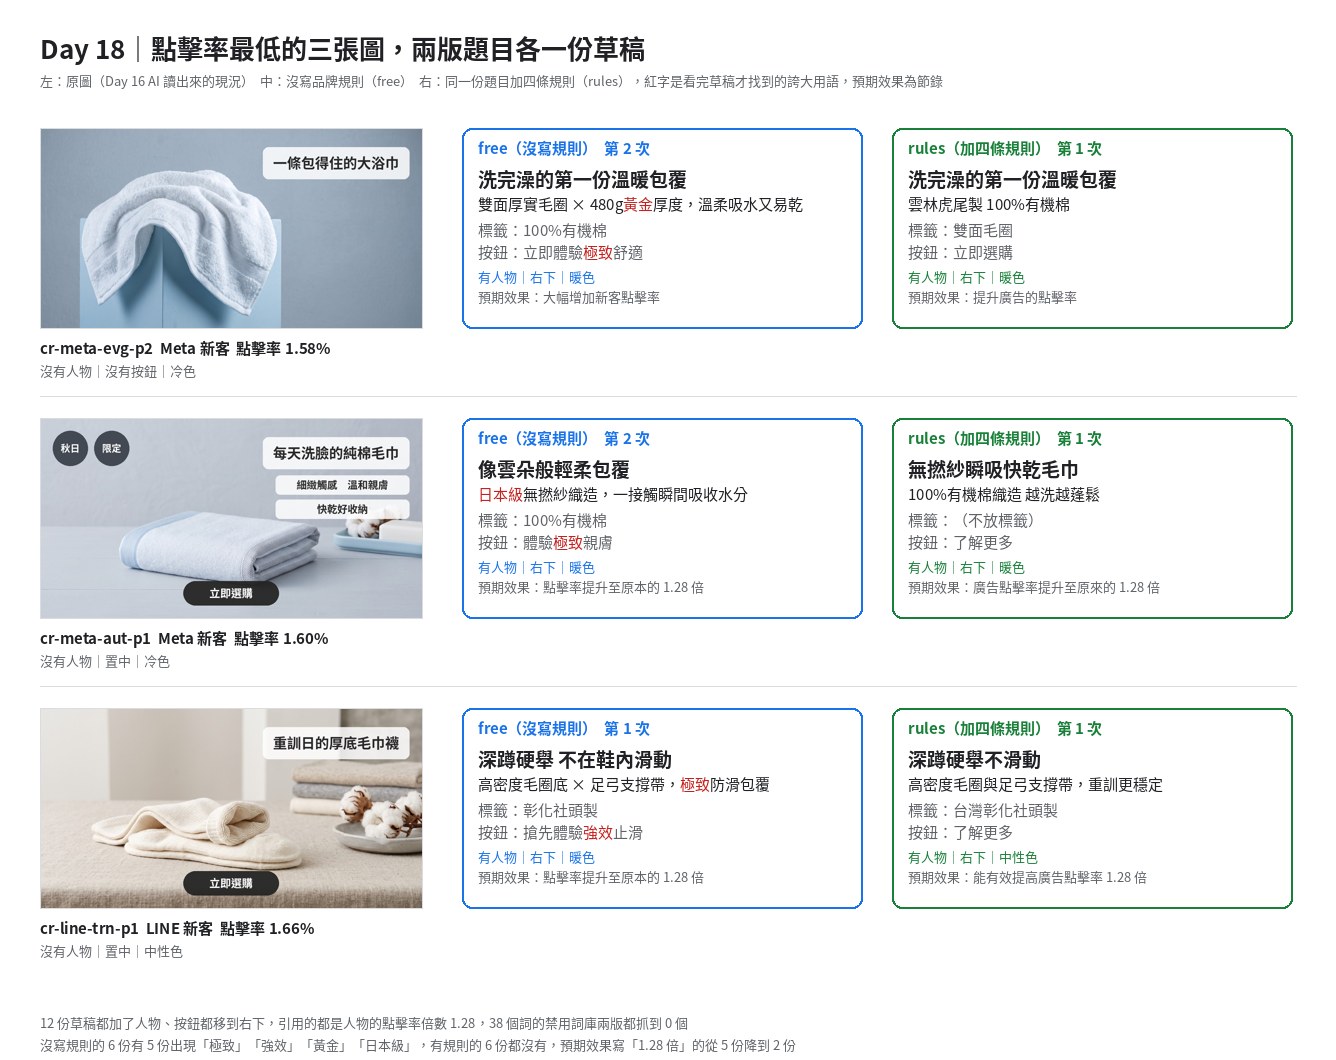
但一份一份讀下來,free 版 6 份有 5 份出現了詞庫沒列到的誇大用語,按鈕寫「立即體驗極致舒適」「搶先體驗強效止滑」,副標寫「480g黃金厚度」,還有一份寫「日本級無撚紗織造」,商品資料裡只有無撚紗,沒有任何和日本有關的事,這已經不只是用詞誇張,而是商品資料裡沒有根據的等級宣稱,還可能讓人誤以為和日本有關,另一份大浴巾的副標寫「厚實瞬吸又好晾乾」,瞬吸是洗臉毛巾的賣點,大浴巾的商品資料裡沒有,rules 版的 6 份一個誇大用語都沒有,報表第 8 段把極致、強效、黃金、日本級這四個詞拿來數,這段是看完草稿之後才加的,第 5 段用詞庫判定的結果沒有改,這四個詞要不要收進詞庫留到 Day 23 做過濾時再決定。
free 版這幾個詞有一部分是「可以多強調商品的機能和使用效果」那句引出來的,但兩版都有這句,所以差別仍算在規則頭上。
預期效果也有差別,free 版 6 份有 5 份把點擊率會變成 1.28 倍寫進預期效果,例如「預期將點擊率提升至原本的 1.28 倍」,rules 版降到 2 份,1.28 倍是 23 張圖在合成資料裡算出來的平均差異,不是對一張新圖的預測,第 3 條規則只擋了轉換率和銷售,沒有擋點擊率,所以還有 2 份照抄,兩版都沒有一份提到轉換率、成交或銷售。
| 項目 | free(沒寫規則) | rules(加四條規則) |
|---|---|---|
| 加上人物 | 6/6 | 6/6 |
| 按鈕移到右下 | 6/6 | 6/6 |
| 改成暖色 | 6/6 | 4/6 |
| 引用的倍數對到點擊率 | 6/6 | 6/6 |
| 詞庫抓到的詞 | 0 | 0 |
| 誇大用語(看完才找到) | 5/6 | 0/6 |
| 預期效果寫 1.28 倍 | 5/6 | 2/6 |
| 副標 20 字以內 | 3/6 | 6/6 |
12 份草稿都加了人物、都把按鈕移到右下,引用的都是人物那一行的 1.28,沒有一份拿轉換率的數字當依據,照成效改這件事兩版做得一樣好,rules 版 LINE 訓練襪的兩份草稿保留了中性色,洗臉毛巾的兩份把標籤拿掉、文字量從 high 改成 low,暖色的點擊率倍數只有 1.08,文字量的點擊率倍數是 0.97,Day 17 判定看不出差別,留著或拿掉都說得通,第 4 條字數規則 rules 版 6 份都做到,free 版有 3 份副標超過 20 個字。
兩版真正的差別在文案用字,同一張大浴巾,free 版的副標是「雙面厚實毛圈 × 480g黃金厚度」,rules 版是「雲林虎尾製 100%有機棉」,後者每個字都能在商品資料裡找到,這份草稿也就是下一章交給 Veo 的那一份。
這一章是選配,影片是在 BigQuery 外面產生的,和 Day 02 定下的「運算向資料靠攏」不同,只是示範草稿的英文畫面描述可以直接接到生影片的模型。
veo.sh 從草稿表挑 rules 版、點擊率最低那張圖的第一份草稿,也就是大浴巾「洗完澡的第一份溫暖包覆」,把 Gemini 寫的 image_prompt 補上一句鏡頭慢慢推近、不要文字與商標,送給 Vertex AI 的 veo-3.1-lite-generate-001,參數寫死 4 秒、720p、不含音軌、只生一支,輸出寫到素材 bucket 的 veo/ 資料夾:
"parameters": {
  "durationSeconds": 4,
  "sampleCount": 1,
  "generateAudio": false,
  "resolution": "720p",
  "aspectRatio": "16:9",
  "personGeneration": "allow_adult",
  "storageUri": "gs://專案ID-martech-assets/veo/cr-meta-evg-p2-rules-1/"
}
Veo 3 系列的長度只能選 4、6、8 秒,預設是 8 秒,一定要明確寫 4,送出之後拿到一個 operation 名稱,veo.sh 先把它存進 bucket,再每 15 秒查一次進度,萬一中斷,重跑只會接著查,不會重新送出,同一份草稿已經有影片就不再呼叫。
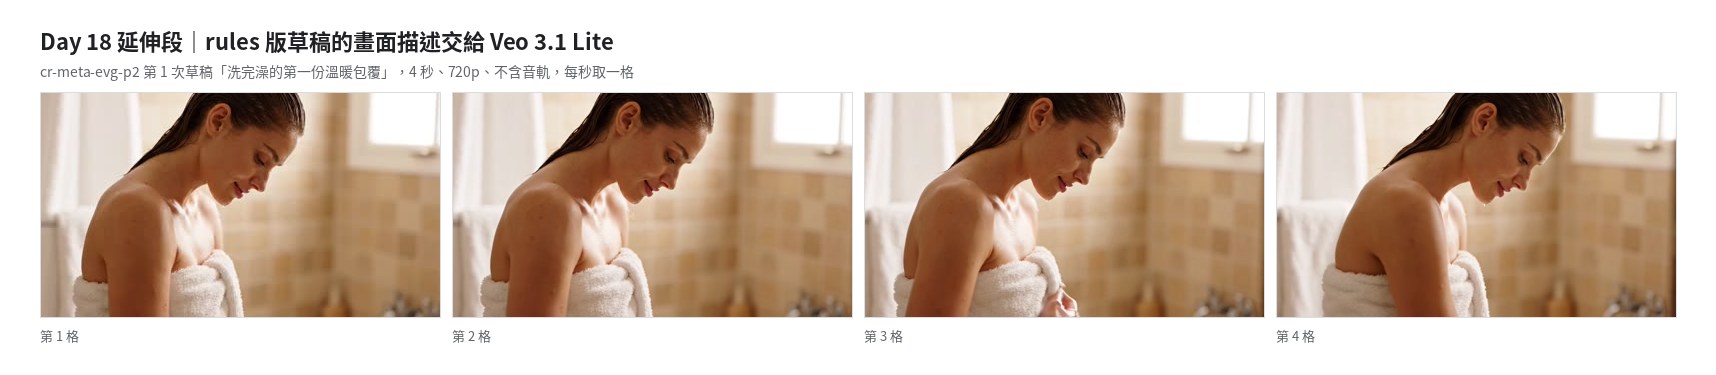
產出的是 1280 × 720、每秒 24 格的 4 秒影片,畫面是洗完澡裹著白色浴巾的人物,暖色光線,和草稿的構圖說明一致,因為題目要求不要文字,標題、副標和右下的按鈕都不在影片裡,真的要投放還得後製加上去,也要再確認人物和場景符合品牌調性。
run.sh 呼叫 Gemini 前先依「這次真的要呼叫的次數」印出最壞情況,輸入以每次 2,600 個 Token、輸出以上限 4,096 個 Token 計,12 次最多約新台幣 7.3 元,跑過的組合不重跑,同一輪裡緊接著的重跑呼叫 0 次,veo.sh 也是先印最壞情況再問,同一份草稿有影片就不再呼叫| 項目 | 呼叫次數 | 費用 |
|---|---|---|
| 第一輪(output_schema) | 12 | 新台幣 1.82 元 |
| 第二輪(response_schema) | 12 | 新台幣 1.23 元 |
| Veo 3.1 Lite,4 秒 | 1 | 約新台幣 4 到 6 元,最壞 12.8 元 |
Gemini 的費用依 gemini-3.6-flash 非 global 端點的單價(輸入每百萬 Token 0.825 美元、輸出 4.125 美元)與實際 Token 數算出,24 次合計約新台幣 3.05 元,全部記進 Day 16 建的共用用量表 ops_llm_usage,Veo 不是用 Token 計費,同一張表只記一列呼叫紀錄,Vertex AI 的定價頁目前沒有列 Veo 3.1 Lite,約新台幣 4 到 6 元是用第三方整理的每秒 0.03 到 0.05 美元估的,最壞情況用定價頁上 Veo 3 Fast 不含音軌每秒 0.10 美元估,實際金額等帳單出來再更新。
~/ai-driven-martech-pipeline 執行 git pull,取得 Day 18 的 drafts/ 目錄gcloud config get-value project 要印出你的專案 IDdim_creative)、Day 14(物件表 obj_creatives)、Day 16(特徵表 mart_creative_features)與 Day 17(mart_creative_perf、mart_creative_lift)gcloud auth list,帳號前面要有星號cd ~/ai-driven-martech-pipeline && git pull && bash drafts/run.sh
run.sh 先建商品事實與詞庫,印出這次要呼叫幾次和最壞情況的費用,輸入 yes 才會呼叫 Gemini,接著建草稿表、緊接著重跑一次確認不重複收費,最後是 14 項檢查和八段報表,延伸段另外執行:
bash drafts/veo.sh
bq query --nouse_legacy_sql --format=pretty < drafts/facts.sql
建立 ref_product_facts(5 項商品)與 ref_claim_terms(38 個詞),不呼叫 Gemini。
bq query --nouse_legacy_sql --format=pretty < drafts/generate.sql
bq query --nouse_legacy_sql --format=pretty < drafts/mart.sql
generate.sql 會呼叫 Gemini,只補還沒成功的組合,印出這次各版本呼叫幾次、成功幾次和 Token 數,mart.sql 把成功的草稿整理成 mart_creative_drafts。
bq query --nouse_legacy_sql --format=pretty < drafts/check.sql
bq query --nouse_legacy_sql --format=pretty --max_rows=100 < drafts/report.sql
check.sql 是 12 項流程檢查,另外兩項由 run.sh 補上,一項確認緊接著的重跑沒有重複呼叫,一項用 grep 確認打草稿的 SQL 沒有讀答案資料集,report.sql 八段分別是對象、草稿一覽、照成效改了沒、引用的倍數、詞庫比對、預期效果原文、費用與看完草稿才找到的詞。
mart_creative_drafts 12 列,free、rules 各 6 列,三張對象圖都是新客受眾點擊率最低的三張ctr,引用的倍數對到倍數表裡的點擊率run.sh 的 14 項檢查全部通過,緊接著的重跑呼叫 0 次mart_creative_drafts 和 ref_claim_terms 留著,Day 23 做護欄時會拿 free 版的草稿當詞彙過濾的測試素材,mm_drafts_log 是呼叫紀錄,兩輪都留著,Veo 的影片在素材 bucket 的 veo/ 資料夾,不需要的話可以自己刪掉,一支約 0.9 MB。
response_schema 的 enummax_output_tokens 裡,上限要把兩者都算進去,截斷的那一次一樣收費,generate.sql 把 finish_reason 記下來,check.sql 會數有沒有截斷之後沒補成功的組合今天把 Day 17 的分層倍數、原圖和商品資料交給 gemini-3.6-flash,在 BigQuery 裡替新客受眾點擊率最低的三張圖打改版草稿,兩版題目每張圖各跑兩次,12 份草稿都加了人物、都把按鈕移到右下,引用的倍數都對到點擊率的 1.28,第一輪用 output_schema 有 3 份不合格,改用 response_schema 的 enum 之後 12 份全部合格,Gemini 兩輪合計約新台幣 3 元,延伸段把一份草稿交給 Veo 3.1 Lite 渲染了一支 4 秒短片。
回到篇名,靈感卡關時讓 Gemini 根據成效打草稿,照倍數表改版它做得很徹底,改完的圖點擊率會不會真的變高還要上線測過才知道,真正要花心思的是規則,沒寫規則的草稿方向一樣,卻有 5 份出現了誇大用語,其中一份還寫了商品資料沒有根據的「日本級」,38 個詞的詞庫一個都沒抓到,把規則寫進題目之後這些詞都不見了,但預期效果裡把平均差異寫成對這張圖的預測的還剩 2 份,草稿可以交給 AI 打,上線前的把關還是得有。
明日預告:Day 19《廣告說一套、網站寫一套?叫 AI 幫你抓出來》,今天的草稿只看廣告圖本身,明天把廣告圖和點進去之後的活動頁放在一起,請 Gemini 比對兩邊的說法有沒有對得上。


 iThome鐵人賽
 看影片追技術