
Day 17 分清了情緒分數與設備狀態。接著,我想批次分析操作人員回報,再將結果載入 BigQuery。這次批次實作從讀檔、逐則呼叫、合併分數到載入表格;延伸到設備回報時,我更在意每一則最後去了哪裡。
假設同一批有三則回報:
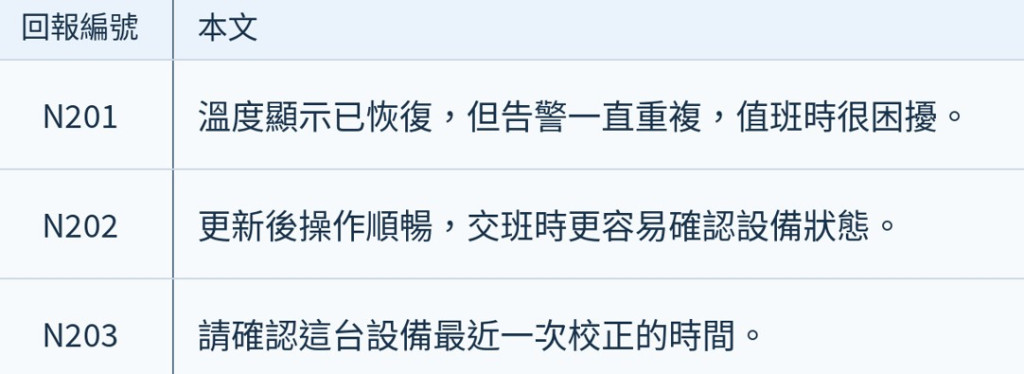
若只有 N201、N203 取得結果,程式即使走到最後,也不能把整批寫成「全部成功」。這三則說明的是處理構想,尚未經過真實設備資料驗證。
讀檔時,我會先核對編號與本文。若匯出的 N201 本文含半形逗號,再用「遇到逗號就切開」的方式讀 CSV,送進 API 的可能只剩「溫度顯示已恢復」。API 仍可能正常回傳分數,但它分析的已不是原來那則回報。
轉檔操作使用理解 CSV 引號規則的解析工具,整理編號與本文供迴圈讀取。轉完除了數列數,也要看文字是否完整。若採 TSV,仍須處理內文的 Tab 與換行。
送出前也要檢查個資。若回報附有人員電話,就在分析用文字中遮罩電話,保留設備描述。Sensitive Data Protection 支援遮罩、替換等去識別化處理;原文與送出文字的對照,則要在適當權限下保存。
呼叫時,N201 成功就保存分數與回應;N202 失敗就記錄錯誤,再處理 N203。合併資料時,按照編號配對,不能把分數檔的第二列直接當成原文的第二列。
如果 N202 沒有回應,後面的資料很容易錯位。N203 的分數一旦接到 N202,列數可能仍然合理,分析對象卻已經錯了。
處理紀錄則留下編號、分析狀態、嘗試次數與錯誤原因。沒有取得分數,就留下失敗狀態,不能補成零分。 零分可能是有效的情緒分析結果,與「根本沒有分析成功」是兩回事。
假設 N202 遇到暫時性服務錯誤,我希望稍後只重試 N202;N201、N203 的成功結果已經保存,不必整批重新呼叫。若原因是請求格式錯誤或權限不足,則先修正設定,持續重送相同請求通常無法解決問題。
我會把這段處理設計成:
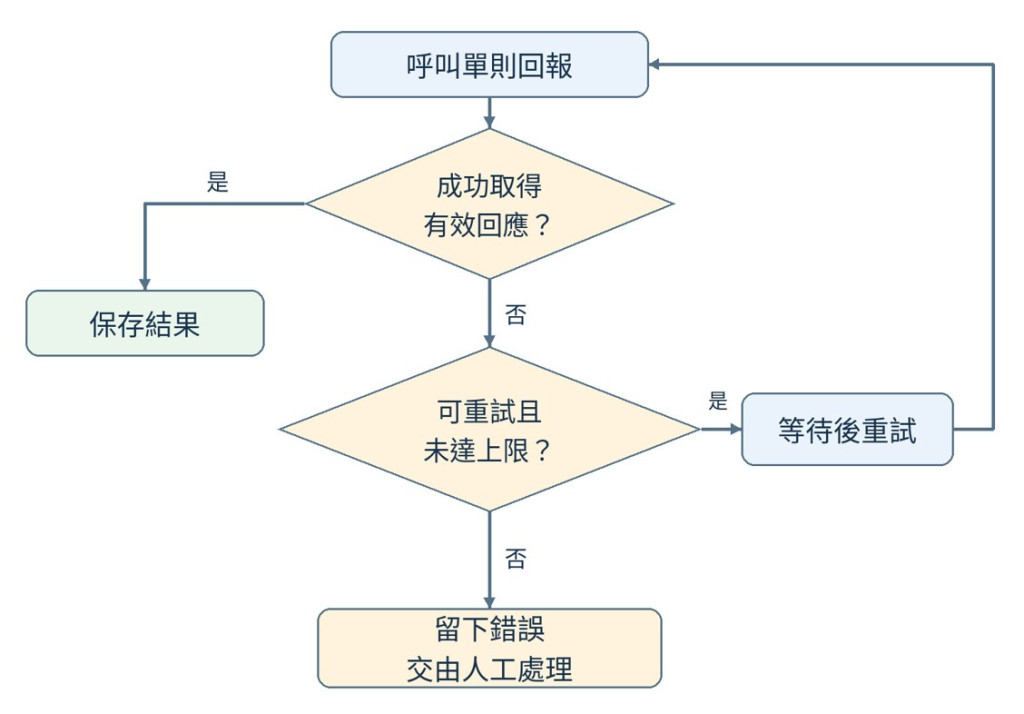
Natural Language C++ 用戶端文件提供重試、退避等待與上限設定。我借用的是這個設計觀念;手寫 REST 迴圈仍要自行實作,不能假設已經具備相同行為。
批次量增加前,也要查看專案共用的請求配額與輸入限制。我會限制呼叫速度與重試次數,避免一次失敗演變成沒有終點的重送。
取得結果後,我先把原文與分數合併成可載入的檔案,明確指定 Schema,再檢查 BigQuery 載入工作的狀態與表格內容。
若後續要同時保存分析時間、API 版本與完整回應,我會評估 JSON Lines:每則結果是一個 JSON 物件,各占一行,本文中的換行由 JSON 編碼處理。BigQuery 支援載入這種格式,也能在指定為 JSON 的欄位保存原始 JSON 值。
這裡還有一個重要分界:N202 若已分析成功,只是在載入 BigQuery 時失敗,下一步應重試寫入已保存的結果,不能直接再呼叫情感分析。
使用 BigQuery API 建立載入工作時,我也可以沿用同一個工作 ID 查詢或重試,避免網路中斷後,不確定前一次是否成功就另建工作。官方文件說明,同一工作 ID 的 jobs.insert 具有冪等性,也就是重送同一工作不會建立另一份工作;業務資料仍須另外去重。
N202 補跑成功,就補入缺少的結果。若人員修改本文,則保留新文字版本並重新分析。
因此,我會用「回報編號、文字版本、分析設定版本」辨認一份結果;分析設定版本記錄 API 版本與文字處理方式。相同條件下的重試,沿用同一份結果識別;改了文字或分析設定,就建立另一份結果。
寫入正式結果表前,先在暫存表檢查必要欄位與重複資料,再依識別欄位使用 MERGE 合併。GoogleSQL 的 MERGE 可以依匹配條件執行新增或更新,但匹配條件與來源去重仍由我設計。
這呼應 Day 13、Day 16 的去重要求。同一回報有多份分析結果時,還須選定統計使用哪一份。
回到這批資料:若 N201、N203 已成功入表,N202 仍等待重試,我會記錄「兩則已入表、一則待處理」。若 N202 重試後仍失敗,就保留原因與人工處理狀態,不讓它悄悄消失。
驗收時,我會從輸入清單往回查:每個編號是否有處理紀錄?成功結果是否對應正確原文?已分析成功的資料是否都已入表?重跑後是否多出重複結果?這些檢查比單看「載入成功」更接近整批資料的實際狀況。
到了 Day 19,我才有條件討論情緒分類與比例。那些統計必須建立在可追查的結果上,並另外說明未成功分析的回報;否則,漂亮的比例可能只是漏掉了一部分資料。


 iThome鐵人賽
 看影片追技術