
我把「發版前要檢查什麼」寫成一個資料夾,放進專案的 .claude/skills/,然後問 Claude Code 兩個問題:一個跟發版無關,一個是「我要發版了」。兩次的請求我都用 proxy 攔下來,看那份作法到底什麼時候才進到窗口。第 18 篇給 Claude 的是一個工具,這一篇給的是一整套作法。
先講結論:技能(skill)就是一個資料夾。平常窗口裡只有它的一行描述,等 Claude 判斷用得到,才把整份作法讀進來。
資料夾長這樣:
.claude/skills/release-check/
├── SKILL.md
└── scripts/
    └── check_version.py
SKILL.md 開頭是一段 YAML,只有名字和描述,後面才是作法:
---
name: release-check
description: 檢查這個專案現在能不能發版:版本號、CHANGELOG 是否對得上。使用者說要發版、release、打 tag 之前使用。
---

# 發版前檢查

照順序做,任何一步不過就停下來,告訴使用者哪裡不過、怎麼修。

1. 讀 `VERSION`,記下要發的版本號。
2. 確認 `CHANGELOG.md` 裡有這個版本號的段落。
3. 執行 `python3 .claude/skills/release-check/scripts/check_version.py`。
4. 全部通過才回答「可以發版」,並列出要打的 tag:`v<版本號>`。
我故意讓專案過不了:VERSION 寫 1.4.0,CHANGELOG.md 只有 1.3.0。跑了一次(2026-10-03,Claude Code 2.1.287,claude-opus-5-5),用 token-inspectour 攔下每一個請求,逐一比對檔案的哪一部分、在哪一個請求進來:
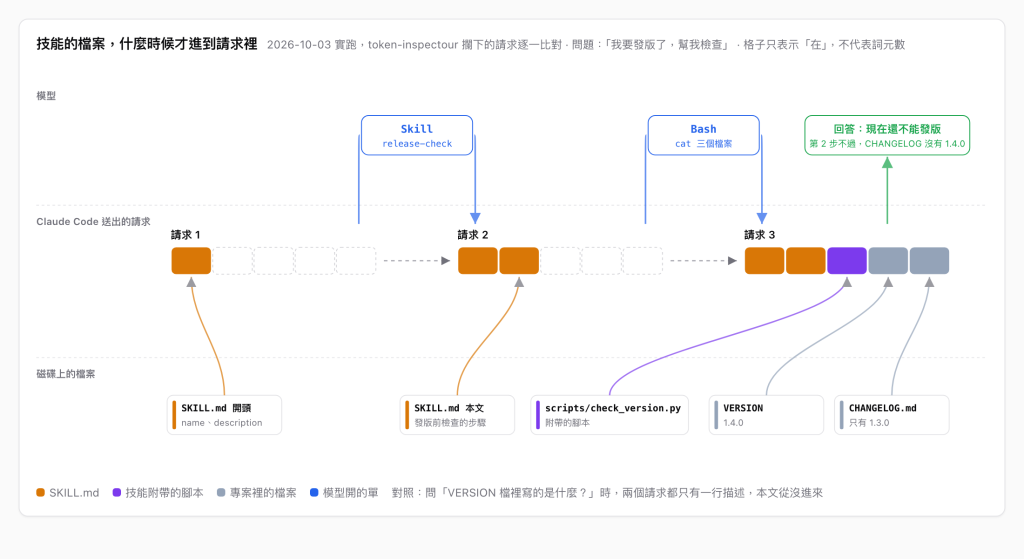
由左往右讀:一行描述從請求 1 就在。Claude 開了 Skill 的單,本文才在請求 2 進來。它再用 Bash 把三個檔案 cat 出來,腳本原始碼、VERSION、CHANGELOG 才在請求 3 進來。問「VERSION 檔裡寫的是什麼」那一題,兩個請求都只有那一行描述,本文從沒進來。
那一行描述在請求裡長這樣,混在一份技能清單裡:
- release-check: 檢查這個專案現在能不能發版:版本號、CHANGELOG 是否對得上。使用者說要發版、release、打 tag 之前使用。
發版那一題,Claude 照「任何一步不過就停」在第 2 步停下,回答「現在還不能發版」,附上要補的 CHANGELOG 段落,連要打的 tag v1.4.0 都寫了。(只跑一次,是例子不是證據。)
Claude 的技能文件把這個叫漸進式揭露(progressive disclosure),分三層(2026-10-03 查):
| 層 | 什麼時候載入 | 大小 | 內容 |
|---|---|---|---|
| 1. 中繼資料 | 一直都在 | 每個技能約 100 詞元 | name 與 description |
| 2. 指令 | 技能被觸發時 | 5k 詞元以內 | SKILL.md 本文 |
| 3. 資源與程式碼 | 用到才載入 | 沒讀之前 0 | 附帶的檔案與腳本,腳本執行時只有輸出進窗口 |
實驗大致照這張表走,例外是腳本的原始碼還是進了窗口。它這次沒有執行腳本,卻自己用 cat 讀了一次。文件說的「只有輸出進窗口」,前提是它直接執行。它要讀檔,你攔不住。想省這一筆,就在 SKILL.md 寫明「直接執行,不用讀內容」。
攔到的請求還顯示,Claude Code 把技能清單放在對話訊息裡,不在系統提示。官方的提示詞快取文件寫明,載入技能是把指令附加成對話訊息,所以前面已經快取的那一段不會失效(2026-10-03 查)。
把攔到的請求跟 Claude Code 的技能文件對起來,從資料夾到 Claude 照著做,中間是五步(2026-10-03 查):
一,掃描。 Claude Code 會找幾個固定的位置:企業管理的、你個人的 ~/.claude/skills/、專案的 .claude/skills/,以及子目錄裡的 .claude/skills/。同名的技能,企業的蓋過個人的,個人的蓋過專案的。SKILL.md 改了它會即時偵測,不用重開。
二,列清單。 每個技能變成一行「名稱:描述」,整份清單放在對話裡的一段系統提醒中。這份清單有預算:模型窗口的 1%。技能太多、放不下時,它從你最少用的技能開始拿掉描述,名字永遠留著。/context 裡 Skills 那一列,就是清單實際占掉的大小。
三,Skill 是一個普通的工具。 我攔到的定義只有兩個參數:
{ "name": "Skill",
  "input_schema": { "properties": { "skill": { "type": "string" },
                                    "args":  { "type": "string" } },
                    "required": ["skill"] } }
它的描述寫明,可用的技能會出現在系統提醒的清單裡,任務符合時先叫這個工具。所以「Claude 決定用技能」,就是第 16 篇講的開一張單。
四,叫了之後,本文用一段新的訊息送進來。 實驗裡第二個請求長這樣:
tool_use     {"name": "Skill", "input": {"skill": "release-check"}}
tool_result  "Launching skill: release-check"
text         Base directory for this skill: <repo>/.claude/skills/release-check
             # 發版前檢查
             照順序做,任何一步不過就停下來……
工具結果只有一句「Launching skill」,作法是另外一段文字,開頭那段 YAML 已經拿掉,換成這個技能資料夾的路徑。有了這個路徑,本文裡寫的 scripts/check_version.py 才能用一般的 Bash 工具去跑。
五,送進來之前還會先加工。 本文裡的 $ARGUMENTS、$0、或你在 arguments 欄位宣告的 $name,會換成叫用時帶的參數。寫成 !`git diff HEAD` 的那一行,Claude Code 會先執行、把那一行換成輸出,Claude 看到的就是目前的 diff。
最後,這份本文會一直留在對話裡。第 14 篇講過,壓縮之後技能本文會被重新放回來,每個上限 5,000 詞元、合計 25,000 詞元,超過的從最舊的開始丟。
第一層只有描述,所以 Claude 決定要不要用這個技能,靠的就是那一行。官方文件說描述必須同時寫它做什麼、什麼時候用。我實際試了一次這句話的分量。
同一個專案裝兩個技能:release-check,以及一個會跟它搶的 git-tag,描述是「幫使用者打 git tag。使用者說要打 tag 時使用」。release-check 準備兩種描述,一種只寫「發版用的檢查。」,另一種是上面那句,多寫了「打 tag 之前使用」。然後問一句沒提到檢查的話:「幫我打 v1.4.0 的 tag」,各跑三次(2026-10-03):
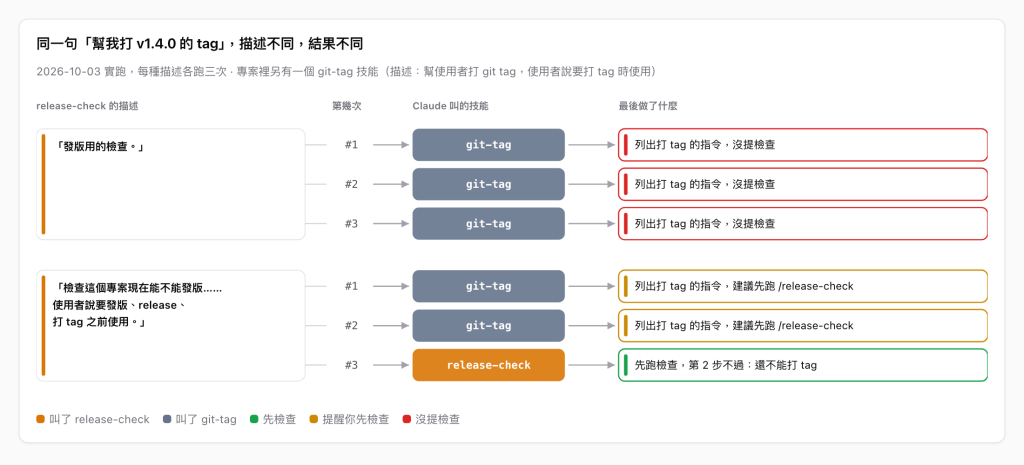
只寫「發版用的檢查」時,三次都直接列出打 tag 的指令,沒有人提到這個版本其實過不了檢查。多寫一句「打 tag 之前使用」,三次裡有一次先跑了檢查,另外兩次也會提醒你先跑。(各跑三次,是例子不是證據。)
所以描述會改變它被叫到的機會,但不保證一定會叫。「打 tag 之前一定要檢查」這種非做不可的規矩,不能只寫在描述裡,要寫進 git-tag 技能的步驟本身。
Claude Code 的技能文件還給了幾個欄位(2026-10-03 查):
when_to_use:補充觸發的說法,接在描述後面,兩者合計上限 1,536 個字元。disable-model-invocation: true:不讓 Claude 自己叫,只能由你打 /release-check。發版這種有副作用的流程,很適合這樣設。allowed-tools:叫用這個技能的那一輪,哪些工具不用再問你。把做過的事存成可以重用的步驟,研究上有脈絡。Voyager(Wang et al., 2023)讓代理維護一個持續長大的技能庫,每個技能是一段可執行的程式碼,需要時取回來組合。Agent Workflow Memory(Wang et al., 2024)則從過去的任務裡歸納出常用的工作流程(workflow),選擇性地提供給代理,在 Mind2Web 與 WebArena 兩個網頁導航基準上,成功率相對提升 24.6% 與 51.1%。
技能是同一個想法的手寫版:流程是你寫的,Claude 只負責在對的時候讀進來照做。它也接得回第四層:記憶存的是事實,技能存的是作法。
| 面向 | MCP 伺服器 | 技能 |
|---|---|---|
| 給的是什麼 | 一個動作,一組參數 | 一套作法:步驟、檢查清單、腳本 |
| 誰執行 | 另一個行程裡的伺服器 | Claude 照著做,用它原本就有的工具 |
| 平常在窗口裡的 | 工具名稱,定義用到才載入 | 一行描述 |
| 存的是什麼 | 一筆 JSON 設定:怎麼啟動或連上伺服器 | 一個資料夾:作法本身 |
兩邊存在磁碟上的資料,長得完全不一樣。第 18 篇的退款伺服器,在 .mcp.json 裡只有這一筆:
{ "mcpServers": { "refund": {
    "type": "stdio", "command": "python3", "args": ["refund_raw.py"], "env": {} } } }
這一筆裡沒有任何一個工具的名稱或描述。它只告訴 Claude Code 怎麼把伺服器跑起來,工具有哪些、參數長什麼樣,要等伺服器啟動、回應 tools/list 才知道。這一篇的技能則是反過來,作法本身就是檔案:
.claude/skills/release-check/
├── SKILL.md            ← YAML 開頭(name、description)+ Markdown 本文
└── scripts/
    └── check_version.py
這帶出三個實際的影響:
SKILL.md,改完存檔,Claude Code 當下就偵測得到。.mcp.json 在 code review 裡只看得到一行指令,真正會交給模型的描述藏在伺服器裡,要攔下來才看得到。技能的描述與每一個步驟都是純文字,跟程式碼放在同一個 PR 裡讀得到、diff 得出來。Bash 去跑的。Anthropic 在介紹技能的工程文章裡說,技能可以補 MCP 伺服器的不足,教代理怎麼完成用到外部工具的複雜流程,並在 2025 年 12 月把技能發布成開放標準。MCP 規格那一側,也列了一個「Skills over MCP」的擴充,讓技能可以透過 MCP 被找到與使用。
我的分法:一個動作用 MCP,一套作法用技能,作法裡要用的動作交給 MCP 的工具。 發版檢查就是例子:要跑的檢查是作法,真的去打 tag 的那個動作,可以是一個 MCP 工具。
技能是開放標準(agentskills.io),所以已經有跨工具的目錄。skills.sh 是 Vercel 做的技能目錄,自稱「開放的代理技能生態系」,配一個命令列工具:
npx skills add vercel-labs/agent-skills          # 裝進這個專案
npx skills add vercel-labs/agent-skills -g       # 裝到使用者層,所有專案都看得到
它的說明寫支援 Claude Code、Codex、Cursor 等將近八十種代理(2026-10-03 查),網站上也有一欄安全稽核。不過裝別人的技能,等於把別人的指令和腳本放進你的專案,裝之前,自己把 SKILL.md 和腳本讀一遍。
第一,描述要跟其他技能搶位置。 每多一個技能,清單就多一行,Claude 要從裡面挑。描述寫得含糊,該用的時候就不會被叫到,上面那三次「發版用的檢查」就是。
第二,技能是別人的指令加別人的腳本。 官方文件說得很直接:只用可信來源的技能,也就是你自己寫的、或 Anthropic 提供的。來路不明的,要把 SKILL.md、腳本和所有附檔都審過一次,因為惡意的技能可以叫 Claude 執行跟描述不符的動作。
第三,載入不完全由你控制。 它可能讀你只想讓它執行的檔案,本文一旦載入也會留在這段對話裡。
多了什麼能力:你能把一套作法寫成技能資料夾,知道它的三層載入在請求裡實際長什麼樣、描述怎麼決定它會不會被叫到,以及技能跟 MCP 各自該放什麼。
多付了什麼代價:一份要跟其他技能搶位置的描述、一個需要審過才能信的資料夾,以及一個不完全由你決定讀什麼的載入過程。
這一層給了 Claude 工具、伺服器和技能,它終於能動手了。那如果那段工具描述、那份 SKILL.md,是別人寫來騙它的呢?
第 18 篇引過的研究說,5.5% 的開源 MCP 伺服器有工具投毒的問題。下一篇把這一層的帳算完:副作用、權限的邊界,以及藏在描述與資料裡的指令。
SKILL.md 的欄位、when_to_use 與 1,536 字元上限、disable-model-invocation。


 iThome鐵人賽
 看影片追技術