你有過這個經驗嗎,晚上十點,原本只想拿起手機設個鬧鐘。回過神來,已經過了半小時,而大拇指還在螢幕上無意識地往下滑動,看著一支接一支其實並不需要知道的短影音。
當我們為此感到懊惱,把這歸咎於自己「意志力薄弱」時,其實我們太低估了對手。
從歷史來看,1833年興起於美國的「便士報」透過極低售價匯聚大眾注意力並轉賣給廣告商,開創了現代媒體的商業模式;但從報紙到演算法,有一個本質轉變:過去是由報紙主編「一對多」決定集體閱讀內容,如今則是演算法為全球數十億人「即時客製」專屬動態牆,以千人千面的精準制約重新塑造了我們的注意力。
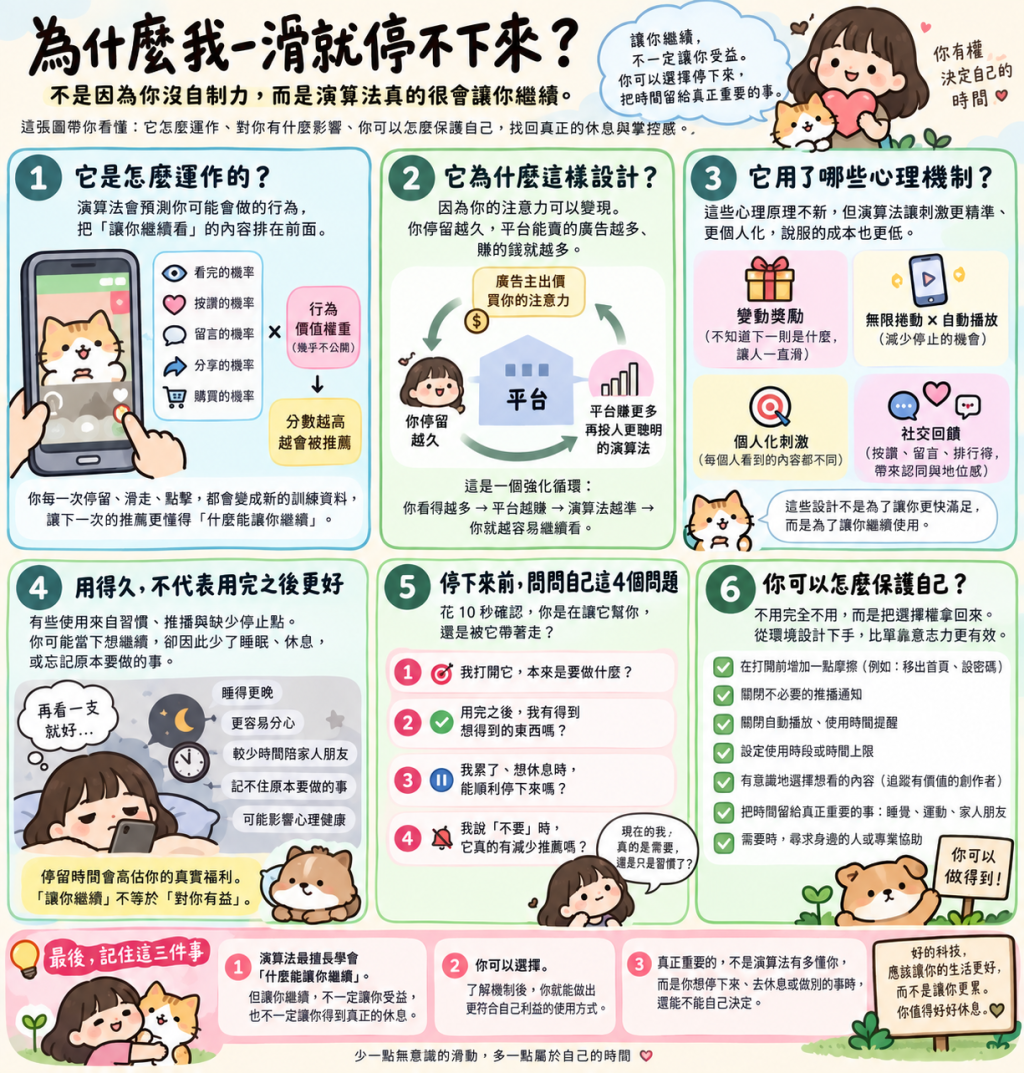
01. 萬物皆可公式化:預估機率 (P) × 價值權重 (V)
靠廣告盈利的社群平台,其核心商業模式可以簡化為:「盡可能拉長使用者的停留時間,藉此賣出更多廣告曝光。」
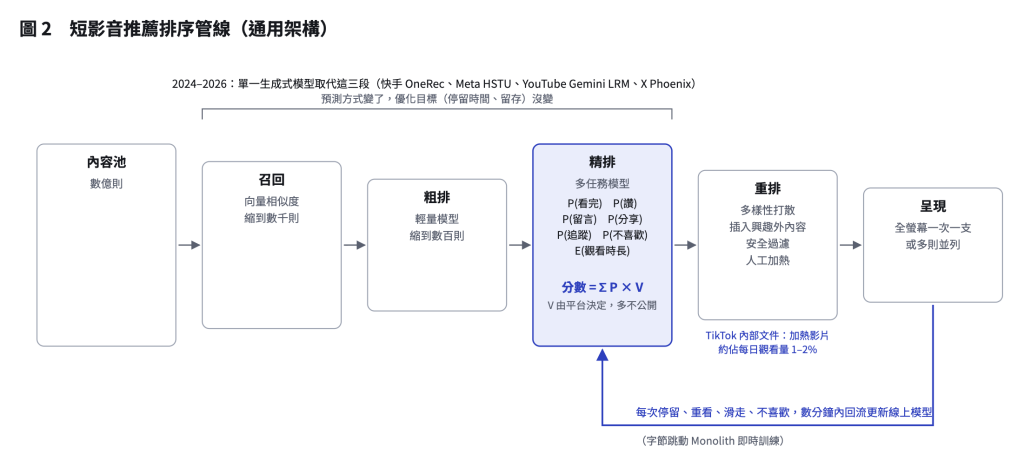
為了達到這個目標,平台在每次要決定下一則貼文前,都會計算一條基礎數學公式:
排序分數 = Σ (預估行為機率 P × 該行為的價值權重 V)
系統會先預測使用者對這篇貼文按讚、留言、分享、觀看或打賞的「機率(P)」,再乘上平台內部設定的「價值權重(V)」,兩者相乘後得分最高的內容,就會優先出現在螢幕上(Top-K)。
P 是模型的預測,不是中立的事實,本身就會有熱門度偏誤和回饋迴路。因此,最核心的差異,就在於平台想放大哪種行為?而演算法,只是用來達成 V 目標的機器。
02. 各大平台到底是如何操縱我們的注意力?目標函數與機制解剖
不同平台的目標設定與介面設計,造就了截然不同的資訊生態。以下透過公開資料,試圖還原這幾家平台的機制與演變:
Facebook:放大「憤怒」的權重拿掉之後,活躍度沒有下降
-
目標:極大化站內互動與停留時間。
-
機制與演變:根據 2021 年「Facebook 文件(Facebook Papers)」吹哨者揭露的內部報告,Meta 在 2017 年為了刺激互動,曾將包含「怒(Angry)」等表情符號權重,一律設定為一般「讚」的 5 倍;2018 年降為 4 倍。直到 2019 年的內部研究才發現,「怒」反應更常出現在錯誤資訊與有毒貼文上。
-
結果與修正:內部文件顯示,2020 年 9 月團隊將「怒」的權重直接調降為 0 之後,錯誤資訊與暴力內容減少。最關鍵的洞察是:權重調為 0 之後,平台的整體活躍度並沒有下降。 這顯示了產品經理在修正演算法外部性時,不一定非得犧牲活躍度。
X(Twitter):互動回饋會訓練發文者,排序系統會移動使用者關注的議題
-
目標:打造即時的公共廣場與激烈的言論交鋒。
-
機制與演變:根據馬斯克在 2023 年將 X 推薦演算法開源的程式碼顯示,如果貼文作者親自回覆留言,權重高達一般讚的 150 倍(到了 2026 年公開的預設值中,權重最高的變成「複製連結分享」,是讚的 40 倍)。
-
結果:讚與轉推本身就會把發文者訓練得更憤怒;可以推測,排序系統再給回覆、分享高權重,等於替這條迴路加速。根據 2021 年《Science Advances》針對 1,270 萬則 Twitter 紀錄的分析與模擬介面實驗,當使用者前一天獲得加倍的按讚與轉推時,隔天的憤怒表達會微幅增加約 2–3%。另外一項 2026 年發表於《自然》的大型實驗則發現,與單純的「按時間排序」相比,演算法推薦會把使用者關注的政策議題往保守方向推一小步,也改變了他們追蹤的對象;但黨派認同與對另一黨的敵意沒有變化。
TikTok:優化極致沉浸的代價:美國大學生中 60% 活躍用戶陷入「負福利」
-
目標:極致的沉浸感與無縫的注意力劫持。
-
機制:TikTok 介面的強大在於「全螢幕」。傳統動態牆一次顯示多則貼文,雜訊較高;全螢幕「一次一支影片」,讓每一次滑走或停留,都成為雜訊少得多的 「乾淨訓練標註(Clean Label)」 。而根據《華爾街日報》的機器人帳號實驗顯示,系統光靠「觀看停留時間」這單一指標,就能在數十分鐘到數小時內,收斂到研究者預先設定的興趣標籤。
-
結果:高參與度不等於對使用者有益。根據 Bursztyn 等人發表於 2025 年《美國經濟評論》的研究(樣本為美國大學生),若將「不用就會被社交排擠」的外部性算進去,60% 的 TikTok 活躍使用者是從產品中得到「負福利」的。另外,同一研究也發現,有 33% 的使用者表示,如果可以重新選擇,他們寧願 TikTok 根本不存在;如果大家約好一起停用,他們平均願意付 24 美元。這可能是因為害怕錯失交流話題,使得個體陷入了「集體行動的困境」:只要別人在用,自己就不得不跟著用。
Threads:強制抽離政治後,迎來的平衡點是「軟性流量誘餌」
-
目標:打造一個遠離政治與戾氣的「無害互動」空間。
-
機制與演變:根據 Meta 官方公告與 Instagram 負責人亞當・莫塞里(Adam Mosseri)的聲明,Threads 從 2024 年 2 月起不主動推薦未追蹤帳號的政治內容。針對後來平台上逐漸增加的「互動誘餌(Engagement Bait)」,Mosseri 於 2024 年 10 月表示正在設法控制。然而在 2025 年初,Meta 坦承壓抑政治的做法「相當粗糙」並逐步放回政治內容。到了 2026 年初,平台則開始逐步將廣告推廣至全球使用者。
-
結果:個人體感,Threads 早期的演算法特別像傳統的內容推薦,你喜歡看什麼主題,河道幾乎就完全充斥該主題,也更容易困在同溫層。確實,相較其他平台,Threads 河道上特別容易出現「生活或天馬行空的提問」、「有情緒共鳴的貼文」。這似乎反映了平台內容生態的某種自然演化;推測是,當平台抽離政治憤怒,系統與創作者便會尋找新的互動平衡點,進而催生出大量這類「軟性流量誘餌(Soft Engagement Bait)」來湊足停留時間。不過,隨著廣告逐步上線與官方打擊誘餌,Threads 終究還是在無害互動與商業變現之間,玩起了權重平衡遊戲。
對照組 Netflix:訂閱制的目標函數,才能「大致」與用戶福利對齊
-
目標:最小化退訂率(Minimize Churn Rate)。
-
機制:根據 Netflix 工程團隊(Gomez-Uribe & Hunt)發表的系統論文, 如果訂閱制平台只推薦熱門大片,觀眾看完後就會覺得「沒東西看」而取消訂閱。因此,Netflix 推薦系統的真正機制,是深入龐大且冷門的「長尾片庫」中,精準挖出符合個別特殊品味的作品。
-
結果:該論文指出,這套系統影響了約 80% 的觀看時數, 個人化讓「有效片庫」約是只照熱門度排序的 4 倍。 這套系統每年為公司省下超過 10 億美元的退訂損失。相較於純廣告制,訂閱制的目標函數「大致對齊」了使用者的長期滿意度(不過 Netflix 自 2022 年起也加入了含廣告方案,誘因已不再是純訂閱制)。
Spotify:平台要求音樂人降版稅,才能換取對聽眾「不標示」的推薦權重
-
目標:極大化播放總時長與無縫發現,並降低版權成本。
-
機制:Spotify 的核心體驗是「背景播放(Lean-back Experience)」,目標是讓聽眾順暢收聽而不按跳過。而根據《Music Business Worldwide》等產業報導,Spotify 在 2020 年 11 月以測試形式推出「Discovery Mode」機制——如果音樂人願意接受較低的版稅分潤(據報約少 30%),演算法就會在電台或自動播放中給予他們更高的推薦權重。
-
結果:這看似是一個極佳的
P × V 商業化案例,平台直接把「對平台的利潤貢獻」寫進了權重(V)裡。但這項機制推出後引發了強烈反彈,包括獨立廠牌的抗議,以及國會議員去信質詢。UMAW 等批評者指責這是變相的數位電台黑錢(Digital Payola);國會議員在質詢信中也警告,它可能讓音樂人陷入版稅逐底競爭(Race to the bottom)。然而這些反彈並沒有成功,Spotify 不僅沒有取消,還在 2023 年進一步擴大了這項功能。 對聽眾來說,目前依然沒有任何標示能看出哪些歌是「降版稅換來的推薦」,這正是平台將商業利益不透明地寫入演算法權重的一個赤裸的案例。
03. 為什麼我們停不下來?
如果 P × V 是系統端的引擎,那它究竟是勾住了大腦的哪個機制,才能讓人們在深夜裡像被催眠般無限滑動?這並非單一的心理學技巧,而是將「獎勵、觸發、移除停止線索」無縫接合成了一條神經迴路:
-
觸發端(Trigger):由外在的推播通知(Push Notification)將人拉回 App,接著透過情境觸發(例如排隊、無聊、甚至只是手機螢幕亮起),制約成一種自動化的習慣。
-
停止端(Stopping Cues)的消失:這是最危險的一環。傳統的媒介(如報紙的底版、電視節目的片尾)都有天然的「停止線索」,但在「無限捲動(Infinite Scroll)」與「自動播放(Autoplay)」的設計下,這些煞車被全數拔除。
-
獎勵端(Reward)與預測誤差:神經科學中的「獎勵預測誤差(Reward Prediction Error, RPE)」理論指出,多巴胺神經元對意料之外的獎勵反應最劇烈。舒爾茨(Wolfram Schultz)團隊 2003 年的猴子實驗更進一步把獎勵機率從 0 調到 1,發現機率 0.5、也就是最不確定時,多巴胺神經元的持續活動最高。這正是「變動回報(Variable Reward)」的處境:滑動者不知道下一支影片是無聊還是爆笑。雖然目前沒有直接量測人類滑手機時的多巴胺,但這種不確定性確實會驅動對回報強烈的「想要(Wanting)」,即便這並不等於真正「喜歡(Liking)」這些內容。
當大腦受制於對不確定回報的「想要」,而系統又永遠不給予結束的提示時,使用者就會進入歐盟監管機構所稱的「自動駕駛模式(Autopilot Mode)」,在恍惚中流失數小時。
04. 為什麼靠意志力戒社群很難撐住?消費者該如何反向操作?
戒斷不是不可能。史丹佛大學經濟學家亨特・奧爾考特(Hunt Allcott)等人在 2018 年隨機付錢請一群美國使用者停用 Facebook 4 週,停用組的主觀幸福感確實提升,實驗結束後也用得比以前少。但他們大多還是回到了 Facebook。另一項請受試者封鎖手機行動網路兩週的實驗,也只有約四分之一的人做到。所以比起一次戒乾淨,更實際的是循序漸進,把環境調成「比較難滑下去」:
-
與其打開後再忍,不如讓它難打開:不要相信自己能「看到一半立刻關掉」。有研究追蹤 280 名
one sec 使用者,這類工具會在打開 App 前強制停頓、深呼吸,6 週下來,開啟 App 的嘗試減少約 57%。我自己的做法是把不想常用的 App 藏到比較深的地方,要多點好幾下才打得開,用量也明顯下降。
-
打開了也別責備自己,罪惡感常常有反效果:滑了一小時之後罵自己「連這都管不好」,很容易變成「反正都破功了,乾脆繼續滑」。
- 多倫多大學心理學家珍妮特・波利維(Janet Polivy)把這種全有或全無的反應叫做「管他的效應」(what-the-hell effect)。這種現象最早在節食研究裡被觀察到:赫曼(Peter Herman)與麥克(Deborah Mack)1975 年讓受試者先喝奶昔,再參加冰淇淋「試吃」。平常沒在節食的人喝過奶昔後吃得比較少;正在節食的人反而比沒喝奶昔時多吃了約三分之二。破戒一次,反而讓人放棄自我控制。
- 反過來,加拿大卡爾頓大學的沃爾(Michael Wohl)與皮秋(Timothy Pychyl)等人追蹤 134 名大一新生,發現第一次期中考前拖延、事後原諒自己的學生,第二次期中考前比較不拖延。
- 所以比起追求完全不碰,更好的做法是一步步減少:先設一個時間,或者換一個沒那麼舒服的姿勢滑,例如站著、邊運動邊看,讓自己比較容易停下來。
-
主動「反向訓練」動態牆:演算法會記下每一次停留與點擊。與其被動防守,不如主動出擊:刻意去搜尋、停留、按讚或儲存你真正想多看的內容,推薦就會逐漸往這些主題靠。但要小心,演算法優化的終究是「你會不會留下來互動」,訓練得越好,它越能留住你,使用時間可能反而增加。所以這一招要和第一點的「打開前阻斷」搭配使用。
其他小技巧:
-
按「不要推薦此頻道」,而不是「不感興趣」:根據 Mozilla 在 YouTube 上的研究,「不感興趣」只擋掉約 11% 的類似推薦,「不要推薦此頻道」約 43%。
-
切換時間序有得有失:Facebook 的實驗顯示,把動態改成時間序之後,使用時間確實大幅下降;但時間序不會過濾來源品質,不可信來源的曝光反而增加 68.8%。X 的實驗也發現,演算法期間新增的追蹤關係,關掉演算法後仍然留著。所以切換時間序之後,記得一併清理追蹤名單,才能真正拿回策展權。
然而,在談「反向操作」時,其實會遇到一個更深層的難題:我們真的清楚自己想要什麼嗎?
有研究顯示,演算法(如 YouTube 推薦)很多時候只是延續我們原本的偏好;也有實驗(如 X 的動態排序)證明,演算法確實能微幅改變使用者關注的政策議題。無論是狂熱地追星、嗑 CP,還是出於焦慮一直去看自己討厭的言論,我們其實都在用行動告訴系統:「多給我這類內容」。
在責怪演算法劫持注意力的同時,如果我們沒有先釐清自己真正想要的是什麼,最後被系統無限放大、不斷餵養的,或許也包括人性底層的貪嗔癡。
05. 當「追求留存率」造成外部傷害,產品經理該如何抉擇?
不可諱言,在產品生命週期早期,PM 的首要任務是追求規模化與留存率,利用心理學機制來推升數據是常見的做法。
唯數據論的盲點:不知不覺的品牌透支?
現實情況是:有一項關於線上資料保護方案的實驗顯示,推銷時溫和的「暗黑模式(Dark Patterns)」能讓付費方案接受率從 11.3% 升到 25.8%,而且在漏斗數據上中途退出的人數極少,也測不出惱怒。除了推銷型,退訂型也極為氾濫;大家是不是也遇過,想退訂時遇到重重阻撓、甚至有些連退訂按鈕都很難找?FTC 與國際消費者保護執法網絡在 2024 年調查 26 國、642 個訂閱型網站與 app,約 76% 至少使用一種暗黑模式。
但數據沒測到反彈,不代表使用者沒有察覺或沒有受傷。 許多使用者即便當下摸摸鼻子付了錢,心裡也可能對品牌產生長期的不信任。如果團隊只看眼前亮眼的 P × V 數據、把機制催到極限,而忽略了這會透支無形的品牌信任,最終往往會引來法規的強制介入。
例如,2026 年 3 月,洛杉磯陪審團首次認定 Meta 與 YouTube 在通知、按讚數、外貌濾鏡等功能的設計上有過失;而歐盟已依《數位服務法(DSA)》初步認定,TikTok 與 Meta 的無限捲動、自動播放等成癮設計違反規定。這些都釋出了非常明確的信號:利用心理弱點過度劫持注意力,已經開始被視為平台必須負責的「設計問題」。
參與度與用戶福利的終極拉扯
產品策略的真正考驗,在於看穿指標被推升的代價。短期參與度(Engagement)與長期用戶福利(Welfare)之間往往存在落差—— 核心的區別在於,這究竟是「使用者主動發起的任務」,還是「系統製造的下一個(其實不存在的)需求」。
雖然在大公司與現實的商業壓力下,單一個體不一定能完全實踐這樣的理念,妥協也往往難以避免;但是,將這份認知與「演算法的副作用」放進團隊的視野,或許是當代產品經理能為用戶多做的一點把關。
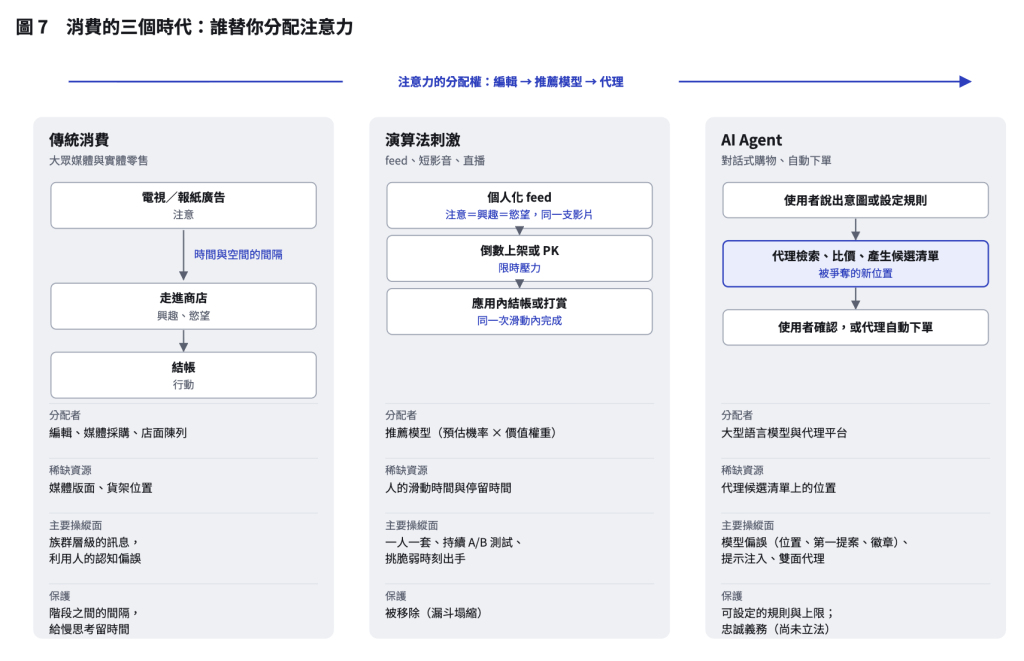
代理時代:注意力的爭奪,從眼球移到模型的候選清單
更務實地說,這套遊戲規則即將發生典範轉移。當然,人類還是會親自滑社群媒體、還是會因為渴望刺激而被娛樂內容吸引;但在許多高價值的場景中——例如購物決策、資料爬梳、新聞策展——使用者會開始把「注意力過濾」的工作委託給 AI Agent。當我們習慣與 Agent 進行原生的深度協作時,注意力爭奪的戰場,就會從「人類的眼球」移到「模型的候選清單」。
也就是說,贏得 Agent 的信任是下一階段的關鍵。
雖然我們無法用紅點通知去劫持一個沒有情緒的模型,但操縱手法並未消失,而是轉向利用模型的位置偏誤(容易過度重視出現在提示詞開頭或結尾的資訊)、第一提案偏誤(傾向直接接受並偏好最先出現的選項)、營造「權威」與「社會認同」這類經典說服手法,以及提示注入(Prompt Injection)等方式,來影響 Agent 的最終選擇。
核心關鍵:AI 代理是否具備「忠誠義務」?
這背後有一個常被忽略的前提與防線:代理應對使用者負有「忠誠義務(Duty of Loyalty)」。
所謂的忠誠義務,是指 Agent 必須不受未揭露的利益衝突影響,不能私下圖利平台或第三方。
雖然,目前各主要市場都還沒有法律要求個人 AI 要負擔此義務,市場的發展方向也正好相反,例如:部分 AI 伴侶 app 開始對使用者進行情緒操縱、用按讚訓練的模型也容易變得諂媚、另一方面,ChatGPT 在 2026 年也開始在部分國家的免費方案中測試與上線廣告(OpenAI 表示廣告與回答分開且會標示、不影響回答,但目前沒有外部稽核)、這可能讓它逐步成為同時服務使用者與廣告主的「雙面代理」——表面上幫你找答案,實際上可能暗藏著付費推薦。
但,老實說,如果 Agent 沒有忠誠義務的克制,它就只是另一個披著對話皮的推薦引擎。
內容生態的洗牌:信賴度將取代流量誘餌
不過這場新戰局也並非只有悲觀的一面。當模型越來越被要求引用可信來源,且使用者能對 Agent 下達明確的任務條件時、個人 Harness 產品也越來越成熟時,過去那套單純依賴「情緒煽動與流量誘餌」的內容農場,可能就會因為被模型判定為低信賴度來源,而面臨被降權或過濾的風險。
可以預期的是,在代理時代,推薦與排序的邏輯正在經歷一次洗牌。即使操縱的手段依然存在,演算法爭奪注意力的手段,將走向截然不同的下一代競爭。



 iThome鐵人賽
 看影片追技術