
昨天最後我們提到在 SQLite 資料庫的 gen_metadata 看到 data 欄位裡塞滿了 12 02 ... 這類十六進位位元組。雖然推測它可能是 Google Protocol Buffers(Protobuf)的編碼格式,但最尷尬的問題是我們沒有這段資料的 .proto 定義檔。沒有 schema 或型別定義的話,檔案裡面的數值或欄位具體代表什麼意義就會無從得知。但 Antigravity CLI 自己在跑任務時,還是要能 Decode 啊!既然能把每一步的 Token、快取用量算出來秀給我們看,就表示 解碼這段資料的結構與線索,一定寫在我們電腦裡的 agy 執行檔裡。 那我們有沒有辦法從這個執行檔裡面觀察出些什麼呢?
第一步就是先找到 agy 的本機路徑,可以透過下方指令來找:
which agy
因為 agy 是用 Go 語言編譯出來的二進位程式,Go 在編譯時通常會保留型別資訊,甚至內嵌完整的 Protobuf Descriptors,賺到。我們可以直接透過 strings 來過濾一下關鍵字看看:
strings $(which agy) | grep "\.proto"
當然是會回傳非常多結果,這不用擔心,可以請 Antigravity CLI 來幫忙分析:
third_party/jetski/cortex_pb/cortex.proto
third_party/jetski/cortex_pb/options.proto
third_party/jetski/cortex_pb/custom_extensions.proto
如果繼續請 Antigravity CLI 更深入追下去,把關鍵字限縮到 ModelUsage 或 ChatModelMetadata 等 Module Name 的話:
strings $(which agy) | grep -E "ChatModelMetadata|ModelUsage" | head -n 5
會看到一些 Package 名稱完整印了出來:exa.cortex_pb.ChatModelMetadata 或是 exa.cortex_pb.ModelUsage。我們大概能推測:Antigravity 在底層與 Google 溝通時,定義了一套名為 cortex 的內部 Protobuf 協議,而模型調用的遙測數據正是透過它序列化後寫入 SQLite 的。
不過就算知道了它叫 cortex.proto,我們手頭上終究沒有真正的 .proto 原始碼。那沒有定義檔,到底能不能解碼?答案是可以的。
這要回到 Protobuf 本身的底層設計。Protobuf 為了追求極致的傳輸效能與體積最小化,在二進位串流中是完全不儲存欄位名稱(像是 cached_tokens 這種字串)的。它只為每個欄位編排一個整數編號(Field Number)。當資料被 Encode 時,每個欄位的開頭都會是一個稱為 Tag 的整數:
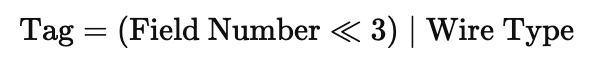
0(Varint):可變長度整數(包含 int32、int64、bool、enum)。2(Length-delimited):帶長度前綴的位元組陣列(用來裝字串、二進位 BLOB,或是巢狀的子 Message)。所以即使我們完全不知道某個欄位的名稱或業務語意,只要順著每個 Byte 一路讀取 (Field Number, Wire Type, Value),仍然可以把整份二進位資料拆解成完整的樹狀結構。也確實有套件已經可以為我們做到這件事,例如 Google 官方的 google.golang.org/protobuf/encoding/protowire,它專門提供低階 Wire Format 的解析函式(如 ConsumeTag、ConsumeVarint),不需要 .proto 描述檔就能拆解出欄位編號與數值。
我們可以(請 Antigravity CLI)寫個小腳本,用 Google 官方的 protowire 套件把 SQLite 裡的這筆 BLOB 讀出來解碼,印出來看看它裡面會長什麼樣子,我們能從中解讀出哪些內容。我們用 protowire 寫一個簡單的走訪邏輯,只要遇到 Varint 就印出整數數值,遇到 Bytes 就嘗試往下拆解成子 Message:
package main

import (
	"database/sql"
	"fmt"
	"log"
	"strings"

	"google.golang.org/protobuf/encoding/protowire"
	_ "modernc.org/sqlite"
)

// 遞迴走訪 Protobuf Wire Format 並印出階層結構
func dumpWire(data []byte, depth int) {
	indent := strings.Repeat("  ", depth)
	b := data
	for len(b) > 0 {
		// num: 欄位編號 (Field Number, 如 Field 1, 4)
		// typ: 傳輸型別 (Wire Type, 如 0=Varint, 2=Bytes)
		// n:   讀取此 Tag 消耗的位元組數 (若 < 0 代表解析完畢或格式錯誤)
		num, typ, n := protowire.ConsumeTag(b)
		if n < 0 {
			break
		}
		b = b[n:] // 游標跳過 Tag,移到 Value 的開頭

		switch typ {
		case protowire.VarintType:
			val, m := protowire.ConsumeVarint(b)
			if m < 0 {
				return
			}
			b = b[m:]
			fmt.Printf("%s• Field %d (Varint): %d\n", indent, num, val)

		case protowire.BytesType:
			bytesVal, m := protowire.ConsumeBytes(b)
			if m < 0 {
				return
			}
			b = b[m:]
			// 如果開頭可以解析出合法的 Tag,代表它是巢狀的子 Message
			if len(bytesVal) > 0 && isLikelyMessage(bytesVal) {
				fmt.Printf("%s• Field %d (Message, %d bytes):\n", indent, num, len(bytesVal))
				dumpWire(bytesVal, depth+1)
			} else {
				fmt.Printf("%s• Field %d (Bytes): len=%d\n", indent, num, len(bytesVal))
			}

		default:
			m := protowire.ConsumeFieldValue(num, typ, b)
			if m < 0 {
				return
			}
			b = b[m:]
		}
	}
}

func isLikelyMessage(b []byte) bool {
	_, _, n := protowire.ConsumeTag(b)
	return n > 0
}

func main() {
	// 唯讀開啟 SQLite
	db, err := sql.Open("sqlite", "file:./conversations/test.db?mode=ro")
	if err != nil {
		log.Fatal(err)
	}
	defer db.Close()

	var blob []byte
	err = db.QueryRow("SELECT data FROM gen_metadata WHERE size > 0 LIMIT 1").Scan(&blob)
	if err != nil {
		log.Fatal(err)
	}

	fmt.Println("=== protowire 解碼 raw output ===")
	dumpWire(blob, 0)
}
執行這個小腳本後,終端機會吐出整筆二進位資料的完整結構:
=== protowire 解碼 raw output ===
• Field 1 (Message, 856 bytes):
  • Field 1 (Bytes): len=482
  • Field 2 (Message, 120 bytes):
  • Field 4 (Message, 64 bytes):
    • Field 1 (Varint): 1298
    • Field 2 (Varint): 1420
    • Field 3 (Varint): 850
    • Field 5 (Varint): 12580
    • Field 7 (Bytes): len=18
    • Field 9 (Varint): 356
  • Field 8 (Message, 140 bytes):
  • Field 9 (Message, 45 bytes):
透過 protowire 這套工具,雖然每個欄位名稱我們還是無從得知,只能知道數字代號(Field 1, Field 4, Field 2),但至少我們能更清楚看到 gen_metadata 的 BLOB 裡面的架構了!剩下的問題就是要怎麼猜這些欄位的意義了!
現在結構印出來了,但面對這一堆數字,我們怎麼知道每個欄位的具體意義呢?有個簡單的做法就是叫 Antigravity CLI 出來分析,分析每個欄位對應我們在執行檔發現的一些敘述,來推測哪些編號可能對應哪些欄位。因此,我們再把剛剛第一小節找到的線索拿出來對照:
agy 執行檔中找到了 exa.cortex_pb.ChatModelMetadata 與 exa.cortex_pb.ModelUsage 這些 Message 名稱。Field 1(856 bytes 的子 Message)正是根結構 ChatModelMetadata。Field 4(64 bytes),型別結構完全對應到 ModelUsage(模型使用量)!接著再透過 Antigravity 在終端機進行的幾次對話,觀察送出不同長度的文字前後,這些欄位數值的變化規律:
Field 2 就會等比例變大 $\to$ 代表 未快取輸入 Token(UncachedPromptTokens)。Field 5 突然變得很大 $\to$ 代表命中了 Google Prompt Caching 的 快取 Token(CachedContentTokens)。Field 3 就會出現幾百到幾千的數字 $\to$ 代表內部推論所消耗的 思考 Token(ThinkingOutputTokens)。Field 9 的數字剛好對應回答的長度 $\to$ 代表實際回覆的 文本輸出 Token(OutputContentTokens)。以上這些都是透過對照來推測與觀察的,並沒有實際證據。但即便只是推敲,也還是能作為一個參考,透過多輪對話的資料,信心度也會逐漸增加。原本沒有欄位名稱的二進位資料,每個數字的真實語意就能漸漸浮現出來:
RootEnvelope (SQLite gen_metadata.data)
└── Field 1: ChatModelMetadata
    ├── Field 1: SystemPrompt (系統提示詞)
    ├── Field 2: MessagePrompts (對話歷史歷程)
    ├── Field 4: ModelUsage (模型用量計費資訊)
    │   ├── Field 1: ModelCode (模型代碼,如 1298)
    │   ├── Field 2: 1420  -> 未快取輸入 Token (Uncached)
    │   ├── Field 3: 850   -> 思考推論 Token (Thinking)
    │   ├── Field 5: 12580 -> 快取命中 Token (Cached)
    │   └── Field 9: 356   -> 文本輸出 Token (Output)
    ├── Field 8: Tools (載入的工具定義)
    └── Field 9: ChatStartMetadata (上下文長度與檢查點)
從原本只能看著終端機黑底白字瞎猜模型有沒有命中快取、猜這次對話到底花了多少額度,到現在透過:
brain/ 的 transcript_full.jsonl:拿到了每一次對話的 Prompt、思考歷程與工具呼叫原始輸出。conversations/<UUID>.db:拿到了完整的狀態推進狀態機與時間序列。gen_metadata 二進位解碼:拿到了 Token 與快取計費數據。原本散落在本機這三個地方的資料,終於被我們摸得清楚。既然這些底層數據都在我們本機,那我們有機會把它做成觀測工具,讓我們更清楚了解 Token 的使用狀況呢?


 iThome鐵人賽
 看影片追技術