
經過前幾天的探索,我們已經大致掌握 Antigravity CLI 在本機保留了哪些資訊,其中包含三種資料來源:brain/ 的 JSONL 軌跡、conversations/ 的 SQLite 狀態機,以及 DB 裡面我們從二進位 BLOB 解出的 Token 使用帳單。昨天的最後我們提到,既然數據都在我們本機找得到,那我們有機會實作一個 AI Agent 觀測器以方便我們更容易觀察使用狀況嗎?或許可以。
首先,我決定將這個工具命名為 Heimdall(海姆達爾),別問我為什麼,我已經快忘記了。大概就是在北歐神話中看守彩虹橋、擁有全知全視的神,感覺視力很好很會觀察的樣子。
沒錯!這個你看了連續四天卻不知道到底是什麼意思的名詞 Heimdall,今天終於揭曉啦哈哈~
先對焦一下我對於 Heimdall 的期待。我所預期的 Heimdall 可能有幾個功能:
| 功能艙 | 核心任務 | 解答的問題 |
|---|---|---|
| Dashboard(儀表板) | 成本與快取總覽 | 每一輪 Prompt Caching 省了多少錢?累積花了多少美金? |
| Step Timeline(步驟軌跡) | 審視執行步驟 | 每一步思考了什麼?呼叫了哪條工具指令?耗時多久? |
| Context Payload(脈絡載荷) | 上下文理解 | 系統提示詞、規則(AGENTS.md)長怎樣?對話歷史各自吃掉多少 Token? |
目標確立後,首要面臨的是架構挑戰。我們手頭上有的資料,資料型態各異,包含:
最直接暴力的做法就是在 UI 渲染層一邊讀檔案、一邊查 SQLite、一邊做 Varint 解碼,但這樣其實很快就會發現系統容易面臨幾個缺陷:
因此,理想上能遵循 關注點分離(Separation of Concerns;SoC) 的原則:解碼底層檔案的人專注解讀單一種資料來源,彙整資料的人專注整理多個資料來源整理的資料,渲染的人專注畫面呈現,互動的人專注行為邏輯。彼此負責各自的職責範圍,也只關注自己負責的範圍。
負責對接外部 Agent Harness 工具資料,將本機不同來源的檔案轉換為統一結構:
Parsers:負責單一資料來源解析,分別處理 JSONL 文字串流、SQLite 狀態機與 Protobuf 二進位串流。SessionStore:三種檔案在本機並非同一時間寫入。Store 負責吸收落盤時間差,依 Step Index 將文字、狀態與 Token 對齊合併成「完整且唯一的」Step 資料。SessionSupervisor:在背景監聽本機目錄與 WAL 變化。一旦偵測到 Agent 產生新步驟,立刻觸發增量載入,並主動推播通知前端刷新畫面。完全獨立於底層儲存與介面呈現,只專注於資料標準化與邏輯運算:
Canonical Session:定義 Heimdall 中通用的資料結構,抹平不同 Agent Harness 之間的欄位命名差異。QueryService:負責封裝讀取與查詢邏輯,對外提供統一的查詢介面,讓 UI 能直接取得所需的資料。AnalysisService:負責執行商業分析與狀態檢查,計算模型花費與快取折扣等等。從最 High Level 的角度來看,資料流向大概會是這樣:
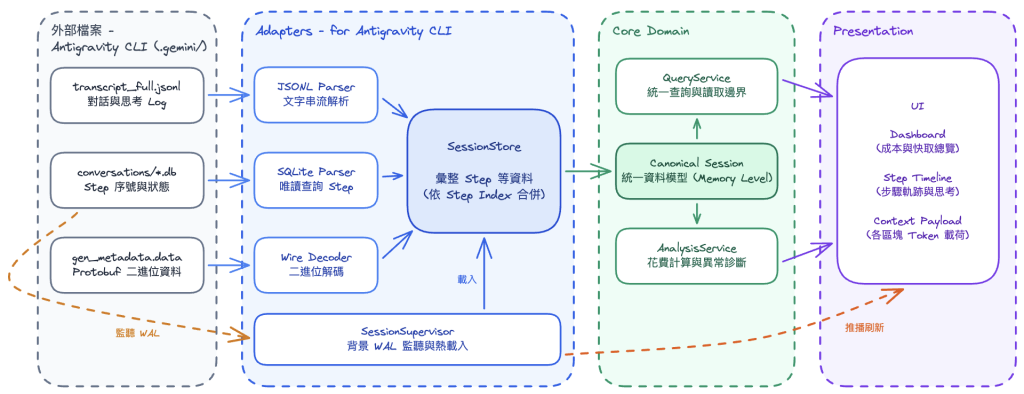
這樣的分層隔離其實能為我們帶來一些好處,例如:我們如果想要再針對 Antigravity CLI 以外的 Agent Harness(Codex CLI、OpenCode 等),我們只需要把 Adapter 層抽換就可以了。另一個好處是可以抽換 UI 的呈現方式,例如:Web 呈現或是 TUI 等等,也只需要把渲染層抽換掉,但背後的資料搜集邏輯修改幅度可以非常少。這套架構看似多了幾層轉換,但在面對異質儲存與動態呈現時,能為我們換來穩定性與擴展彈性。


 iThome鐵人賽
 看影片追技術