
前面幾篇介紹過,Berry AI 的 Vision AI 會判斷每台車何時排隊、點餐、取餐。客戶需要在同一個介面查看各店的營運指標,因此有了 BI 動態看板 (dashboard)。
從車輛資料算出營運指標的這段計算,後來從 6,000 行手寫的 Python 遷移到 dbt。今天說明這次遷移的原因與做法。
BI 動態看板剛起步時,計算營運指標的程式碼隨著門市需求逐步累積,最後達到 30 個檔案、共 6,000 行 Python。每支援一種車道配置,幾乎就多一個檔案:單車道、雙車道、縱列 (tandem) 車道,以及是否有店員到車道邊點餐 (line busting),這些配置的排列組合直接反映在檔案結構上。
為了抽象化這些計算中反覆出現的集合操作,我們自行實作了 FList,把 Scala collections 的函數式程式設計 (functional programming) 寫法帶進 Python。整個 metrics 模組由 map、filter、group_by 等操作一路串接而成:
combined_results = (
    FList(grouped_results.values())
    .flatten()
    .group_by(0)
    .map_values(lambda x: FList(x).map(1).to_list())
    .to_dict()
)
系統先算出每 15 分鐘的統計值,再往上合併成每小時、每日、每週與每月。這些累積與合併的規則,都由團隊自行維護。
這套系統支撐了公司前幾年的 BI 動態看板與 email 報表。但隨著需求累積,修改它的成本越來越高,主要原因有兩個。
首先是不易除錯。鏈式操作的底層是產生器 (generator),資料在取值時才逐筆產生,而且只能走訪一次。直接 print 看不到其中的資料,為了檢視而取值,又會消耗掉後續步驟需要的資料,因此我們另外實作了 .print() 方法輔助除錯。要追查一個數字的計算過程,必須在一長串 map 與 group_by 之間逐層回推。
其次是測試不足。營運指標的計算出錯時,程式不會報錯,只會輸出錯誤的數字,而這些數字正是客戶最在意的資訊。缺少足夠的測試,每次修改都可能在無人察覺的情況下改變輸出結果。
後來我們決定把 BI 動態看板改用開源 BI 平台 Superset 的嵌入式看板 (embedded dashboard)。原本的流程由 Python 算完營運指標,再以 JSON 交給前端;改用 Superset 之後,需要準備 Superset 可以直接查詢的資料表,Superset 稱之為 dataset。
我們藉這個機會用 SQL 重寫計算邏輯。SQL 檔案增加之後,執行順序與依賴關係也需要管理,例如每日的營運指標,必須等它依賴的資料表都更新完成才能計算。我們選擇以 dbt (data build tool,以 SQL 定義資料轉換的工具) 處理這部分。
在 dbt 裡,一個 SQL model 就是一個 .sql 檔,以 select 敘述描述要產出的資料。執行 dbt run 時,dbt 會依設定建立或更新對應的資料表 (table) 或檢視表 (view),實際的計算則交由 PostgreSQL 執行。
dbt 也提供文件產生與測試功能,定位上接近 SQL 專案的建置系統 (build system)。
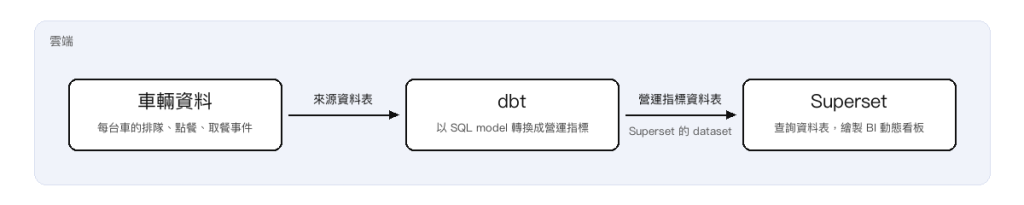
整體流程因此簡化成三步:車輛資料進入資料庫,dbt 把它轉換成營運指標,Superset 再查詢 dbt 產出的資料表。
先看一個容易算錯的地方。假設同一間門市有兩筆 15 分鐘資料:
| 時段 | 點餐筆數 | 平均點餐時間 | 平均值 × 筆數 |
|---|---|---|---|
| 12:00–12:15 | 10 | 30 秒 | 300 |
| 12:15–12:30 | 90 | 90 秒 | 8,100 |
直接把平均值再取平均,會得到 (30 + 90) / 2 = 60 秒。但第二個時段的車輛較多,合併後應該是 (300 + 8,100) / (10 + 90) = 84 秒。
因此從 15 分鐘往上聚合時,分子與分母必須分開保留,到最後一步才相除。我們在 dbt 裡的做法是先把來源的平均值乘上筆數,還原成秒數總和,再交給後續的 model 加總。
以下範例簡化了實作中的命名與中間步驟,並假設時間已轉換為門市當地時間。第一個 model 先算出可供加總的秒數:
-- models/metrics_15min.sql(示意)
select
    id,
    datetime,
    order_avg_seconds * order_count as order_seconds_sum,
    order_count
from {{ source('upstream', 'metrics_15mins') }}
source() 讀取既有的來源資料表,下一個 model 再用 ref() 引用這份結果,算出每日平均:
-- models/metrics_daily.sql(示意)
with daily as (
    select
        id,
        date_trunc('day', datetime) as date,
        sum(order_seconds_sum) as order_seconds_sum,
        sum(order_count) as order_count
    from {{ ref('metrics_15min') }}
    group by 1, 2
)
select
    *,
    case
        when order_count = 0 then 0
        else order_seconds_sum / order_count
    end as order_avg_seconds
from daily
ref() 同時宣告了依賴關係,dbt 因此知道要先建立 15 分鐘的 model,再建立每日的 model。分母為零時回傳 0,與實際實作一致。
實際專案還會處理門市時區、餐期 (daypart)、營業時間與車道設定,並提供不同時間粒度的 dataset。
前面提到的兩個維護問題,在 dbt 裡各有對應的機制。
除錯方面,ref() 宣告的依賴關係會呈現在 dbt 產生的血緣圖 (lineage graph) 中。每日數字有誤時,可以沿著血緣圖回查 15 分鐘資料與來源。相較於在 generator 鏈中逐層追查,現在能先確定要檢查哪一張資料表。
測試方面,單元測試 (unit tests) 以固定的車輛事件與門市設定作為輸入,驗證計算結果。我們另外比對新舊兩套計算的輸出,記錄兩者之間的已知差異。資料測試 (data tests) 則檢查資料內容,例如門市 ID 不能為空、星期值必須落在 1 到 7。
這次遷移把營運指標的計算從 FList 鏈式操作改寫成 SQL,由 dbt 管理執行順序與依賴關係,Superset 直接查詢 dbt 產出的資料表。往上聚合時,分子與分母分開保留,到最後一步才相除。ref() 宣告的依賴形成血緣圖,每日數字有誤時可以逐層回查來源;單元測試與資料測試則分別驗證計算結果與資料內容。
工程師仍然要負責把數字算對,但計算邏輯有固定的位置可以查,依賴關係也可以追。每次需求變動時,重新理解、修改與確認整套計算的成本因此降低。新舊兩套計算之間仍有已知差異,目前透過新舊資料比對記錄下來。
明天的 Day 22 介紹如何把 Superset 看板轉成 PDF,寄到客戶信箱。
source()
ref()
本系列由 Berry AI 工程團隊出品。更多工程實戰紀錄都在 Berry AI 技術部落格。


 iThome鐵人賽
 看影片追技術