
前面五層,我每次攔到的都是一張單:一個 tool_use、一個 tool_result(第 16 篇)。但真的叫 Claude Code 做一件事,它不會只開一張單。我請它數三個 .py 檔的行數、加總、寫進檔案,它一連開了六張單才停。這六張單是怎麼接起來的,中間是誰在決定「再來一次」還是「夠了,可以回答」?
先講結論:代理(agent)說穿了就是一個 while 迴圈。 把脈絡送給模型,模型回一則。如果它開了工具單,就跑工具、把結果接回對話、再送一次。直到某一則沒有工具單,迴圈才停,那一則就是答案。模型本身是無狀態的(第 13 篇),這圈外面的迴圈,才是我們叫的「代理」。
一個資料夾,三個檔案:alpha.py(5 行)、beta.py(4 行)、gamma.py(9 行)。我給 Claude Code 一句話:「每個 .py 檔各有幾行?算出總行數,寫進 total.txt,然後告訴我總數。」然後用 stream-json 把每一輪都接出來(2026-10-05,Claude Code,claude-opus-5-5):
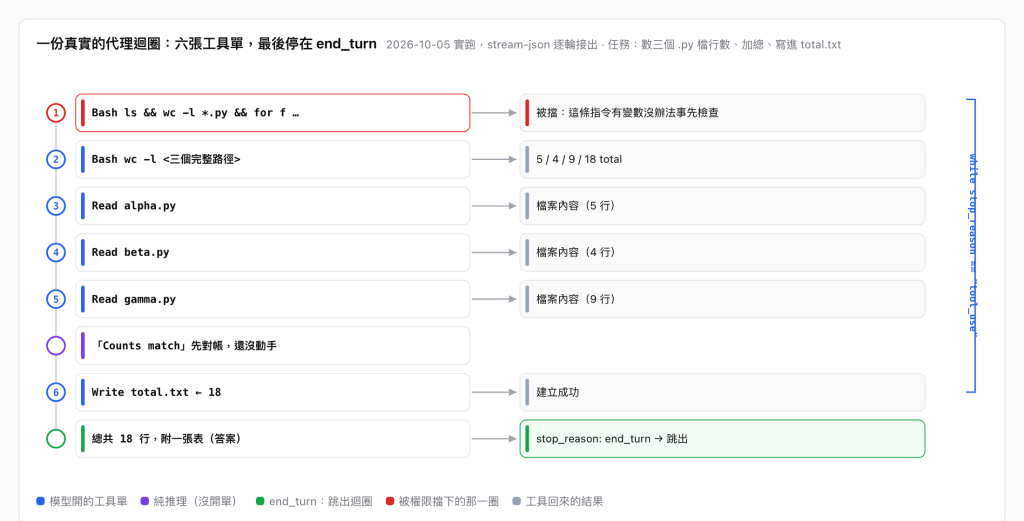
六張工具單,中間夾著一句推理,最後一則才是給我的答案。(只跑一次,是例子不是證據。)三件事值得停下來看:
這不是我腦補的形狀,是官方寫死的。Claude 的 tool-use 文件直接說:這個迴圈「最典型的樣子,就是一個以 stop_reason 為條件的 while 迴圈」(2026-10-05 查)。它列的步驟是這樣:
tools 陣列和使用者訊息送出一次請求。stop_reason 是 tool_use,附一個或多個 tool_use 區塊。tool_result。tool_result 的使用者訊息,合起來再送一次。stop_reason 還是 tool_use,就回到第 2 步。寫成程式就是這麼一小段:
messages = [user_message]
while True:
    reply = model(messages, tools)      # 送出整段對話
    messages.append(reply)
    if reply.stop_reason != "tool_use": # end_turn:這一則就是答案
        break
    results = [run(call) for call in reply.tool_calls]
    messages.append(results)            # 把工具結果接回去,再轉一圈
文件說得很白:只要 stop_reason 是 tool_use 就繼續,碰到別的(end_turn、max_tokens、stop_sequence、refusal)就跳出去。 我那次實驗攔到的最後一則,stop_reason 正是 end_turn,所以迴圈停了。中間開工具的那幾則,文件說是 tool_use。「代理」這個詞聽起來很大,拆開來就是這個 while。
一個 while 迴圈,為什麼配叫「代理」?差別不在迴圈本身,在誰決定下一步。
Anthropic 在〈Building effective agents〉裡把兩種東西分開:工作流程(workflow)是「LLM 和工具照預先寫死的程式路徑被編排」,代理(agent)則是「LLM 自己動態決定流程和工具用法,掌握要怎麼完成任務」。同一篇也說,代理「說穿了通常就是 LLM 根據環境回饋、在一個迴圈裡使用工具」(2026-10-05 查)。
這條線在那份軌跡裡看得到。第 1 張單被擋下時,沒有人告訴它改用完整路徑,是它自己讀了錯誤訊息、換了寫法。要是這段是我寫死的腳本,ls && wc 失敗就是失敗,腳本不會自己長出第二種方法。是模型在每一圈重新決定下一步,這個 while 才從「自動化」變成「代理」。
所以代理的「自主」沒那麼玄:每一圈「開哪張單、還是收尾」的那個決定,是模型下的,不是你寫死的。 能力來自模型,那份自主,來自你把決定權交給了迴圈裡的它。
迴圈的骨架是機械的,但每一圈裡「先想再做」這件事有來頭。2022 年 Yao 等人的 ReAct(ICLR 2023)講的就是這個:讓模型同時產生推理軌跡和行動,兩者交錯。他們的說法是,推理幫模型規劃、追蹤進度、處理例外,行動則讓它去接觸外部來源,把真實資訊帶回來餵給下一步的推理。
實驗裡那句「Counts match」就是一次推理,夾在讀完三個檔和寫檔之間。它沒有讀完就急著寫,而是先在心裡對了一次帳。這一圈的輸出(想法加動作),又變成下一圈的輸入。
有一件事這段程式碼藏著,值得挑明:每一輪,送進模型的是整段 messages,不是只有新的那一則。 模型不記得上一輪發生什麼(第 13 篇講過,記憶不在它那裡)。是這個迴圈把每一則回應、每一個工具結果都 append 進 messages,下一輪整包重送,模型才看起來前後連貫。
所以「狀態」不在模型身上,在迴圈手裡那串 messages。這也解釋了一件事:轉的圈數越多,messages 就越長,下一次送出去的脈絡就越大。我那次六張單不痛不癢,但真正的任務動輒幾十圈,這條成本線會一路往上。
既然決定權在迴圈裡的模型手上,那你能調的,其實不是模型本身,是這個迴圈。每一圈放什麼脈絡進去(第六篇的脈絡工程就是在管這個)、讓它能碰哪些工具、什麼時候必須停、一步錯了怎麼接,這些都不是改模型,是改它外面那圈 while。把這件事當成一門功夫,就是迴圈工程(loop engineering)。讓它先反思再動手、給它工具、要它先規劃,說到底都是往同一個迴圈裡加的東西。
這裡有個反直覺的槓桿:一個設計得好的迴圈,套在一個普通的模型上,常常贏過一個更強、卻跑在很爛迴圈裡的模型。Andrew Ng 一再講的就是這件事,好的架構勝過更大的模型。這也是為什麼接下來這幾篇,每一篇都在把這圈 while 的某個部位做好。
換個角度看,這個 while 其實是在走一張圖。它只有三種狀態:等模型回應、跑一個工具、結束。模型每回一則,就是在這張圖上選一條邊。stop_reason 是 tool_use,就走到「跑工具」,跑完把結果接回去、回到「等模型回應」。是 end_turn,就走到「結束」。於是一次任務,就是在這張圖上走出來的一條路徑。
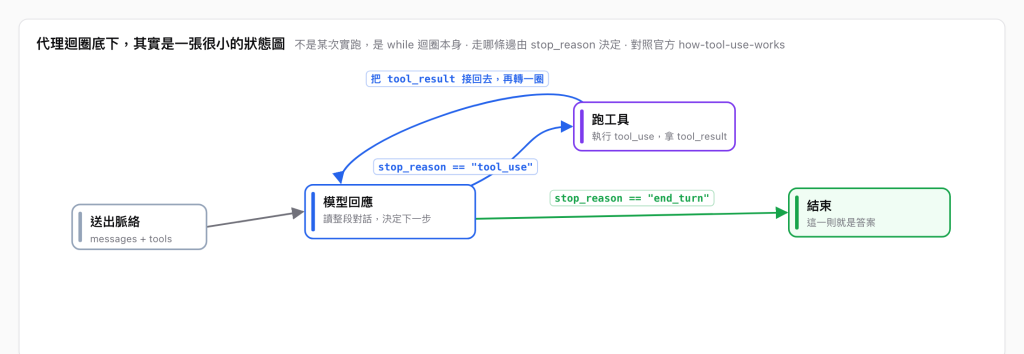
這張圖平常是隱性的,藏在那個 while 裡,沒人真的把它畫出來。模型每一圈臨場選邊,所以同一張圖,每次走出來的路徑都不一樣,長度也不一定。這也是它難預測、難驗證的根源:你事先不知道這次要走幾圈、會不會卡在某個環上繞不出來。
Hu(2026)那篇〈From Agent Loops to Structured Graphs〉做的,就是把這張隱性的圖明確畫出來、先排定:節點、邊、先後都事先定好,變成一張明確的 DAG,用一點臨場的彈性,換來看得見、管得動、驗得了。從「一個模型在迴圈裡自己決定」走到「一張事先排好的圖」,Andrew Ng 把這個轉變叫做從迴圈工程走向圖工程(graph engineering)。工程上,LangGraph 這類框架就是拿節點、邊和檢查點狀態,把代理寫成一張會分支、會回頭、能等人介入的圖。而這張圖同時也是多個代理怎麼分工的底盤,正好是這個系列下一層要拆的東西。
第一,每一輪都重送整段對話。 圈數越多、脈絡越長,每一輪就越貴。這是代理天生的成本結構,不是哪裡沒寫好。
第二,中間過程預設看不見。 我是用 stream-json 才攔到那六張單,平常你只看到最後那一則答案。它中間繞了什麼路、讀了什麼,不特別去看就是黑的。
第三,失敗不一定讓它停。 第 1 張單被擋,它換個方式接著試。這次試對了方向,但換個情境,它也可能一直試下去。誰喊停、停在哪,是迴圈要另外管的事。
多了什麼能力:你知道「代理」拆開來就是一個以
stop_reason為條件的while迴圈,看得懂一份真實軌跡裡每一圈在做什麼,分得出代理和寫死的工作流程差在哪(誰決定下一步),也知道真正能調的是迴圈、不是模型,狀態在迴圈手上、不在模型身上。多付了什麼代價:一個每輪都重送、越轉越長的脈絡、一段預設看不見的中間過程,以及一個不保證會自己停下來的迴圈。
這個 while 會停在 end_turn。但要是模型一張工具單接一張、就是不回 end_turn 呢?誰來喊停,又該在哪裡喊?
下一篇講迴圈的另一半:停止條件、預算,還有一步錯了之後,它該怎麼走。
stop_reason 為條件的 while 迴圈,以及迴圈何時跳出。


 iThome鐵人賽
 看影片追技術