
在 RAG(檢索增強生成)系統的開發過程中,開發者往往投注大量精力於向量資料庫的建置、切塊(Chunking)演算法與檢索優化。然而,當系統正式由開發環境進入維運階段後,真正的挑戰才浮出水面:最令維運團隊恐懼的,並非模型運算力不足,而是 AI 正在「一本正經」地根據過時的文件回答問題。
金融規章、企業政策或技術手冊會隨著時間動態更新,但更新發生的那一刻,往往沒有人會主動通知 AI。這種知識維運的「隱形門檻」,若不透過自動化的機制管理,將導致 AI 產生嚴重的內容幻覺。本文將分享如何透過「知識健檢」與「候選知識佇列」機制,確保 AI 永遠具備精準的依據,避免陷入知識斷層的失憶危機。
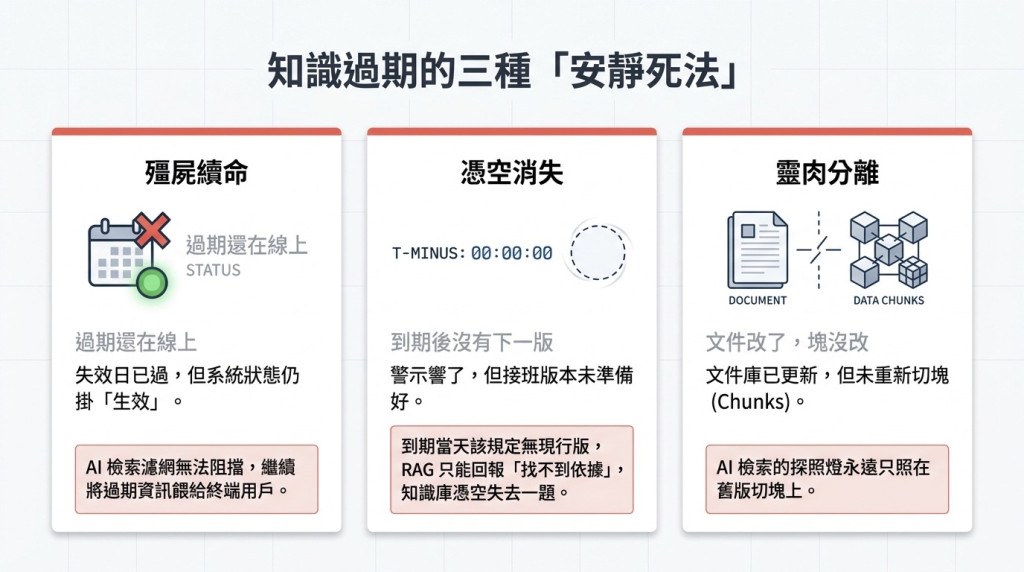
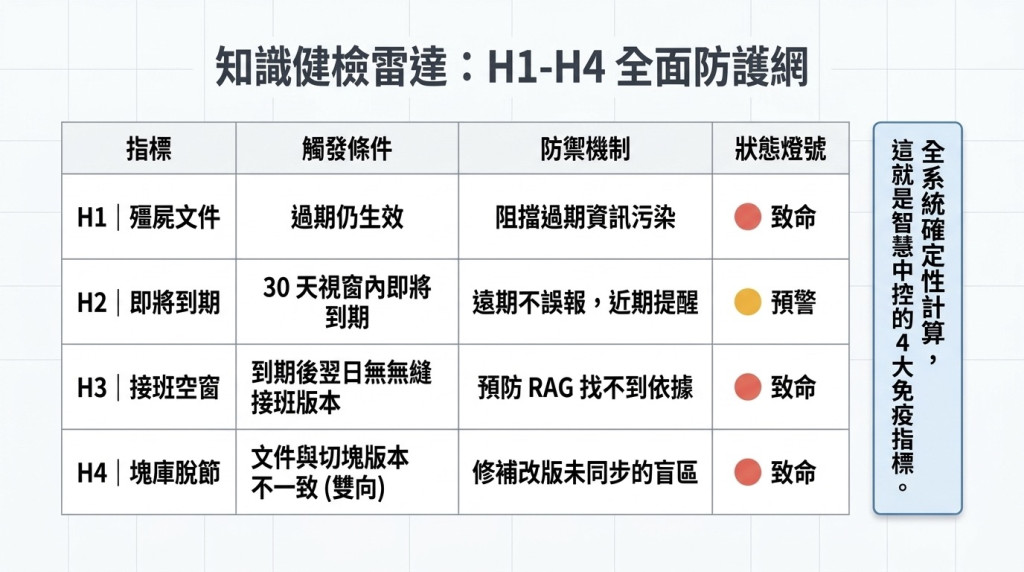
在傳統的知識管理邏輯中,我們習慣設定到期日通知(如 H2 健檢:提供 30 天的緩衝視窗)。然而,對於一個高可靠性的 RAG 系統而言,單純的到期通知只是被動的倒數計時。
真正具備高商業價值的「防災」行為,在於我們實作的 H3 健檢機制:接班空窗檢查。這項機制的核心在於「未來狀態模擬」:系統會模擬舊文件失效後(Day T+1)的知識庫狀態,檢查是否存在同標題、狀態生效且能無縫銜接的新版文件。
例如,文件 KB-001 將於 8 月 31 日到期,若系統偵測到其接班版本 KB-002 的生效日為 9 月 1 日,則判定為安全;若 KB-002 缺席或延至 9 月 8 日才生效,即便現在還是 8 月初,系統也會立即發出警報。
> 「過期警示只是倒數計時器,接班檢查才是防災。」
這種機制防止了知識庫在特定日期「憑空消失一題」的風險。對第一線使用者而言,這避免了 RAG 因為新舊版本銜接不當而突然回答「找不到依據」的尷尬情況。
當系統架構採取「原始文件」與「檢索切塊(Chunks)」分離存放的設計時,「同步」就成了維運中最大的風險點。這就是我們常說的「兩項合理假設之間的縫隙」:假設文件更新了,就假設切塊也會同步更新。但在實務中,若維運人員修正了文件內容卻忘記執行重跑切塊(build_chunks)的流程,這道縫隙就會出現。
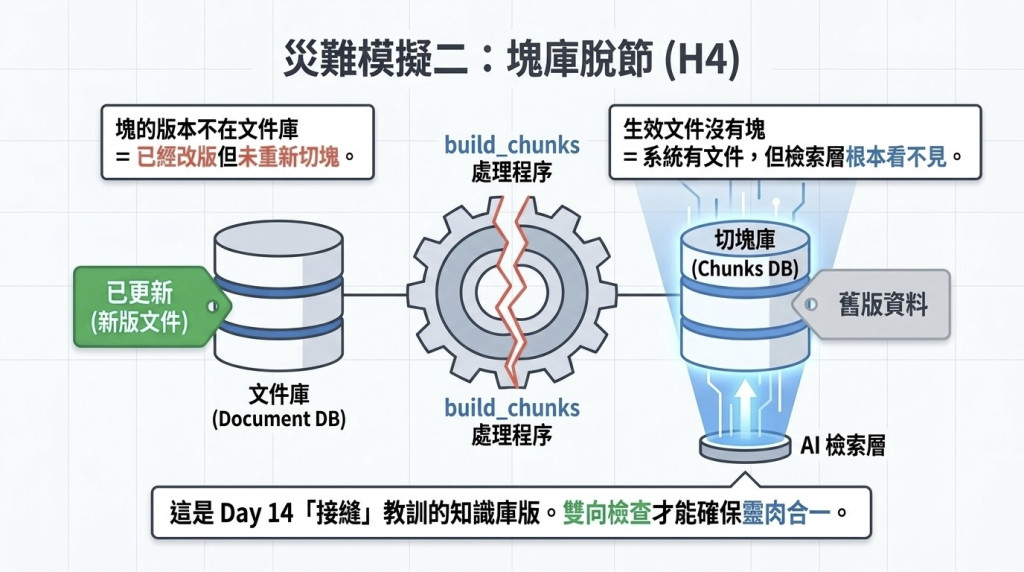
H4 健檢(塊庫脫節) 便是為了縫合這條縫隙而生。我們實施雙向檢查:
透過 H4 健檢,我們能確保 AI 檢索到的內容與原始文件保持高度一致,徹底杜絕因為版本落差導致的「舊版資訊幻覺」。
並非所有資訊都適合自動化、無差別地入庫,特別是來自第一線的「歷史經驗」。針對這些非結構化的寶貴資訊,我們建立了「候選知識佇列」作為緩衝地帶。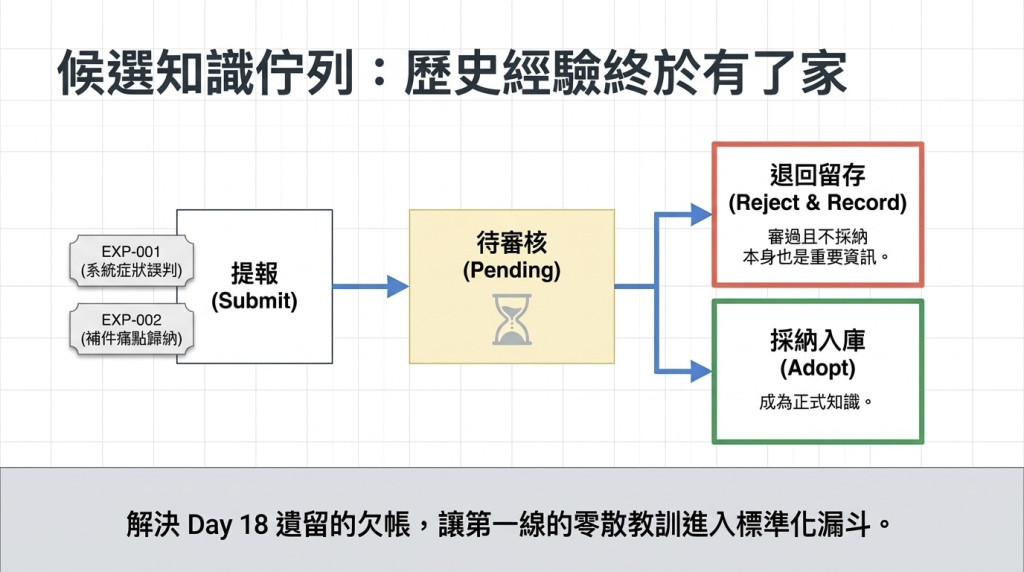
我們以 EXP-001(如:系統異常信件應優先檢查客戶權益期限)與 EXP-002(如:減少補件往返的溝通痛點)等真實案例進行測試。這些經驗的「採納(Adopt)」動作必須堅持 Human-in-the-loop 原則。系統要求採納時必須記錄:
這不僅是技術流程,更是嚴謹的「知識稽核」。更重要的是,我們認為「審過且不採納」的紀錄同樣具有價值。這些被退回的候選紀錄留下了完整的決策軌跡,幫助我們更清晰地定義「知識庫的邊界」。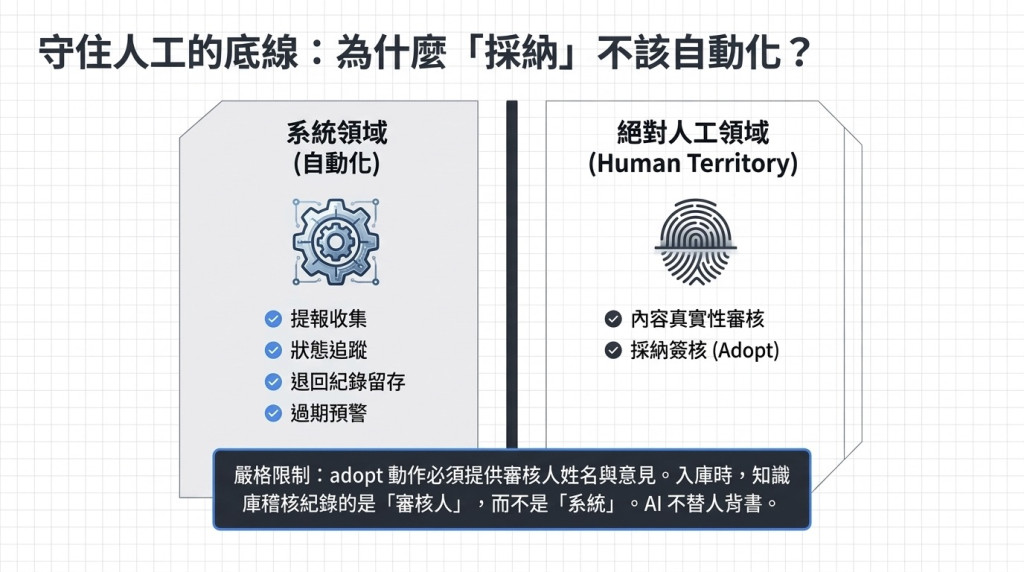
在開發過程中,我們最初只考慮了基礎的過期管理。但在多次災難模擬走查後,我們意識到必須將預警邏輯從「現在」推向「未來」。為了驗證這些機制的嚴謹性,我們在既有的測試套件中新增了 13 項針對性測試,確保所有邊界案例(如無縫接班、接班延遲、塊庫不對稱)都能被精準捕捉。
============================= 192 passed in 1.12s ==============================
以下是我們歸納出的四項核心健檢清單:
| 健檢項目 | 解決的潛在災難 | 關鍵邏輯 |
|---|---|---|
| H1:過期仍生效 | 檢索層殘留問題 | 清除已失效但未正確下架的舊規章。 |
| H2:即將到期 | 缺乏作業緩衝 | 提供 30 天視窗,讓團隊有時間準備新版。 |
| H3:接班空窗 | 知識庫憑空消失 | 模擬 Day T+1 狀態,確保新舊版本無縫銜接。 |
| H4:塊庫脫節 | 檢索與原始文件不一致 | 雙向比對文件版本與向量塊,防止舊版幻覺。 |
從診斷、分類到生命週期的動態健檢,這套「依據層」的管理體系構建了 RAG 系統的信任根基。我們必須意識到,當 AI 擁有了強大的檢索能力後,人類開發者與維運者的角色已轉變為「知識守護者」。我們是否已經準備好承擔起「餵養正確知識」的長期責任?
AI 在企業落地的最大障礙,往往不是模型生成能力的優劣,而是知識治理的缺失。透過將「憑印象回答」轉變為「基於身分證與切塊的嚴謹引用」,並搭配由程式看守的依據強度評估與 H1–H4 健檢,我們能建構出高度可追溯、防禦力堅固且具備自我修正能力的 AI 知識治理系統。
Key Takeaways:
隨著依據層的開發收官,我們即將跨入更深層的治理挑戰。在金融等高度合規的領域,資料並非只有可用與不可用之分。下一個階段,我們將進入**資料分級(Data Classification)**的層次,針對「公開(Public)」、「內部(Internal)」、「敏感(Sensitive)」與「高敏感(Highly Sensitive)」四種不同密級的資料,制定 AI 任務的執行邊界與過濾規則。這將是確保 AI 系統在安全與合規下運作的關鍵拼圖。


 iThome鐵人賽
 看影片追技術