
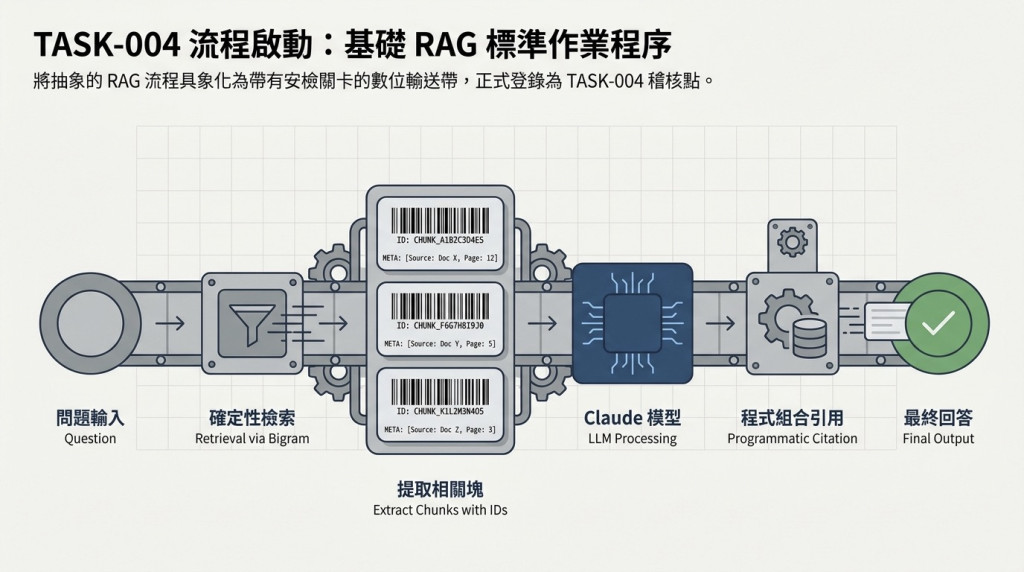
在企業導入檢索增強生成(RAG)系統的過程中,最令架構師徹夜難眠的惡夢,往往不是系統「查不到資料」,而是 AI 以極其專業的口吻,引用了一條早已過期的法規,或是在成堆的技術文件中,拼湊出一個看似合理卻完全錯誤的回答。
在我們最近的 TASK-004 稽核任務中,發生了一個極具啟發性的轉折:初始檢索測試拿到了 15/15 一次全綠的完美成績。然而,這正是「技術指標全綠」帶來的假象。當我們發動對抗性探測時,這份全綠的報告背後隱藏的治理漏洞才顯露無蹤。這讓我們意識到:RAG 系統的成熟,不在於它回答了多少,而是在於它是否具備「精準拒絕」的勇氣。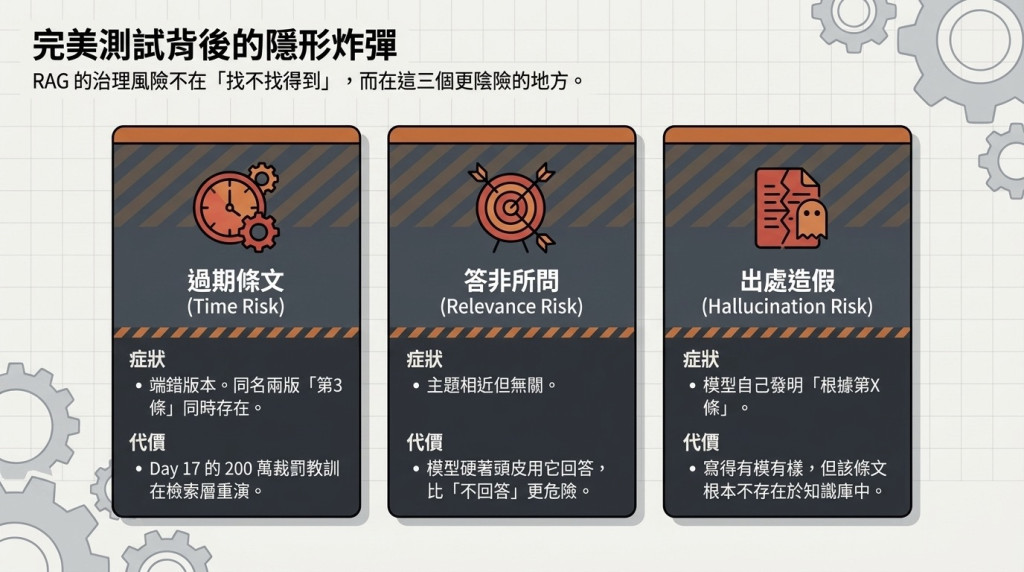
以下是我們在 RAG 治理與架構中,針對「可追溯性」與「精準度」總結的四個核心實作細節。
檢索的第一步絕不是計算相關性,而是「合規性過濾」。根據我們先前的教訓(Day 17 的 200 萬教訓),企業法規常有「同名兩版」的情形。若僅依賴相似度評分,系統極可能在 9 月份還在端出 8 月份就過期的條文。
在我們的架構中,檢索層對時間具備「結構性的盲視」——只有標記為 is_in_force(today) 的區塊(Chunk)才有資格被送入評分。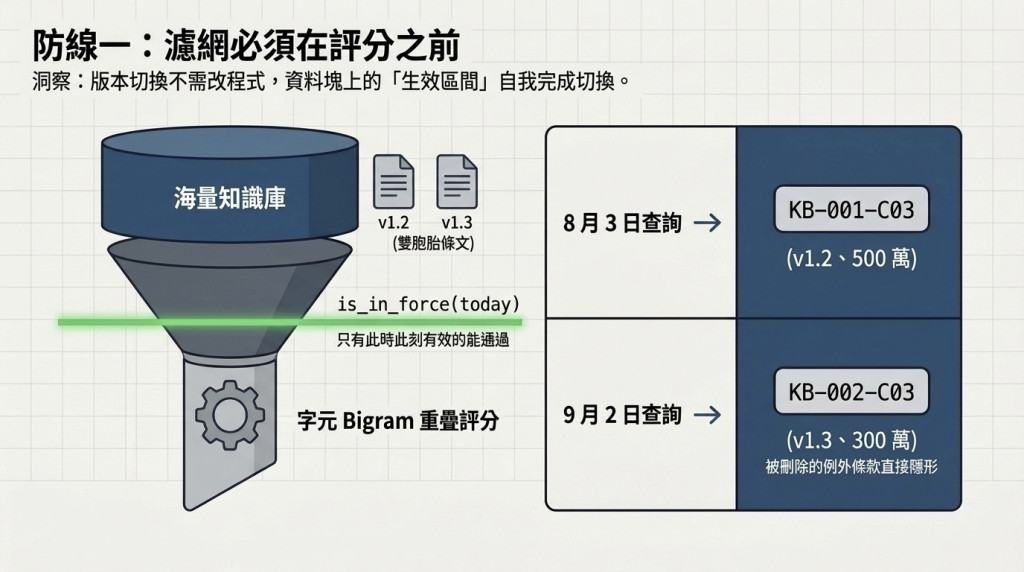
> 技術精髓: 版本切換不用改任何程式,塊上的生效區間自己完成了切換。這種設計從根本上杜絕了引用舊規的合規風險。
在生成回答時,架構師必須摒棄「要求模型精準引用」的幻想。事實證明,模型在處理文本細節時極易產生幻覺引用。因此,我們實施了「引用與生成脫鉤」的機制。
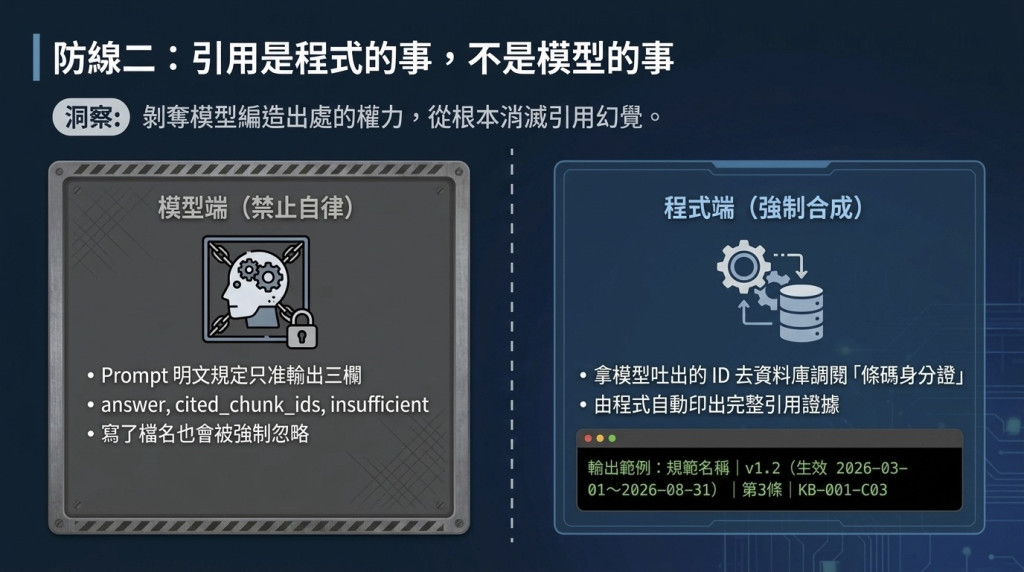
在 TASK-004 中,模型被賦予了極其嚴苛的指令:它只負責輸出核心答案(answer)與引用塊編號(cited_chunk_ids)。我們在 Prompt 中明確告誡模型:「就算你寫了文件名稱或版本,程式也會直接忽略它。」
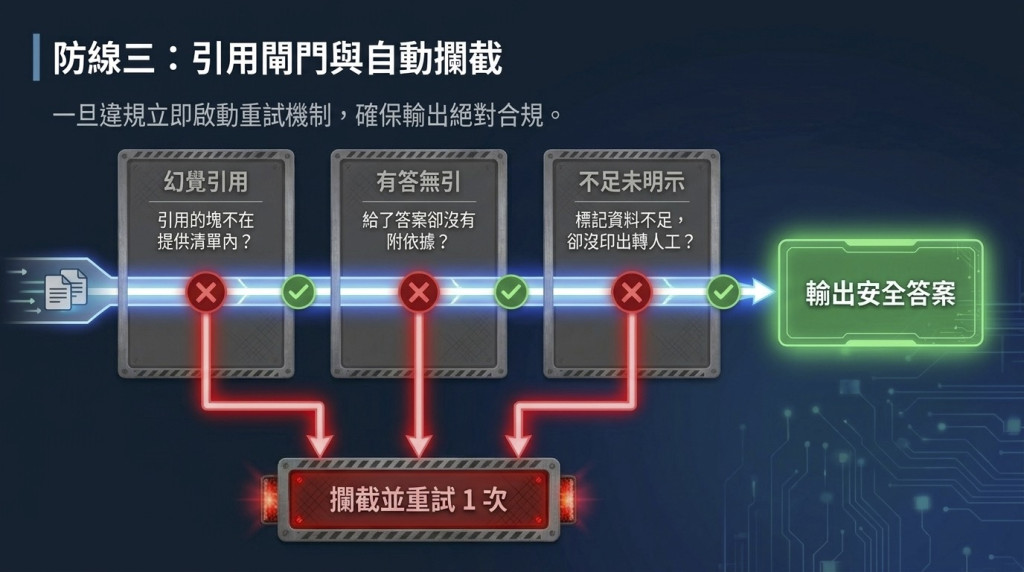
真正的引用行是由程式端根據塊 ID,回溯資料庫中的「身分證」自動生成的。同時,我們設立了「引用閘門(Citation Gate)」,嚴格攔截以下三種違規:
> 核心觀念: 出處不由模型自律,而是由程式碼嚴格控管。這是 RAG 治理中「零信任(Zero Trust)」架構的實踐。
我們在對抗性探測中發現了字面分數(Bigram Scoring)的本質弱點。雖然 Bigram 分數能輕易過濾「尾牙抽獎」這種風馬牛不相及的無關資料,但它分不出「主題相近但答非所問」的雜訊。
以「偏遠地區傳真審查」的測試題(Q6 陷阱)為例:
門檻是「鈍器」,無法處理細微語意。因此,我們決定承認檢索層的極限,將防線下移至模型層。
為了彌補檢索層的不足,我們在模型指令中寫入了「Prompt 鐵則第 3 條」:塊內容若「主題相近但答非所問」也算依據不足。
在驗收中,模型展現了高度的「效力用語紀律」與「誠實」:
本次 TASK-004 的稽核結果令人振奮:在 171 項自動化測試中全數通過(171 passed)。我們證實了 RAG 系統的「可追溯性」不僅是功能,更是一種治理哲學。
當檢索層量不出的「答非所問」能被模型層成功接住並導向人工處理時,這代表我們的防線已從單純的關鍵字匹配,進化到了具備邏輯判斷的治理層次。
最後,值得我們深思的是:當 AI 學會誠實地說出「我不知道」時,我們是否反而能對它產生更深的信任?


 iThome鐵人賽
 看影片追技術