
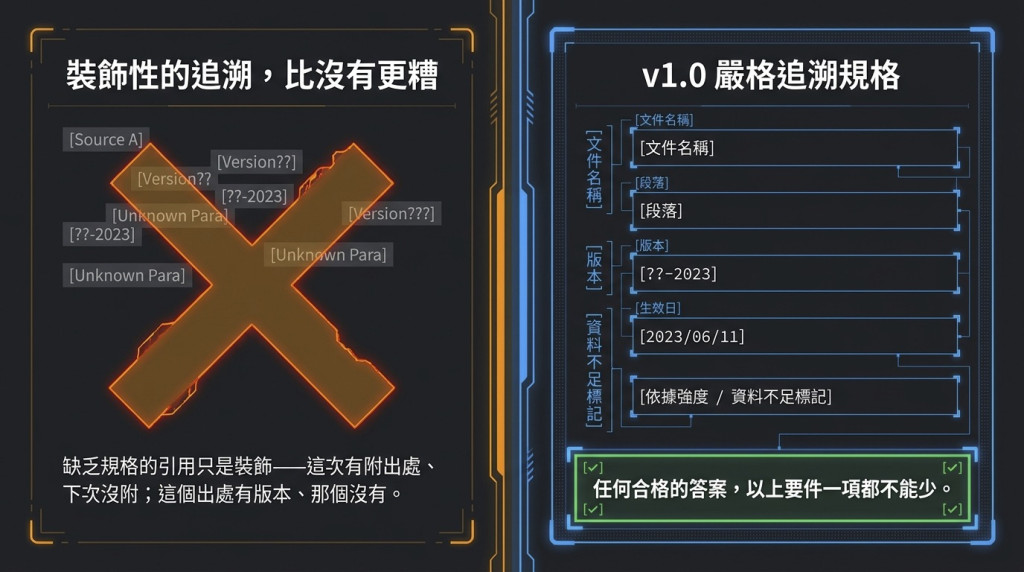
在檢索增強生成(RAG)系統的開發實務中,我們經常遇到一個棘手的課題:當使用者問了一個艱澀的專業問題,AI 吐出了一個看起來非常完美的答案,我們該如何確認它的可信度?
傳統的思維是讓 AI 給自己打分,這就是所謂的「信心分數」(Confidence Score)。然而,身為架構師,我們必須直面一個殘酷的現實:如果 AI 的信心本身就是一種「幻覺」的延伸,那麼這種自我評估將成為系統中最危險的單點故障。為了打破這種虛假的信任,我們需要一套「誠實協議」——將 AI 從「決定正確與否的法官」降格為「提供證據的證人」。
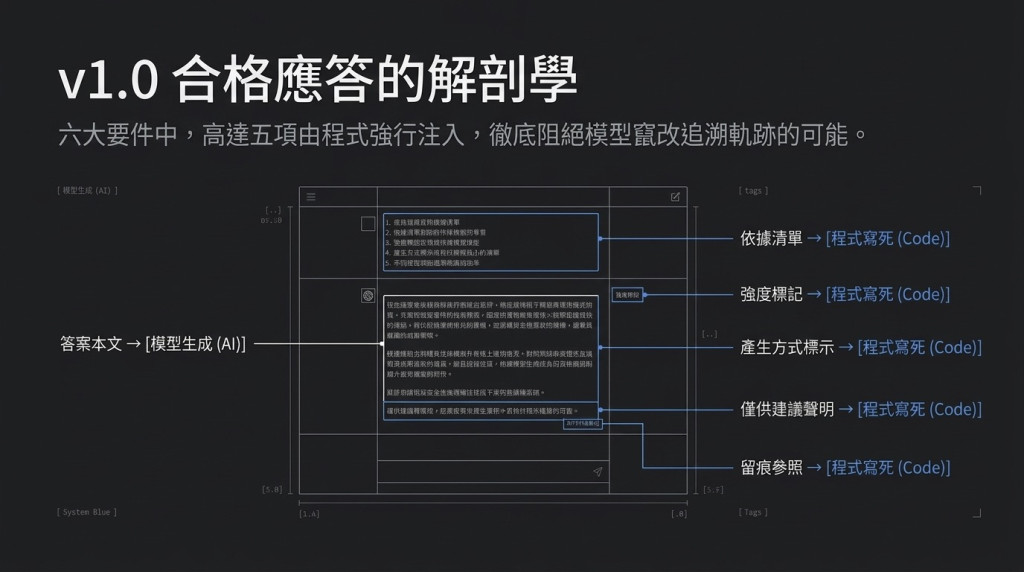
為了讓 RAG 從「裝飾性的追溯」進化為「規格化的追溯」,我們在「可追溯回答格式 v1.0」中定義了六個必要元件。這不僅是為了美觀,更是為了將 AI 治理的精神硬性植入系統架構中:
在規格定版的最關鍵時刻,我否決了第一版設計:嚴禁模型在 JSON 輸出中包含 confidence 欄位。
這個決定或許聽起來違背直覺,但在架構治理上,這是對「關注點分離」(Separation of Concerns)的堅持。讓模型自評信心的風險在於:
> 「信心是感覺,依據強度是證據——我們的格式裡只放證據。」
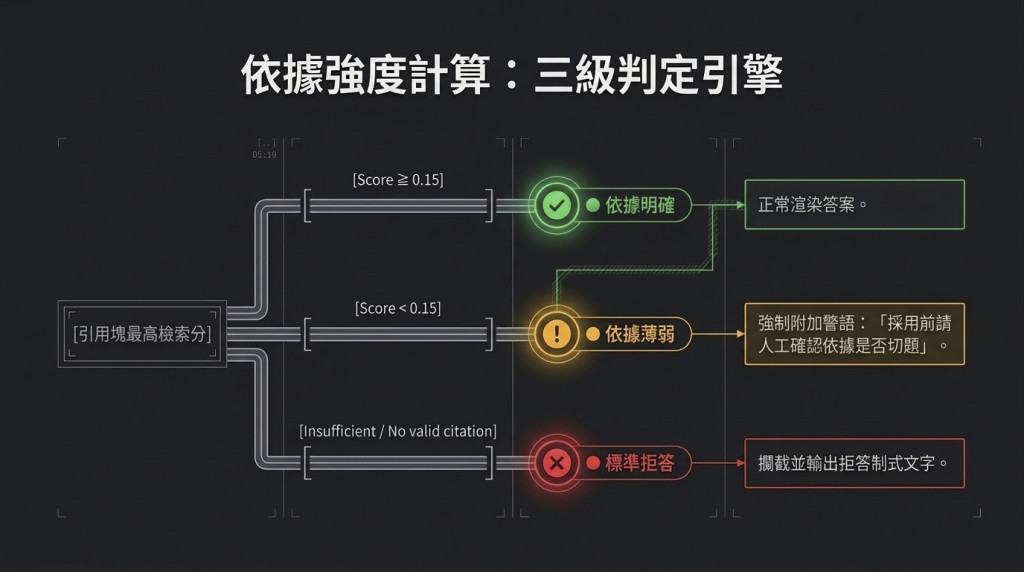
既然不准模型自評,我們該如何衡量答案的品質?我們選擇用程式計算出的「依據強度」來取代。這些數值並非憑空而來,而是透過 34 塊初始樣張校正後得出的動態門檻。
系統實施了嚴格的三級規則判定:
在測試過程中,我們特別設定了一個「雜訊陷阱」(Noise Trap)情境:若模型引用了僅有 0.077 分的弱相關區塊,系統會立即偵測到強度不足並標示「薄弱」。這證明了「數據驅動」的約束力遠比「模型自覺」可靠。
我們必須釐清一個架構本質:「依據強度」測量的是切題度(Relevance),而非正確性(Truthfulness)。檢索分數反應的是字面上的關聯,而答案是否絕對正確,最後一哩路始終屬於人類。
格式中的「僅供建議」聲明並非客套的法律免責條款,而是一種專業分工的宣告。當我們把 AI 定位為「證人」時,它的義務是誠實地交出它參考了哪些證據、這些證據有多切題;至於最後的判決,必須交由具備專業知識的人類法官來裁定。
隨著「可追溯回答格式 v1.0」定版,我們完成了 TASK-004 的規格驗收。這次驗收不僅包含了 8 項針對新格式(含三級強度、警語觸發、六要件完整性斷言)的深度測試,累計更已通過 179 項測試案例。
| 驗收項目 | 結果 |
|---|---|
| 六要件完整性(逐項斷言,缺一不可) | 通過 ✅ |
| 強度三級規則(明確/薄弱/拒答) | 通過 ✅ |
| 薄弱區塊強制人工複核警語 | 通過 ✅ |
| 雜訊陷阱防護(0.077 弱塊偵測) | 通過 ✅ |
| TASK-004 全套 179 項測試 | 全數通過 ✅ |
這套「誠實協議」的定版,象徵著我們不再盲目依賴 AI 的「自覺」,而是將其置於系統工程的硬性約束之下。在追求 AI 效能的賽道上,有時「誠實地承認無知」比「自信地吐出謊言」更具技術價值。
下集預告: 答案格式對了,但如果「依據」本身過期了怎麼辦?下一篇我們將解決「知識過期」與「無主知識」的攔截問題,並償還 Day 18 欠下的債——正式建立「候選知識佇列」。


 iThome鐵人賽
 看影片追技術