
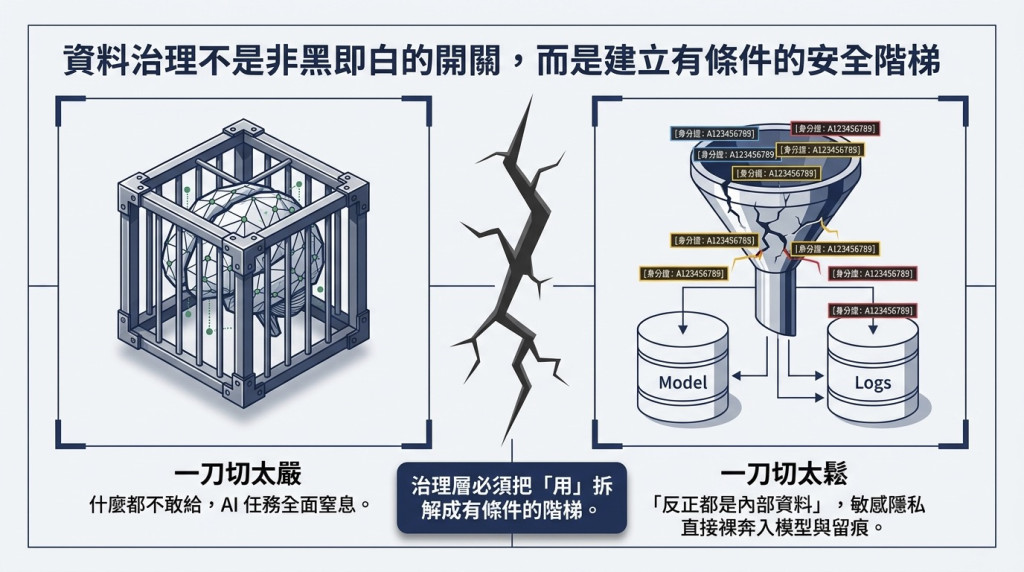
在金融業推動 AI 專案,我們經常在兩極之間痛苦掙扎。一種是為了絕對合規而「管得太嚴」,讓開發者拿不到像樣的測試資料,模型最終因缺乏養分而「窒息」;另一種則是為了趕進度而「管得太鬆」,打著「內部系統」的口號,卻讓身分證字號等高度敏感資訊,隨著使用者的問題直接流入模型或系統日誌。
這種「非黑即白」的二分法管理,是許多 AI 專案無聲的殺手。作為一名 AI 治理架構師,我見過太多開發團隊在「全給」與「不給」之間反覆橫跳。今天,我想從實務的分級架構中,分享三個不僅能保護資料、更能釋放研發動能的核心洞察。
資料治理不該是一道非 0 即 1 的選擇題,而應該是清晰的「進階階梯」。在我們的實務中,透過將資料精確劃分為「公開」、「一般內部」、「敏感」與「高敏感」四個等級,我們能更彈性地定義使用邊界:
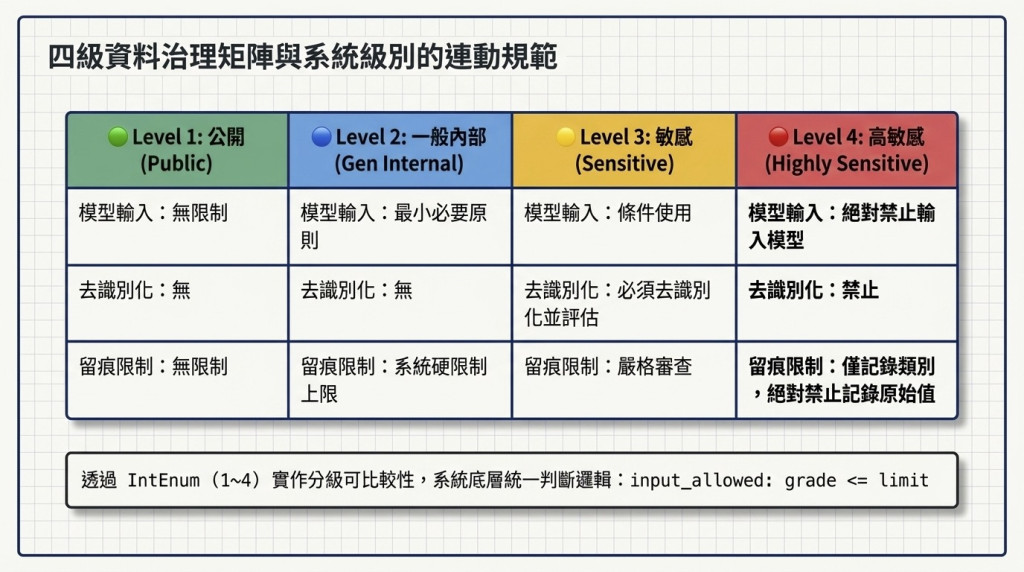
與其依賴人工審核,我更傾向於將分級邏輯「程式碼化」。透過 IntEnum 技術(例如公開級為 1,高敏感級為 4),我們讓分級變得「可比較」。系統能自動執行「上限管制」:只要偵測到「資料等級 > 任務上限」,系統就會強制阻斷。這種「自動化治理」讓合規不再是行政流程,而是開發環境中的強制基礎設施。
> 「可以用/不能用」的二分法在資料治理上有兩種死法:一刀切太嚴,AI 任務全部窒息;一刀切太鬆,身分證樣式跟著問題文字一起進了模型與留痕。
在技術實作中,開發者常有一個致命盲點:以為在 API 層攔截了敏感資料就萬事大吉,卻忘了後台的「日誌(Logs)」與「追蹤紀錄(Traces)」。
一個常見的慘劇是:系統確實攔截了一個包含身分證字號的違規請求,但為了除錯,日誌檔卻完整記錄了該請求的原始文字。這意味著敏感資料依然「逃」出了安全區,只是換個地方躲藏。
我們必須建立嚴格的「留痕淨化」規則:
在資料治理中,防守的細節決定成敗。如果你的攔截紀錄複寫了原始值,那這道防線就只是在自欺欺人。
> 攔截紀錄本身若複製了原始值,攔截就白做了。
在開發 TASK-004 這個 RAG(檢索增強生成)專案時,我們撞上了一個深刻的教訓。當時團隊滿腦子想著如何優化檢索品質,卻忘了最基礎的「輸入端門神」。
測試時,我們丟入了一個包含虛構身分證字號的問題,原以為會被攔截,結果系統噴出了 SERVICE_DOWN 錯誤。深入追蹤才發現,這其實是一個「幸運的意外」:因為測試環境沒裝特定的 SDK 才導致系統崩潰,如果環境完整,這個敏感身分證字號早就直衝雲端模型了。更糟的是,追蹤紀錄顯示,這個身分證字號已經被完整地寫進了 Trace 檔案。
這揭示了一個真理:技術架構的複用並不等於治理邏輯的複用。為了解決這點,我們引入了「動態覆蓋檢查(Dynamic Coverage Check)」:
202 passed 的自動化測試項,確保每一行新程式碼都必須承載過去血汗換來的教訓。> 新任務會繼承架構,不會自動繼承教訓。
資料治理的本質不是「禁止」,而是為了「建立信任」。透過「資料分級表 v1.0」與自動化上限管制,我們不再需要人工盯著每一行 Log,因為系統本身就是最嚴格的稽核員。
雖然我們目前達成了 202 passed 的里程碑,但挑戰並未結束。目前的樣式攔截(E2)只能抓到具備固定格式的資料,對於非結構化的「語意敏感資訊」仍有極大挑戰。明天,我們將挑戰更進階的課題:去識別化的品質。畢竟,遮了姓名卻留下「北區最大分行的張姓襄理」,這與沒遮根本沒兩樣。
思考題: 在你的 AI 專案中,有哪些「雖然被攔截了,但原始內容可能還留在 Log 裡」的資料幽靈?歡迎檢查你的日誌系統,別讓你的治理只做了一半。


 iThome鐵人賽
 看影片追技術