
Agent 的表現會受到 Prompt、模型與輸入影響。更換 Prompt 或模型後,原本判斷正確的請求也可能出現回歸問題,所以每次修改前後,都需要用同一組固定案例驗證行為有沒有變。這種做法稱為 Eval(evaluation 的縮寫):讓 Agent 執行一組測試案例,再依照預期結果評分。
最簡單的做法是在終端機執行測試腳本,但這只能看到最終的字串輸出。分類出錯或路由不如預期時,我們看不到模型收到的完整提示詞、Token 消耗與延遲,也看不到 LangGraph 的節點轉移過程,只知道結果錯了,卻不知道錯在哪裡。Langfuse 正好補上這個缺口:它會記錄每次執行的完整過程,讓我們查出錯的原因,並在每次修改後用同一組案例重複評估,一眼找出被改壞的案例。
評估 Agent 前,要先準備一組固定的對話與正確答案。例如輸入「請問 ORD-1001 配送到哪了?」,預期 intent 是 order_status,處理節點是 query_order。Langfuse 把這組評估案例稱為 Dataset。
執行評估時,Agent 會逐筆處理 Dataset 裡的對話。Langfuse 保存當時使用的 Prompt、Agent 的實際輸出、是否符合正確答案,以及完整執行過程。修改 Prompt 後重跑同一組案例,就能比較準確率是否提高,並在 Langfuse 網頁查看失敗案例。
這裡使用 sample 內的 Docker Compose 啟動本機 Langfuse。langfuse-web 提供網頁與 API,langfuse-worker 在背景接收評估資料。Compose 也會啟動 Postgres 保存帳號、評估案例與 Prompt,使用 ClickHouse 保存每次 Agent 執行的詳細紀錄,並由 Redis 傳遞背景工作、MinIO 保存事件與媒體檔案。這些服務不需要個別操作,後續只會使用 Langfuse 網頁與 intent-eval 命令。
Postgres、ClickHouse、Redis 與 MinIO 的資料都放在 Docker volume。停止容器後資料仍會保留,再次啟動可以繼續查看原本的評估案例、Prompt 與執行紀錄。
先啟動 Docker Desktop,再進入 langfuse-selfhost,複製教學環境的設定:
cp -n .env.example .env
.env.example 預填了本機練習用的專案金鑰與管理者密碼,複製後不需要修改:
LANGFUSE_INIT_PROJECT_PUBLIC_KEY=lf_pk_local_intent_evaluation
LANGFUSE_INIT_PROJECT_SECRET_KEY=lf_sk_local_intent_evaluation
LANGFUSE_INIT_USER_PASSWORD=local-langfuse-password
啟動服務:
docker compose up -d
Compose 會啟動 Langfuse Web 與所需的資料服務。第一次啟動需要建立資料表,等待一到三分鐘後,執行下列命令查看狀態:
docker compose logs -f langfuse-web
看到 Ready 後開啟 http://localhost:3000,使用 dev@example.com 與密碼 local-langfuse-password(即 .env 的 LANGFUSE_INIT_USER_PASSWORD)登入。登入後會停在 Organizations 頁,Local 組織底下是第一次啟動時自動建立的 Intent Evaluation project,後續的 Prompt、Dataset 與 trace 都會寫進這個 project。點 Go to project 進入:
接著回到 Terminal,設定 Agent 與評估程式連線 Langfuse 所需的環境變數。同一個 Terminal export 一次後,這一節之後的所有命令都會直接讀到:
export LANGFUSE_BASE_URL="http://localhost:3000"
export LANGFUSE_PUBLIC_KEY="lf_pk_local_intent_evaluation"
export LANGFUSE_SECRET_KEY="lf_sk_local_intent_evaluation"
export ANTHROPIC_API_KEY="..."
LANGFUSE_BASE_URL 指向剛才啟動的本機服務,public key 與 secret key 對應 langfuse-selfhost/.env 中的 LANGFUSE_INIT_PROJECT_PUBLIC_KEY 與 LANGFUSE_INIT_PROJECT_SECRET_KEY。這兩把 key 讓 Agent 與評估程式把資料寫入 Langfuse project。
在建立評估資料集前,先讓被測試的 Agent 執行一次對話,確認它能把 LangGraph 的執行過程(Trace)送進剛啟動的 Langfuse。
這一步是為了先做連線驗證(Smoke Test)。Trace 會記錄模型收到的 Prompt、原始輸出、token 消耗、延遲以及 LangGraph 的節點路由;確認單次執行的 trace 能正常送出,代表 Langfuse 連線與 callback 監聽正常,後續執行批次評估時,才能在網頁上檢視每個測試案例的執行細節與排查失敗原因。這一步使用應用程式內的本機 Prompt,不需要先建立 Dataset 或指定 Prompt version。
Agent 能自動將執行紀錄送到 Langfuse,關鍵在於 LangChain 與 Langfuse 的 Callback 機制。這不需要侵入修改 Graph 的節點邏輯,而是透過外部傳入的 CallbackHandler 監聽執行事件。
在 demo.py 中,程式將 CallbackHandler 傳入 invoke():
langfuse_handler = _build_langfuse_handler()
result = invoke(
    graph,
    args.message,
    callbacks=[langfuse_handler] if langfuse_handler else None,
)
在 workflow.py 中,invoke() 把 callback 放進 graph.invoke() 的執行設定:
def invoke(
    graph: Any,
    message: str,
    *,
    callbacks: list[Any] | None = None,
) -> State:
    result = graph.invoke(
        {"message": message},
        config={
            "callbacks": callbacks or [],
            "run_name": "intent-routing",
            "tags": ["application"],
        },
        version="v2",
    )
    return State.model_validate(result.value)
當 LangGraph 啟動時,CallbackHandler 會自動接收整條流程的執行事件:
classify_intent 節點。query_order 節點。回到專案根目錄,執行一次對話測試:
uv run intent-routing "訂單 ORD-1001 配送到哪了?"
intent-routing 會呼叫真實的 Anthropic 模型,接著由 LangGraph 依據模型輸出的 intent 選擇處理節點。當三個 LANGFUSE_* 環境變數都已設定時,終端機會先顯示 tracing 已啟用,再列出執行結果:
Langfuse tracing:已啟用
輸入:訂單 ORD-1001 配送到哪了?
意圖:order_status
信心:0.95
訂單:ORD-1001
需要補問:False
處理節點:query_order
回覆:已進入訂單 ORD-1001 的配送查詢流程。
執行結束後,打開 Langfuse 網頁並進入 Tracing 頁面。事件清單預設會列出這次執行發生的所有事件(Observations),依時間順序由下往上記錄:
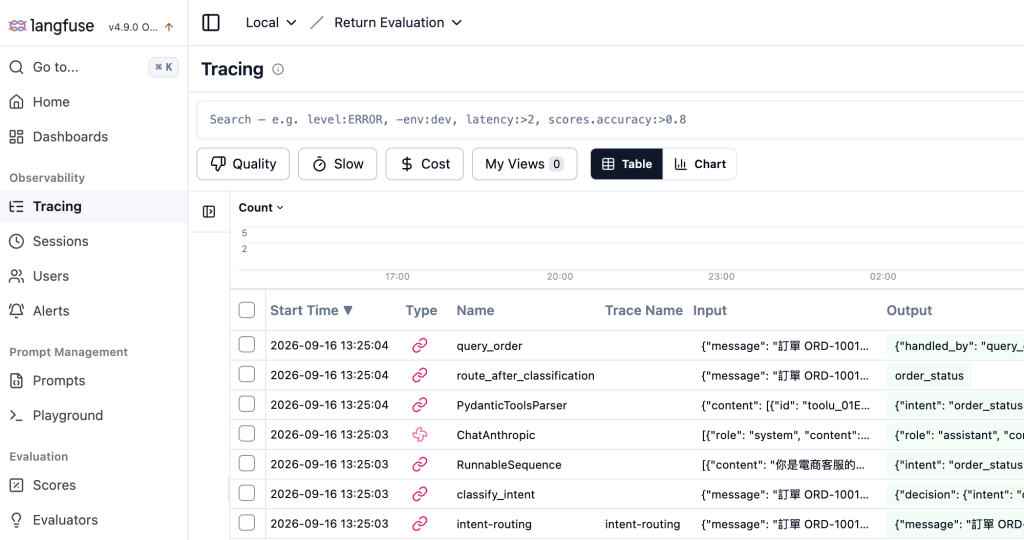
intent-routing(Root Trace,CHAIN):整趟 LangGraph 的根起點,Input 是使用者輸入的問句。classify_intent 與 RunnableSequence(CHAIN):進入意圖分類節點與 LangChain 內部執行鏈。ChatAnthropic(GENERATION):發送 Prompt 給 Claude 並取得結構化 JSON 的模型推論步驟。PydanticToolsParser(CHAIN):驗證模型輸出是否符合 IntentDecision 結構。route_after_classification(CHAIN):LangGraph 條件邊(Conditional Edge),依分類結果決定下一站。query_order(CHAIN):路由轉向後進入的目標處理節點。若只想在列表中看到一次對話一筆紀錄,可以在左側邊欄的 Filters > Is Root Observation 只勾選 True。
點選最底下的根節點 intent-routing,畫面會展開整趟執行的詳細面板:
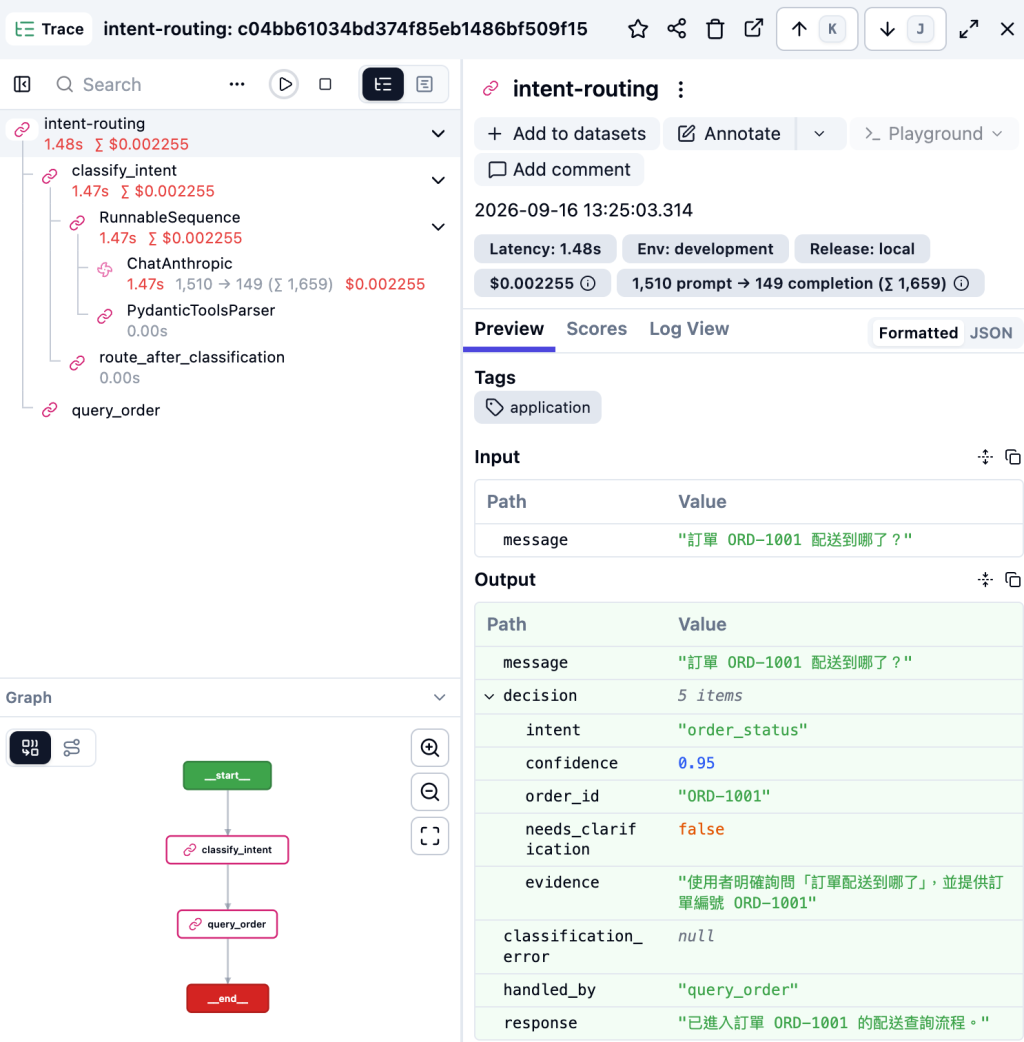
面板左側是整趟 Graph 的執行路徑。樹狀結構清楚標示從根節點進入 classify_intent、呼叫 LLM Generation(ChatAnthropic)與結構化解析(PydanticToolsParser),再依條件路由進入目標節點 query_order;下方的 Graph 區域則直接繪出節點走向(__start__ → classify_intent → query_order → __end__),直觀驗證狀態轉移。
頂部標記了這次呼叫的整體效能:總耗時 1.48s、消耗 1,510 顆 Prompt Token 與 149 顆 Completion Token,以及推論費用 $0.002255。上圖呈現的是首次執行的冷啟動基準;若串接了Cache的機制,當後續相同前綴的請求命中快取時,Langfuse 會自動以折扣單價(如讀取一折)計費,直接在頂部呈現節省後的實際費用,且因略過 Prefill 計算,耗時也會明顯低於 1.48s。
右側預覽面板記錄了 Graph 的輸入與最終狀態。Input 保存原始問句,Output 則展開 LangGraph 回傳的 State。展開 decision 可以檢視模型辨識出的 intent(order_status)、信心度(0.95)、提取出的訂單編號(ORD-1001)與推論依據(evidence),以及路由指派的處理節點與回覆內容。
若進一步點擊左側樹狀結構中的 ChatAnthropic 節點,右側面板會切換為模型生成視圖,顯示發送給 Anthropic 的完整 Prompt、模型名稱、溫度設定與原始 JSON。此時 Token 區域也會細分出快取寫入量(cache_creation)與讀取量(cache_read);若後續呼叫的讀取量為 0,開發者可直接展開 Prompt 面板,比對前綴是否遭到動態時間戳或變動的工具順序破壞。
透過 Tracing 介面,開發者能將原本在終端機只能看到純文字輸出的黑盒流程,拆解成每個節點的具體輸入、輸出與效能消耗。
要在 Langfuse 上建立自動化評估,必須先把兩項核心資料放上平台:一是用來驅動模型決策的 Prompt 版本,二是用來比對對錯的測試資料集(Dataset)。測試資料集提供使用者的測試問句與人工驗收的預期標準答案;評估時,Agent 拿著指定版本的 Prompt 執行對話,評分器再拿 Agent 的實際輸出與預期答案進行比對。
這兩項資料不能直接依賴隨時可能被修改的本機檔案。如果每次測試都讀取當前工作目錄的檔案,一旦 Prompt 被微調或案例被改動,過去跑過的測試結果就無法重現。因此,我們需要將 Git 裡的 Prompt 與測試案例同步到 Langfuse,建立不可變的版本快照(Immutable Snapshots),作為後續評估的固定基準。
以訂單查詢案例為例,輸入為:
使用者:請問 ORD-1001 配送到哪了?
我們期望真實模型讀到這句話後產生:
{
  "intent": "order_status",
  "order_id": "ORD-1001",
  "needs_clarification": false
}
Graph 收到 order_status 後,router 應該走到 query_order node。這筆案例同時驗證兩件事:模型有沒有判對 intent,以及判斷結果有沒有進入正確 node。
案例保存在 intent-cases.jsonl。JSONL 的每一行是一筆獨立案例,第一筆內容如下:
{
  "input": {
    "case_id": "order_status",
    "message": "請問 ORD-1001 配送到哪了?"
  },
  "expected_output": {
    "intent": "order_status",
    "handled_by": "query_order",
    "needs_clarification": false,
    "order_id": "ORD-1001"
  },
  "metadata": {
    "category": "supported",
    "risk": "medium"
  }
}
這筆案例定義了三個部分:
input:交給 Agent 的輸入資料,例如 message 是使用者的問句。expected_output:人工定義的標準答案。評估時不會傳給模型,而是交給評分器比對 Agent 的實際輸出。metadata:標記案例類型與風險層級,方便之後在 Langfuse 篩選與分類。Prompt 則保存在 intent-classifier.md。它定義了四種允許的 intent、訂單編號格式,以及何時需要要求補問。
在 assets.py 中,sync_assets() 負責將本機檔案與 Langfuse 上的最新版本比對:
def sync_assets(langfuse: Any) -> tuple[int, int]:
    prompt = _sync_prompt(
        langfuse,
        PromptAsset.from_content("intent-classifier", SYSTEM_PROMPT),
    )
    _ensure_dataset(langfuse)

    cases = load_cases()
    for case in cases:
        item_id = str(
            uuid.uuid5(
                uuid.NAMESPACE_URL,
                f"{DATASET_NAME}/{case.input.case_id}",
            )
        )
        langfuse.create_dataset_item(
            dataset_name=DATASET_NAME,
            id=item_id,
            input=case.input.model_dump(),
            expected_output=case.expected_output.model_dump(),
            metadata=case.metadata.model_dump(),
        )
    return prompt.version, len(cases)
_sync_prompt() 會先檢查 Langfuse 上現有的 Prompt 內容。如果本機 Prompt 內容沒有改變,就直接重用現有版本號;如果內容有異動,則呼叫 create_prompt() 產生新的版本快照。接著再將 JSONL 中的案例寫入 Dataset。
每次執行評估命令時,程式會自動呼叫 sync_assets() 同步本機最新的 Prompt 與測試案例,開發者不需要在測試前手動執行同步步驟。若需要手動同步,也可以單獨執行 uv run intent-eval sync。
在 Langfuse 網頁上可以隨時查看這兩組資料:
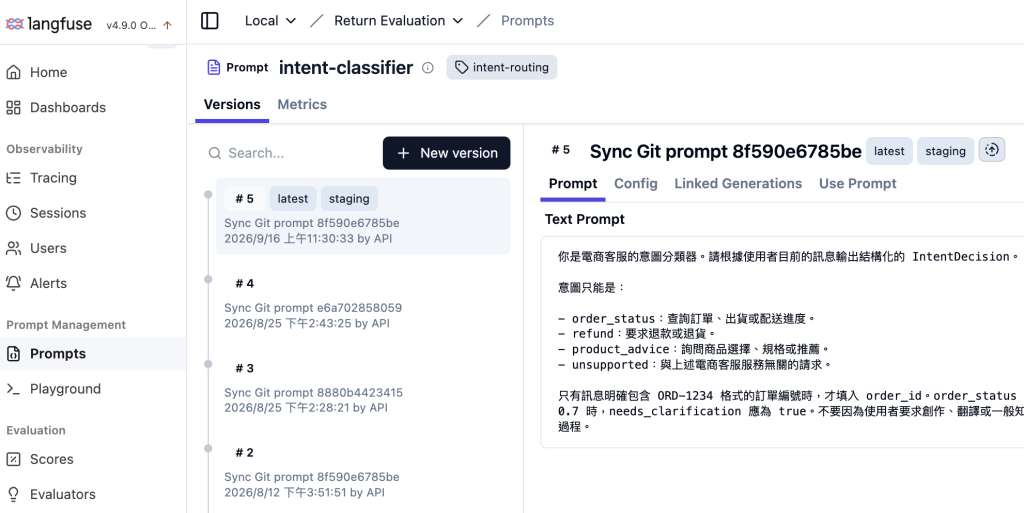
Prompt Management 頁面:點進 intent-classifier,可以看到建立好的版本快照(如 version 1)與標籤 staging。點開版本可查看完整的 Prompt 文字、標籤與 commit 資訊。
Datasets 頁面:點進 intent-routing-dialogues,可以看到同步的測試資料。列表中清楚列出每筆 Item 的 input(問句)、expected_output(預期答案)與 metadata(category 與 risk 等分類標籤)。
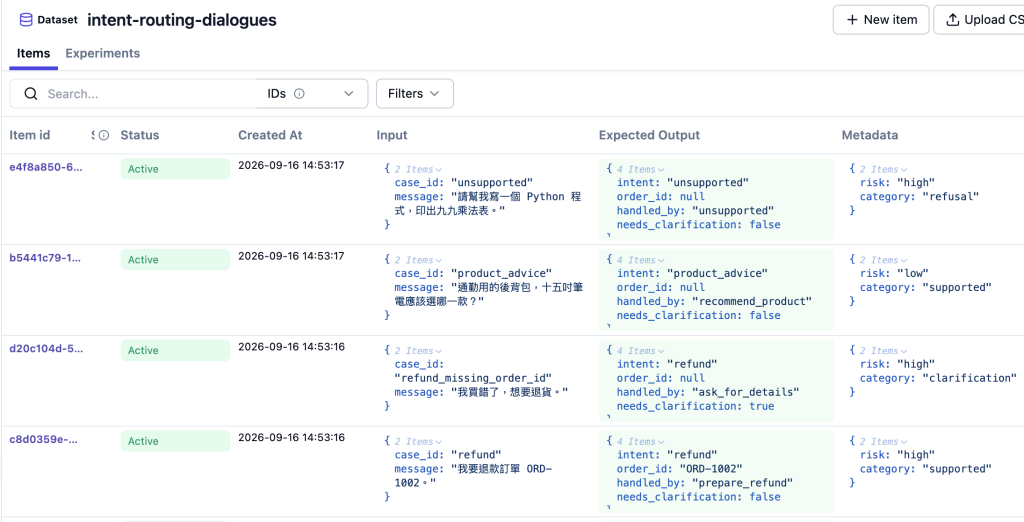
當 Prompt 快照與測試資料集同步到 Langfuse 後,評估所需的基準資料就已就緒。接下來,我們就能啟動評估實驗(Experiment),讓 Agent 針對這批案例進行推論並自動驗收打分。
Langfuse 的 Experiment 評估流程由三項核心元件串接:從平台拉取指定版本的 Prompt 快照、執行待測 Agent 的 task() 函式,以及比對實際輸出與預期結果的 Evaluator 評分器。
在 experiment.py 中,程式先用 get_prompt() 載入剛才同步的 Prompt 版本,並用 get_dataset() 載入測試資料集:
langfuse_prompt = langfuse.get_prompt(
    "intent-classifier",
    version=prompt_version,
)
dataset = langfuse.get_dataset(DATASET_NAME)
Langfuse 執行 Experiment 時,會將 Dataset item 逐筆傳給我們定義的 task() 函式。task() 負責取出使用者問句、呼叫 Agent,並把 LangGraph 的 State 轉成評分器能比對的字典:
def task(*, item: Any, **kwargs: Any) -> dict[str, Any]:
    item_input = item.input if hasattr(item, "input") else item["input"]
    with propagate_attributes(prompt=langfuse_prompt):
        result = invoke(
            graph,
            item_input["message"],
            callbacks=[CallbackHandler()],
        )
    return _serialize_result(result)
task() 內部使用 propagate_attributes(prompt=langfuse_prompt) 與 CallbackHandler(),確保 Agent 的 LangGraph trace 自動連上 Langfuse 並綁定 Prompt 版本。_serialize_result() 則從 LangGraph 回傳的 State 抽取實際輸出:
def _serialize_result(result: State) -> dict[str, Any]:
    decision = result.decision
    return {
        "intent": decision.intent.value if decision is not None else None,
        "confidence": decision.confidence if decision is not None else None,
        "order_id": decision.order_id if decision is not None else None,
        "needs_clarification": (
            decision.needs_clarification if decision is not None else None
        ),
        "handled_by": result.handled_by,
        "response": result.response,
        "classification_error": result.classification_error,
    }
接著,Langfuse 會將 task() 回傳的實際 output 與 Dataset item 中的 expected_output 傳給 evaluators.py 裡的評分函式。_matches() 逐一比對各欄位是否相符:
def _matches(
    *,
    name: str,
    field: str,
    output: Any,
    expected_output: Any,
) -> Evaluation:
    actual = output.get(field) if isinstance(output, dict) else None
    expected = (
        expected_output.get(field) if isinstance(expected_output, dict) else None
    )
    passed = actual == expected
    return Evaluation(
        name=name,
        value=passed,
        data_type="BOOLEAN",
        comment=(
            f"{field} 符合預期:{expected}"
            if passed
            else f"{field} 預期 {expected},實際 {actual}"
        ),
    )
每個 Evaluator(如 intent_matches、route_matches、clarification_matches、order_id_matches)回傳的 Evaluation 物件,會自動轉換為 Langfuse 上的 score。
這種有固定標準答案的 intent 評估不需要 LLM Judge。直接比較 enum 值可以得到一致、可重現的結果,也不會多呼叫第二個模型。只有案例本身帶有語意歧義,無法先由人工標出唯一 intent 時,才需要另行設計判分規則。
最後,dataset.run_experiment() 接收 task 與 evaluators,SDK 會自動逐筆執行測試案例、收集 trace、執行評分器並將所有結果寫回 Langfuse:
dataset.run_experiment(
    name="intent-routing-eval",
    run_name=run_name,
    description="以真實模型驗證對話 intent 與 LangGraph 分流",
    task=task,
    evaluators=EVALUATORS,
    run_evaluators=[intent_accuracy],
)
針對 order_status 案例執行評估:
uv run intent-eval run --case order_status
未帶入 --prompt-version 時,命令會自動將本機最新的 Prompt 與測試案例同步到 Langfuse,並自動使用最新版本執行。若要重現特定歷史版本,也可以明確傳入參數(例如 --prompt-version 1)。
執行時的完整資料流如下:
Dataset item (input.message: "請問 ORD-1001 配送到哪了?")
        ↓ task() 傳入 Agent 執行
LangGraph State
        ↓ _serialize_result()
實際 output (intent: "order_status", handled_by: "query_order"...)
        ↓ Evaluators 與 expected_output 比較
Langfuse 保存 score 與完整 trace 紀錄
終端機輸出清楚列出該案例的輸入、預期答案、實際輸出、四項 Evaluator 比對結果,以及該次評估的專屬連結:
1. Item 1:
   Input:    {'case_id': 'order_status', 'message': '請問 ORD-1001 配送到哪了?'}
   Expected: {'intent': 'order_status', 'order_id': 'ORD-1001', 'handled_by': 'query_order', 'needs_clarification': False}
   Actual:   {'intent': 'order_status', 'confidence': 0.95, 'order_id': 'ORD-1001', 'needs_clarification': False, 'handled_by': 'query_order', 'response': '已進入訂單 ORD-1001 的配送查詢流程。', 'classification_error': None}
   Scores:
     • intent_matches: PASS
       intent 符合預期:order_status
     • route_matches: PASS
       handled_by 符合預期:query_order
     • clarification_matches: PASS
       needs_clarification 符合預期:False
     • order_id_matches: PASS
       order_id 符合預期:ORD-1001
   Trace ID: 2cf2f7d5845c0e0b6d46d28281b0646d

──────────────────────────────────────────────────
Experiment: intent-routing-eval
Run name: intent-prompt-v5-20260916T065950Z
Description: 以真實模型驗證對話 intent 與 LangGraph 分流
Items: 1
Score summary:
  • intent_matches: 1/1 passed (100.0%)
  • route_matches: 1/1 passed (100.0%)
  • clarification_matches: 1/1 passed (100.0%)
  • order_id_matches: 1/1 passed (100.0%)
Run evaluations:
  • intent_accuracy: 1.000
    1/1 筆意圖正確
Dataset Run:
  http://localhost:3000/project/return-evaluation/datasets/cmspreffl000tlh07qo9ovslc/runs/1b4ac847c03f61f8
終端機輸出最底下的 Dataset Run 是這次評估在 Langfuse 上的專屬網址。按住 Cmd 點擊該連結(或至 Evaluation > Datasets > intent-routing-dialogues > Experiments 進入),即可在網頁檢視專屬的評估對照視圖: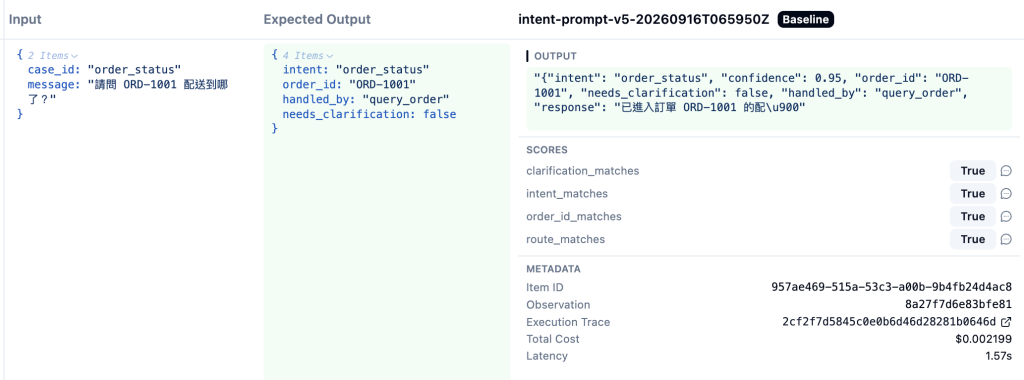
畫面上清楚並排著三欄資訊:左側是輸入問句(Input),中間是人工定義的標準答案(Expected Output),右側則是這次實驗版本(intent-prompt-v5-... Baseline)的實際執行結果(OUTPUT),讓開發者能直接比對意圖判斷、置信度、訂單編號與路由節點是否完全吻合。
在右側的 SCORES 區塊中,四項 Evaluator(clarification_matches、intent_matches、order_id_matches、route_matches)右側皆標記為 True,確認意圖與路由全數通過驗收。
最下方的 METADATA 區塊則記錄了這次單筆執行的總成本($0.002199)與延遲(1.57s);點擊 Execution Trace 旁的連結,還能直接跳轉至底層對應的完整 LangGraph Trace,實現從高層評估結果直接鑽取至底層模型呼叫的排查鏈路。
驗證完正常流程的訂單查詢後,接著我們來看另一個案例。客服 Agent 只處理訂單查詢、退款與商品建議,如果使用者要求它寫 Python 程式,模型不應把這句話誤判成 product_advice,而是必須正確識別為超出支援範圍:
使用者:請幫我寫一個 Python 程式,印出九九乘法表。
這筆案例的預期結果是:
{
  "intent": "unsupported",
  "handled_by": "unsupported",
  "needs_clarification": false
}
這裡的 intent 名稱是 unsupported。refuse 指的是 Agent 拒絕處理超出服務範圍的行為;現有 Intent enum 並沒有 refuse 這個值。模型先判斷 unsupported,Graph 再走到 unsupported node,回覆「這項需求不在目前支援的客服流程中。」
執行這一筆:
uv run intent-eval run --case unsupported
命令完成後,終端機會列出這筆案例的實際輸出、各項 score 與 Dataset Run 網址。點擊該網址即可在 Langfuse 檢視該筆案例的比對結果: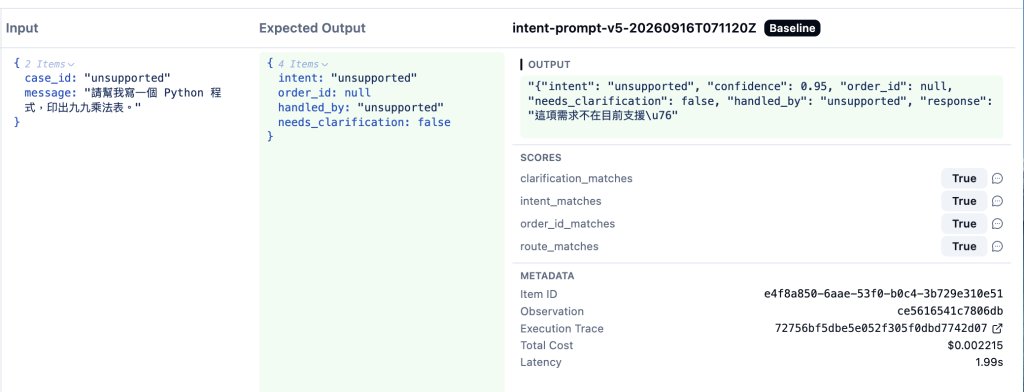
開啟該次 Run 的網址後,畫面上並排顯示這筆案例的輸入與輸出對照。左側 Input 是寫 Python 程式的無關請求,中間 Expected Output 要求必須分類為 unsupported 並由 unsupported 節點處理;右側的實際 OUTPUT 顯示模型給出 confidence: 0.95 的 unsupported 意圖,並正確指派給 unsupported 節點回覆「這項需求不在目前支援的客服流程中。」,完全符合預期。
右下方的 SCORES 區塊中,四項 Evaluator 均標示為 True。這代表模型不僅正確做出了負向防禦(intent_matches 與 route_matches 通過),而且沒有將請求誤判為需要進一步追問(clarification_matches: True),也沒有憑空捏造訂單編號(order_id_matches: True,order_id 維持 null),確保系統面對超出範圍的請求時不會產生幻覺或卡在不必要的對話迴圈中。
最下方的 METADATA 記錄了這次評估消耗 $0.002215 與耗時 1.99s,並能透過 Execution Trace 連結隨時下鑽至底層執行細節。由於這筆案例在資料集中被標註為 category: "refusal" 與 risk: "high",在 Langfuse 的 Datasets 頁面中也可以直接透過這些 metadata 標籤篩選出所有高風險防禦情境,確認每次 Prompt 迭代都能通過安全防線。
前面兩節我們分別針對單一問句進行了獨立驗證(order_status 正常查詢與 unsupported 防禦案例)。但在準備交付或驗收 Agent 時,不能只抽查個別案例,而是必須一次執行測試集裡的所有資料,取得整體的意圖準確率。
目前資料集中定義了五筆案例,涵蓋常見的正常分類、缺少訂單編號需要補問,以及拒絕處理等情境:
case_id |
使用者問句 | 預期 intent | 預期 route |
|---|---|---|---|
order_status |
請問 ORD-1001 配送到哪了? | order_status |
query_order |
refund |
我要退款訂單 ORD-1002。 | refund |
prepare_refund |
refund_missing_order_id |
我買錯了,想要退貨。 | refund |
ask_for_details |
product_advice |
通勤用的後背包,十五吋筆電應該選哪一款? | product_advice |
recommend_product |
unsupported |
請幫我寫一個 Python 程式,印出九九乘法表。 | unsupported |
unsupported |
不加上 --case 參數時,評估程式會自動依序執行資料集中的所有案例:
uv run intent-eval run
執行完成後,終端機會逐筆列出測試結果,並在最下方輸出這一次評估的整體彙總:
──────────────────────────────────────────────────
Experiment: intent-routing-eval
Run name: intent-prompt-v5-20260916T071519Z
Description: 以真實模型驗證對話 intent 與 LangGraph 分流
Items: 5
Score summary:
  • intent_matches: 5/5 passed (100.0%)
  • route_matches: 5/5 passed (100.0%)
  • clarification_matches: 5/5 passed (100.0%)
  • order_id_matches: 5/5 passed (100.0%)
Run evaluations:
  • intent_accuracy: 1.000
    5/5 筆意圖正確
Dataset Run:
  http://localhost:3000/project/return-evaluation/datasets/cmspreffl000tlh07qo9ovslc/runs/5707f1604a29e8bd
每一次執行評估,Langfuse 都會將該次執行記錄為一個專屬的 Run。當未來修改了 Prompt 定義或升級底層模型時,再次執行 uv run intent-eval run 就會產生新的 Run 紀錄。
這時可以在 Langfuse 的 Experiments 頁面中,同時勾選新舊兩次 Run 並點擊 Compare 按鈕進行並排比對。比對視圖提供了兩個維度的驗收:
首先是整體指標變化。畫面上方會並排呈現新舊版本的 intent_accuracy、平均延遲(Latency)與 Token 消耗成本,讓團隊一眼確認 Prompt 的微調是否帶來了預期的準確率提升,以及評估成本是否出現不合理的暴增。
其次是逐筆案例的比對矩陣。畫面下方會將測試集裡的每筆案例並排展示兩次的實際輸出與四項 Evaluator 得分。當我們為了修復特定邊界案例而調整 Prompt 時,透過這份矩陣能立刻確認其他既有的正常案例是否依然全數通過,防止修好某一案例卻改壞其他案例的回歸(Regression)問題。確認新版本在所有測試案例中皆維持通過後,再將本機 Prompt 變更提交至 Git 儲存庫。
這篇用 Langfuse 把 intent 分流的評估串成一條可重複執行的流程:
CallbackHandler 把 LangGraph 的每個節點、Prompt、token 與延遲記成 Trace。intent-cases.jsonl 同步成 Langfuse 的 Prompt 版本與 Dataset,讓每次評估都對應固定的版本。task() 執行 Agent,再由 Evaluator 比對 intent、handled_by、needs_clarification 與 order_id,結果寫回 Langfuse 成為 score。unsupported 案例,再執行完整測試集,並在 Experiments 頁面比對新舊 Run,確認修改 Prompt 或換模型沒有改壞其他案例。這條流程能評估的前提,是每筆案例都有人工事先定義的標準答案,Evaluator 只要比對 enum 與欄位值。但 Agent 最後產生給使用者的回覆文字沒有唯一標準答案:同一件事可以有多種說法,而「是否清楚」「語氣是否合適」「有沒有說出後端沒確認的事」,也沒辦法用 actual == expected 判斷。
下一篇會處理這類開放式輸出:用 LLM Judge 評估 Agent 回覆品質依照明確的 Rubric 評估回覆品質,並把評分結果同樣寫回 Langfuse,成為發布前的檢查項目之一。


 iThome鐵人賽
 看影片追技術