

目的:了解 Pydantic 的驗證階段差異,並能使用 Pydantic 的驗證功能讓 SPEC 設定從格式到意義都正確
我們在 day 23 的文章中提到了 Pydantic 可以自動轉換成設定型別,但我們也知道若 SPEC 格式正確但內容錯誤,會輸出預期外的結果,導致我們很難發現錯誤。因此我們需要檢查例如片號等資料格式、又或是檢查資料之間的關係是否正確(例如若要輸出相減值、要設定 2 個欄位,又或是大小值檢查)。
Pydantic 的強大之處在於它有一套非常完整的驗證機制,我們可以設定驗證的範圍、時機(轉換型別前 or 後/ 實例化前 or 後)。以下便會介紹 Pydantic 的驗證方式,並且提供一個範例讓大家體會 Pydantic 的精妙之處。
在資料科學中,驗證分為以下兩種
語法與型別驗證 (syntactic validation):檢查資料的格式,例如編號是不是整數、電性規格是不是浮點數。Pydantic 可自動轉換型別並處理這裡大部分的需求。
語意與跨欄位一致性驗證 (semantic validation):檢查資料的邏輯合不合理,例如若要統計良率是否合規,則 user 應該要同時設定規格上下限與良率下限、下限需比上限小等
例如有一資料 {'身分':'小學生', '出生年': 1953, '年齡':52},這個資料可以通過型別驗證,因為年齡與出生年是整數、而身份是字串。但很明顯這組資料的語意與跨欄位一致性有問題,出生年與年齡、身分完全對不起來。
語意的錯誤不容易發現,這需要對於資料有背景知識才能判斷 (例如測不準原理也是一個語意驗證),而我們就是對產品最熟悉的那些人(吧)。以下的驗證便是針對語意與跨欄位一致性驗證做設計,再搭配上我們的背景知識,才能防堵異常資料於千里之外。
(物理系大二時會做測不準原理的推導,但是我現在完全忘記了)
我們要實作一個設定輸出項目的 class。首先先建立一個使用 BaseModel 的 class 如下
import numpy as np
from typing import Literal, Self
from pydantic import BaseModel, field_validator, model_validator

class OutputSPEC(BaseModel):
  output_name: str
  check_item_1:Literal['po','w','vf']
  check_item_2:Literal['po','w','vf'] | None = None
  lsl: float | None = None
  usl: float | None = None
  yield_spec:float = 0.0
  cal_way:Literal['avg','yield', 'delta']
我們產品工程師就是對產品、產出設定最清楚的人了,因此在設定驗證前我們可以先把設定之間的關聯、語意都列出來。以下簡單列出幾個:
最小良率設定 yield_spec 需在 0.0~ 100.0 之間
最小值 lsl 當然不可大於等於最大值 usl,且至少需設定一個
若輸出方式 cal_way 是設定 'delta' (差值),則 check_item_2 需要被設定
這些需求皆會在以下的驗證說明中實作。
@field_validator():單一資料的格式驗證Pydantic 的實例化流程大致為 接收引數 → 轉換型別 → 建立模型 (model) → 實例化。其中 @field_validator() 便是在 接收引數 → 轉換型別 這個階段作用的驗證器。
@field_validator() 的使用方式是作為裝飾器放在 method 上方,內部會傳入 property 名稱 與作用階段。傳入 property 名稱 後在實例化過程便會執行本 method、針對該 property 做驗證。若驗證成功會回傳原值;驗證失敗時可 raise error,Pydantic 會自動捕捉失敗。
  @field_validator("yield_spec",mode="after")
  @classmethod # 類別方法
  def validate_yield_spec(cls, value: float) -> float:
      if not 0.0 <= value <= 100.0:
          raise ValueError("最小良率設定 yield_spec 必須介於 0.0 到 100.0 之間")
      return value # 驗證成功,回傳原本值
我們可以看到 @field_validator() 內有一個關鍵字引數 mode="after",這代表這個驗證器會在 Pydantic 轉換型別後才執行。因此若我們帶入的引數是 yield_spec= ' 98.5' 這樣的字串,mode="after" 會先轉換成浮點數 98.5 後再作業。
因為
@field_validator()的作業階段在實例化之前,因此它會是類別方法 (classmethod,對應到 class 而不是實例化後self的方法)。
@field_validator(..., mode="before") 的應用情境在我們的輸入 SPEC 使用情境中,通常會先讓 Pydantic 轉換型別後才作業,因此我們大部分都會使用 mode="after”。
而 mode="before" 適合在資料有特殊轉換規則時使用,避免 Pydantic 轉換出我們預期外的結果。例如下面的範例中我們希望若 user 輸入手機號碼時,若用到整數格式輸入可以先轉換成 0 開頭的字串再進行格式檢查。轉換時加 0 就是特殊規則,因此適合使用 mode="before" 。
class Directory(BaseModel):
    name: str
    phone_number: str

    @field_validator("phone_number", mode="before")
    @classmethod
    def validate_phone_number(cls, number: Any) -> str:
        # 轉為字串並去除前後空白
        _number = str(number).strip()

        # 檢查是否全為數字
        if not _number.isdigit():
            raise ValueError(f"手機號碼必須全為數字,收到的是:{number}")

        # 處理被 Excel 吃掉開頭 0 的 9 碼數字
        if len(_number) == 9:
            _number = "0" + _number

        # 驗證是否為以 09 開頭的手機號碼
        if len(_number) == 10 and _number.startswith("09"):
            return _number

        raise ValueError("手機號碼必須為以 09 開頭的 10 碼數字,請確認輸入內容")
@model_validator(): 整個 class 內資料之間的驗證@model_validator() 是在資料皆已轉換型別、並且建立模型後才執行,因此可以檢查不同資料之間的相互關係。我們前面提到的檢查大小值、條件驗證皆是多資料的驗證,因此會在這個階段才驗證。
@model_validator() 的使用方式如下:
同樣需指定驗證時機。因為我們要確認不同資料的關聯,因此選用 mode="after"
此時已建立暫時之 model,因此引數為 self (整個 model)
檢查若正確即可實例化成物件,因此檢查完後是回傳 self (整個 model)
  @model_validator(mode="after")
  def validate_spec_relationships(self) -> self:
      lsl_is_set = not np.isnan(self.lsl)
      usl_is_set = not np.isnan(self.usl)

      if not lsl_is_set and not usl_is_set:
          raise ValueError("lsl 與 usl 至少需要設定一個")

      if lsl_is_set and usl_is_set and self.lsl >= self.usl:
          raise ValueError("lsl 必須小於 usl")

      if self.cal_way == "delta" and self.check_item_2 is None:
          raise ValueError("cal_way 設定為 delta 時,必須設定 check_item_2")

      return self
驗證器的選用準則大致如下:
驗證轉換前單一資料:使用 @field_validator(..., mode="before")
驗證轉換後單一資料:使用 @field_validator(..., mode="after")
驗證資料之間關聯:使用 @model_validator(..., mode="after")
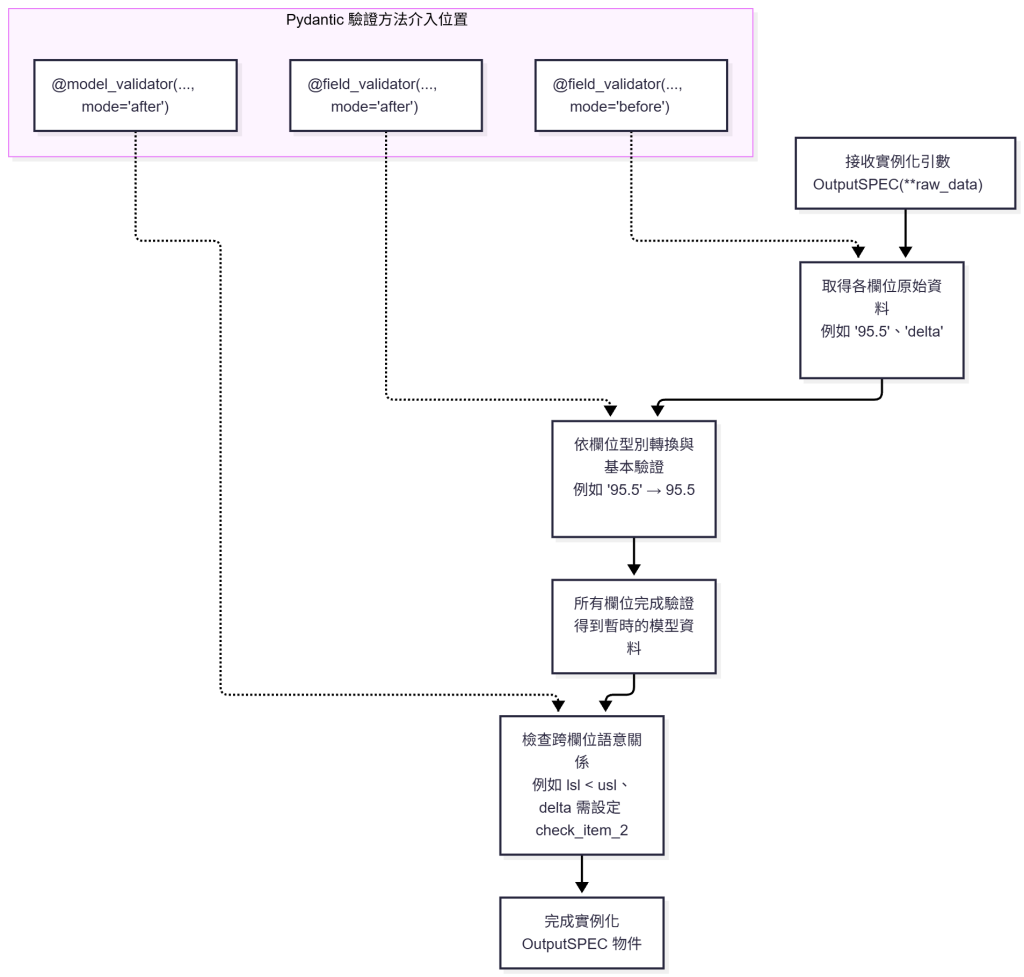
@model_validator(..., mode="before")的使用時機為檢查已轉換完成,但還沒建成模型的階段。因此會用來檢查在 day 23 提到的 “多出來的資料“。例如我們設定的 class 中沒有信用卡號的引數,但我們需要檢查資料端有無流出信用卡號。這時便要用
@model_validator(..., mode="before")來檢查,避免系統會流出卡號但沒人發現。(我們的使用情境不太會用到
mode="before",因此簡單帶過)
當傳入的設定有問題導致無法實例化時,Pydantic 會輸出 ValidationError。這個 ValidationError 也是一個物件,若直接使用 print 會輸出非常繁雜的錯誤資訊 (連 docs 網址都有),裡面只有一行是我們設定的錯誤訊息。
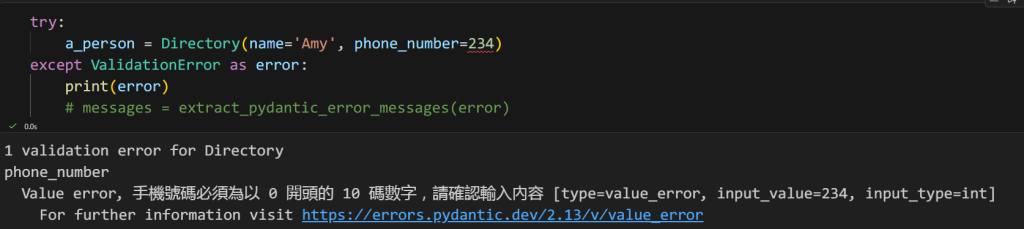
若我們要將錯誤訊息顯示於彈出視窗中,應該要抓取我們設定的訊息即可。我們可以使用以下的方式只抓取我們需要的訊息。
ValidationError 內包含了哪些資訊可以參考這裡
from pydantic import ValidationError
from PySide6.QtWidgets import QMessageBox


def extract_pydantic_error_messages(error: ValidationError) -> list[str]:
    """從 Pydantic ValidationError 中抓取失效訊息"""
    return [
        detail["msg"].removeprefix("Value error, ")
        for detail in error.errors()
    ]
再將昨天 day 23 的 add_data_to_user_spec 加入顯示失效訊息的功能。可以看到 except ValidationError as error 那一段就是格式化失效訊息並將它顯示於彈出是視窗之中。
def add_data_to_user_spec(self) -> None:
    write_spec = "user_spec"
    new_item_name = self.ui.a_lineedit.text().strip()

    # 先讀取表格;空白儲存格等表格錯誤由 Controller 顯示。
    try:
        raw_rows = self.spec_table_manager.extract_table_data(
            parse_value=False
        )
    except ValueError as error:
        QMessageBox.warning(self, "表格資料錯誤", str(error))
        return

    validated_rows: list[dict[str, object]] = []

    # 逐列驗證;任何一列失敗就停止,避免寫入不完整或錯誤資料。
    for row_index, raw_row in enumerate(raw_rows, start=1):
        try:
            validated_row = OutputSPEC.model_validate(raw_row)

        except ValidationError as error:
            # 抓取錯誤訊息並格式化,讓 user 易閱讀
            messages = extract_pydantic_error_messages(error)
            details = "\n".join(f"• {message}" for message in messages)

            # 彈出式視窗通知 user 哪裡失效
            QMessageBox.warning(
                self,
                "SPEC 設定錯誤",
                f"第 {row_index} 列資料有誤:\n{details}",
            )
            return # 有問題就直接停止,不寫入 json

        validated_rows.append(validated_row.model_dump())

    # 全部資料通過驗證後才寫入 JSON。
    self.json_manager.save_user_config(
        spec_name=write_spec,
        new_item_name=new_item_name,
        data=validated_rows,
    )
我們在這 2 天的文章中知道了如何建立資料管理物件以及驗證資料格式與邏輯的方式。
接下來我們會進到下一章節 ”GUI 程式的進階功能設定”,在明天 day 25 的文章中我們會實作自動生成 UI 物件的方法。


 iThome鐵人賽
 看影片追技術