
Day 22 掃 78 題 96.2% AC 看起來強, 但有兩個合理質疑:
這篇換個抽樣法, 用 MCU CPE26 題目選集 當 index — 這 56 題是 MCU 為 2027 起 CPE 檢定分 14 個主題各 4 題挑的題庫, 主題覆蓋面是現成的. 做法:
共 19 題.
| CPE26 主題 | ZeroJudge | UVa | 題名 | NSYSU |
|---|---|---|---|---|
| 輸入格式 | c007 | 272 | TeX Quotes | ★ |
| 字串字元 | e208 | 11541 | Decoding (Run-length) | ★ |
| 日期時間 | j056 | 11650 | Mirror Clock | ★ |
| 算子運算 | a518 | 12468 | Zapping | ★ |
| 質因倍數 | d120 | 10699 | Count the factors | ★ |
| 進制基底 | d379 | 446 | Kibbles n Bits (Hex) | — |
| 二維寫真 | e605 | 10189 | Minesweeper | ★ |
| 規則模擬 | c015 | 10018 | Reverse and Add | ★ |
| 正暴窮舉 | d094 | 478 | Point in Figures | — |
| 二維排數 | d096 | 913 | Joana and the Odd Numbers | ★ |
| 排列組合 | c061 | 530 | Binomial C(n,m) | — |
| 排序處秩 | a539 | 10327 | Flip Sort (逆序數) | ★★ |
| 集合映對 | e706 | 12820 | Cool Word | ★ |
| 堆疊佇列 | e155 | 10935 | Throwing Cards Away | ★ |
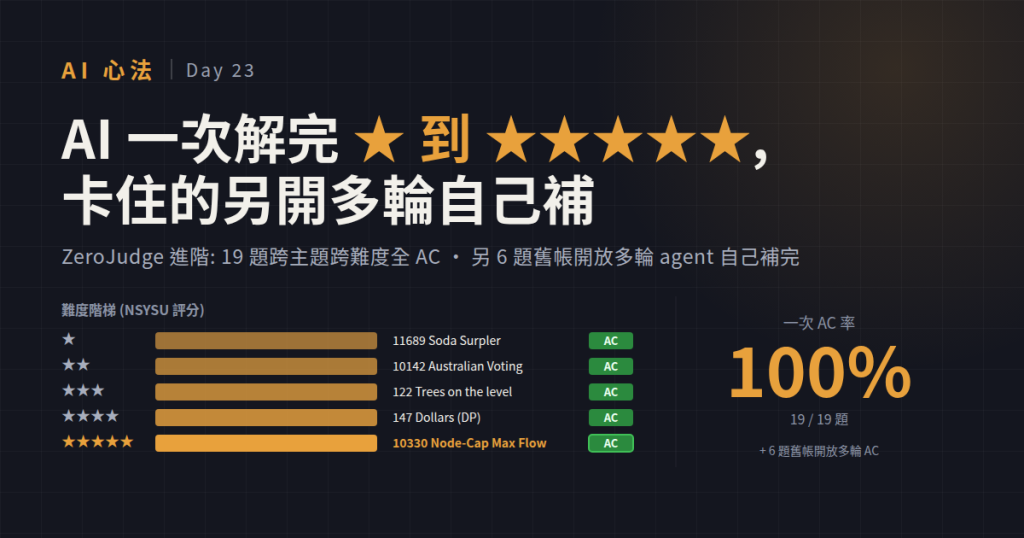
另外 5 題不是為了覆蓋主題, 是刻意從 NSYSU 1 星到 5 星各挑一題, 看難度階梯對 AI 解題成功率跟手感的影響:
| ZeroJudge | UVa | 題名 | NSYSU | 題型 |
|---|---|---|---|---|
| a536 | 11689 | 收集空瓶換汽水 | ★ | 規則模擬 |
| e592 | 10142 | Australian Voting | ★★ | 多輪淘汰模擬 |
| c101 | 122 | Trees on the level | ★★★ | 二元樹建構 + BFS |
| d397 | 147 | Dollars 找零方法數 | ★★★★ | DP |
| d760 | 10330 | Power Transmission | ★★★★★ | 節點容量 max flow |
難度分佈: NSYSU 評分的 16 題裡 ★ 11 題 / ★★ 2 題 / ★★★ 1 題 / ★★★★ 1 題 / ★★★★★ 1 題; 另外 3 題 NSYSU 沒收 (皆 2023+ 新題).
送題規則跟 Day 22 完全一樣: 本機 g++ 跑樣例 → Playwright MCP 送判題 → 單次送出, 不重試.
19 / 19 全 AC. 包含:
從 Day 22 的 96.2% 反而跳到 100% — 不是題變簡單, 是抽樣改變了: 這批 19 題多是 UVa 經典, 比起 Day 22 包含的 ZeroJudge 原生題與校內競賽題, AI 練過的機率更高, 樣例也更乾淨.
這件事本身就是一個觀察: AI 的 pass rate 受「題目有多經典」影響很大, 不只是「難度」. 一題 ★★★★★ 的 max flow 經典題, 比起一題 ★ 但沒出現在訓練資料的校內題, 前者反而容易過.
題意是 power grid 要算最大供電量, 但節點本身也有容量上限 — 不是標準「邊有容量」的 max flow.
教科書做法: 拆點 (node splitting). 把每個節點 v 拆成 v_in / v_out, 中間連一條容量 = 原節點容量的邊; 原本連到 v 的入邊接到 v_in, 從 v 出的邊接到 v_out. 這樣就把「節點容量」降階成標準 max flow.
AI 自己想到拆點, 寫出 Edmonds-Karp, 本機樣例過, 送判一次 AC.
註: 一個合理解釋是, 拆點 + max flow 是教科書 pattern, 在訓練資料裡大量出現. AI 不是「推理出」這個技巧, 更接近「認出題型後取出配方」. 這跟 Day 03 的 LLM 限制分類 說的一致 — 它強在 pattern recognition, 弱在真正新的推理. OJ 題幾乎全在 pattern 範圍內, 所以 AI 的上限看起來特別高.
給一組硬幣面額, 問湊出目標金額有幾種組合. 經典的找零方案數 DP — 不是「最少硬幣」, 是「有幾種組合」, 外迴圈跑面額、內迴圈跑金額才對 (順序反了會變成算排列).
AI 一次寫對, 迴圈順序正確, 送判 AC.
輸入是一堆 (value,path) 格式的節點 (path 是 "LRL" 這種 L/R 字串表示到根的路徑), 要先建樹再做 level-order traversal (BFS). 關鍵在檢查結構一致性 (節點不能被定義兩次, 也不能缺少 parent).
AI 用 map 存節點 + 旗標偵測重複/缺漏, 一次 AC.
單輪送出的 pass rate 低估上限. 把規則從「單次送出就記錄」放寬成「允許多輪」, 其他完全不變 — 一樣是 agent 自己送、自己讀 verdict、自己改、再送, 我只指定題目, 沒餵訊息、沒提示方向. 多題就能爬回來.
分兩種救援型態 — 正確性類 (邏輯 / 邊界 / 範圍條件錯) 跟 效能約束類 (時間 / 記憶體超限).
| 題號 | 當時 | 關鍵 fix |
|---|---|---|
| a095 麥哲倫的陰謀 | Day 22 NA 50% | special-case M == N (全紅帽無白帽) |
| a215 明明愛數數 | Day 22 WA line 7 | n/m 可為負數 + __int128 防 overflow |
| b590 單位分數分解 | Day 22 原本跳過 | 允許多輪後, agent 改用 DFS + 剪枝重寫 |
這幾題一開始邏輯都對、樣例也過, 但判題直接甩 TLE 或 MLE — 效能約束是另一種「公開樣例看不見」的盲區. 救援的方式不是改邏輯, 是換資料結構 / 換演算法 / 換 IO. 跟 A 類一樣, 多輪完全是 agent 自己送判題、讀 TLE/MLE 訊息、自己 refactor.
| 題號 | 當時 | 關鍵 fix | 加速 |
|---|---|---|---|
| s142 最大正方形 | MLE (10MB 限制) | 2D dp → 滾動 1D dp, 邊讀邊算, 不存整個矩陣 | 空間 O(nm) → O(m) |
| s794 1A2B | TLE | 關鍵觀察: 猜測各 (A,B) 桶的大小只取決於數字重數結構, 用小查表 O(1) 查, 只對「最小桶」的提示建完整 bucket | 單輪 O(N²) → O(表) |
| s796 蜂蜜工廠 | TLE | Matroid 貪心 + 線段樹 加速區間可達查詢, 鏈式左移/右移快路徑先試, Kuhn's 二分圖匹配當 fallback | 多個 O(N²) 操作各降 log 階 |
這 3 題都是本機樣例看不出來, 送判題才知道效能不夠. 判題在這裡扮演兩個角色: (1) 給出 TLE/MLE 的明確信號 (2) 強制 agent 跳出「樣例過了就以為對」的錯覺.
兩種救援合起來看, pattern 一致:
Day 22 的解法沒處理 M == N (全部都是紅帽) 這個 edge case. 允許多輪後, agent 從 NA 50% 的訊息自己回推, 修成 (M == N ? M : M+1) AC. 主邏輯對、邊界錯的 WA, 開二輪 loop 最好修.
兩個獨立問題疊在一起: (1) 題目說 n, m 可以是負數, agent 一開始的 while 條件沒處理「n > m 時至少數一個」; (2) 累加可能 overflow long long. 多輪後 agent 自己讀 WA line:7 的訊息, 回頭檢查題目範圍條件, 改成 do-while + __int128 AC.
Day 22 agent 自己讀題後說「樣例對不上, 解題模型未定」就跳過了. 允許多輪後它重新讀題, 改以 DFS 枚舉分母 + 剪枝 的做法重寫, AC.
c500 (AEWE-645 的傷害) 也是 Day 22 卡住的題, 單次送出 NA 0%. 開放多輪後 agent 自己試了幾版還是 NA 0% — 本機樣例全綠, 判題只回「NA 0%」沒給具體 WA 訊息 (這題有 4 個 subtask, 全掛), agent 幾次 refactor 都卡在同一個分數上下, 顯然撞牆了.
撞牆之後 agent 自己打開瀏覽器去 Google, 找到作者寫的解題報告讀了一遍, 才搞懂坑在哪.
d·t 傷害 (t = 離 m 的距離)m ≡ 1 (mod f) 時結果才會不同. 兩組公開樣例剛好一組 f=3 沒碰撞、一組 f=1 但 k 太小沒越過 m, 都測不出差讀懂作者的分佈模型後, agent 一次 refactor (左側數量用 ⌊(m-1)/f⌋+1, 右側位置直接 1+(Lcnt+j)·f), AC.
註: 這題嚴格說算不算 AI 自己解, 看怎麼定義 — agent 不是靠自己推理解出, 是自己去 Google 搜到作者的解題報告才解開. 寫在這裡是因為兩個教訓都值得看: (1) 強判斷標準也有盲區, 當盲區剛好蓋住公開樣例時, 自測全綠也會 WA; agent 自己 brute 對拍只會「跟自己同一個錯誤模型」互相證明對, 要跳出同溫層得找一個跟題目來源獨立的參照. (2) agentic workflow 的「作弊」邊界其實很模糊 — 當 agent 卡住會自己上網找答案, 「AI 自己解」跟「AI 自己 Google」的界線就不清楚了. 這呼應 Day 21 「綠燈不等於對」 — 判斷標準越強, 盲區可能越細.


 iThome鐵人賽
 看影片追技術