
一句話收 Day 11-20: 文字沒有客觀判准. 一段話對不對, 要人讀、要查證、要主觀判斷; 是不是 AI 寫的, 頂多給你機率、給不了鐵證. 累的根源在這 - 人就是唯一的 bottleneck.
原話 (jason3e7):
過去十天花了很多時間, 探討了比較難驗證的文字產出; 接下來要回到比較容易驗證的主場, 程式的產出。
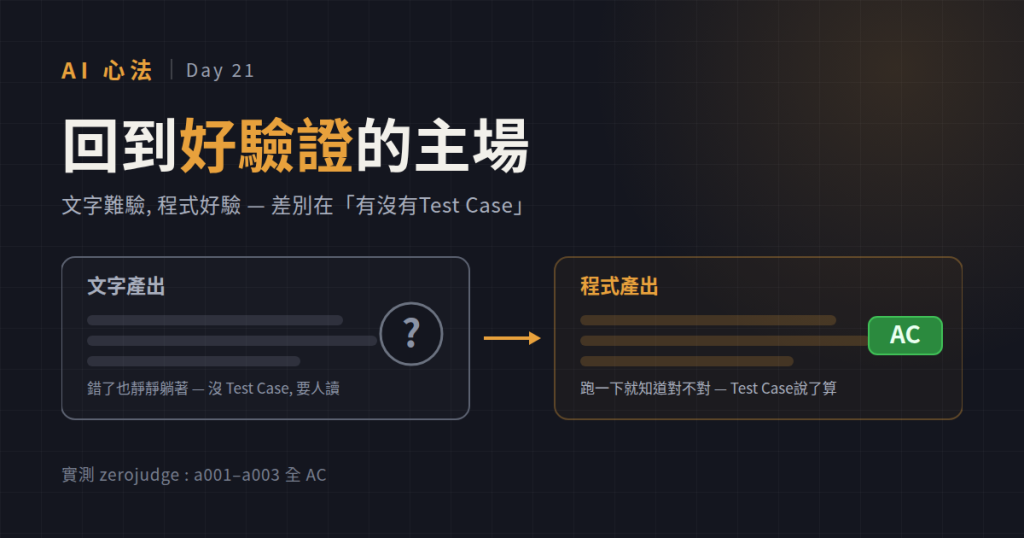
程式跟文字最大的差別, 一句話: 程式有判准, 文字沒有. 判准指「一個能自動告訴你答案對不對的東西」 - 編譯器、執行、測試、diff 都是; 文字幾乎沒有, 沒有「編譯器」會告訴你這段話寫錯了。
關鍵在這句: 錯的程式大多會自己冒出來, 錯的文字只會靜靜躺著。 一個 exception、一條紅色的 CI, 是程式在對你喊「這裡不對」; 一段邏輯怪怪的文字不會喊, 它看起來一樣通順。
驗證難不難不是是非題, 是一條光譜。把文字跟程式擺一起看最清楚:
| 面向 | 文字產出 | 程式產出 |
|---|---|---|
| 有沒有客觀判准 | 幾乎沒有, 靠人讀 | 有: 編譯、執行、測試 |
| 錯了會不會自己冒出來 | 不會, 靜靜躺著 | 大多會: 報錯、紅燈 |
| 能不能自動化 | 很難 | 可以, CI 一鍵跑 |
| 回饋多快 | 慢 (要讀、要查) | 快 (秒級) |
| 可不可重現 | 每次人讀結果可能不同 | 同 input 同結果 |
| 能不能切小塊各別驗 | 難, 對錯是整體的 | 可以, 一個函式一個測試 |
表裡那幾個特性 (客觀、快、可自動化、可重現), 文字一個都給不了。對「驗 AI 產出」這是天大的好消息: 前十天人是唯一的 bottleneck, 回到程式, 機器能幫你擋掉一大半。
註: 不是說程式「一定好驗」、文字「一定沒救」。有些程式超難驗 (並行、分散式、浮點數、UI), 有些文字有明確事實可查 (數字、日期、引用來源)。重點是平均而言程式靠光譜「好驗」那端近得多 - 而且它好驗的理由 (有判准、錯誤會自曝) 剛好是文字最缺的。
最乾淨的例子是 online judge (線上解題系統, 像 ZeroJudge)。你把程式丟上去, 它拿一堆藏起來的測資跑你的 code, 回一個判決: AC (通過)、WA (答案錯)、CE (編譯錯)、TLE (超時)⋯ 這不是「我覺得不錯」, 是一個客觀、秒級、可重複的結果 - 判准長這樣最清楚。
我實際接了一條全自動的小迴圈來玩這件事 (用 Playwright 操作瀏覽器送題):
寫 .cpp → 本機 g++ 編譯、跑範例 → Playwright 自動上傳 → 判題回 AC/WA/CE/TLE → 不過就讀訊息改, 再送
結果: a001、a002、a003 三題都第一次送就 AC。這不是運氣, 是因為上傳前先在本機用同一版 g++ (-std=c++17) 把範例跑過 - 等於先對著判准自測一輪, 再交出去。這就是「有判准」的威力: 你不用猜對不對, 跑一下就知道; 連送出、讀結果都能讓機器代勞。
換成文字呢? 一篇文章沒有「判題系統」會回你 AC 還是 WA。這就是主場跟客場的差別。
回到主場不代表從此輕鬆。程式的判准很強, 但有邊界, 不認清這點會踩更大的坑 - 因為它給你一種「有在驗」的安全感。
Program testing can be used to show the presence of bugs, but never to show their absence.
— Edsger W. Dijkstra
這句話是整段的核心。幾個具體的陷阱:
註: 上面那個 online judge 其實是個比自測更強的判准 - 它有出題者寫的隱藏測資, 會抓到你自己沒想到的 case (WA 就是這樣冒出來的)。但那是解題題目的奢侈: 真實世界的程式很少附一套完整判題, 多數時候判准得你自己建 (寫測試) - 一旦自己建, 又回到「只驗你想到的」這條限制。judge 幫你驗的是「答案對不對」, 驗不了「這題該不該這樣解」。
所以主場不是「不用驗了」, 是「驗得動了, 但要補上機器驗不到的那幾關」: 你想要的終點是什麼、哪裡是不能踩的紅線、誰來看 AI 到底動了什麼。


 iThome鐵人賽
 看影片追技術