iT邦幫忙

2026 iThome 鐵人賽

DAY 22
0
Claude AI

AI 心法三十天:用 Claude Code 當實驗場,從提問、驗證到拓展自己的想像系列 第 22 篇

[Day 22] 掃 ZeroJudge 78 題: 只下 prompt, AI 自己解到 AC

  • 分享至 

  • xImage
  •  

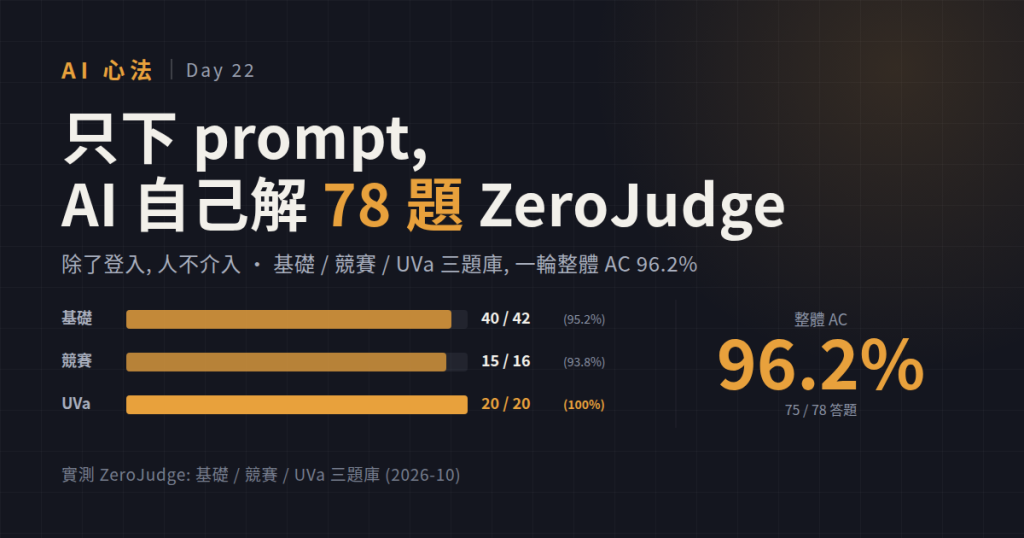
https://ithelp.ithome.com.tw/upload/images/20261006/20078298rtCSm91SnO.png

原本想解更多題、再寫一輪比較完整的統整, 但是 token 已經用完了. 這篇先是現階段的 snapshot, 不是最終版.

為什麼擴大 — Why Scale Up

Day 21 用 3 題證明 "AI 有判准就能自判". 但 3 題太少, 可能是運氣. 這篇擴到 82 題 (實際答 78 題 + 跳過 4 題), 想一次回答三件事:

  1. AI + 判准的 agentic loop 到底能走多遠? 整體通過率是什麼量級
  2. 失敗卡在哪? 是題目難, 還是判准本身的限制 (回應 Day 21 的「綠燈不等於對」)
  3. 什麼題 AI 會自己放棄? 跟真的做錯有本質差別

規則很簡單: 登入是人做的, 其他全部 AI. Claude 讀題網頁、寫 cpp、本機 g++ 編 (-std=c++17) 跑樣例自測, 過了用 Playwright MCP 自動送到 ZeroJudge, 讀回判題結果 (AC/WA/CE/TLE). 不過的話自己讀訊息改, 再送.

測試方法 — The Loop

題號清單 (prompt 給 AI 題目編號)
  ↓
AI 讀題網頁 → 寫 .cpp → g++ 本機測樣例
  ↓ (本機樣例不過: 自己改, 回上一步)
  ↓ (本機樣例過了)
Playwright MCP 自動送 → 讀 AC/WA/CE/TLE → 記錄結果
  ↓
下一題 (不論判題結果, 不重試)

重點: 這是一次性 loop, 不是「不過就再改再送」的多輪 loop. 本機樣例可以反覆改到過, 但一旦送到 ZeroJudge 判題, 不論回什麼 (AC/WA/NA/CE), 記錄下來就下一題. 下面的 pass rate 都是單次送出的結果, 如果開放重試這個數字會更高.

這條迴圈的三個關鍵:

  • 本機先過樣例再送: 送出去前先在本機用同一版編譯器跑過範例, 等於先過一道內建的驗證. 省掉大量「送上去才發現 CE」的無效 round-trip.
  • MCP 送判題全自動: Playwright MCP 做 navigate + 貼碼 + 送出 + 等判題結果.
  • 人: 登入是手動的 (session cookie 到期要重新登), 其他沒有介入. 連「這題看起來不對, 你再想想」都沒說.

規模感 (非精準 metering)

這輪沒逐題打 token 計數, 只能給量級; 下一輪會補精準 per-題 metering.

  • 送判題 MCP: 一批 5–8 題 送出去等 verdict 回來, 大約會打到 Claude Code 單次工具呼叫 120 秒的上限被推到背景 (詳細踩坑另有筆記). 攤到單題大約 15–25 秒 (navigate + 貼程式 + 送出 + 等 verdict).
  • 本機 g++ 編 + 跑樣例: 單題幾秒到十幾秒, UVa 長題目 (3n+1、Skyline 這種) 偏久.
  • Token: 整個 78 題跑下來, 當下的 token 配額就見底了. 題目網頁本身短的幾百字、長的幾千字, 每題還要寫一版 cpp, 錯了讀訊息再改一輪 (如果本機樣例沒過) — 容易題幾千 tokens, 難題 (特別是要反覆讀題釐清需求的) 可以吃到數萬.

結果 — The Numbers

題庫 答題 AC 待修 跳過 題目感
基礎 42 40 2 0 哈囉、閏年、羅馬數字、GCD、迴文、二進位、排序、小字串處理
競賽 16 15 1 4 博弈 DP、剝殼最大子集、凸包頂點、Move-to-Front、Jump Game
UVa 20 20 0 0 3n+1、Blocks、Skyline、Trees on the level、Accordian Patience、Krypton Factor
合計 78 75 3 4 —
  • 整體 AC 率 75 / 78 = 96.2% (不計跳過的)
  • 計入跳過也只掉到 91.5% (75 / 82)
  • UVa 題庫 20/20 全 AC — 經典題目 AI 練過的機率高, 幾乎是零摩擦
  • 基礎 42 題只掉 2 題 (95.2%), 競賽 16 題掉 1 題 (93.8%)

這個數字比我預期 (抓 60-70% AC) 高很多.

失敗跟跳過的差別 — Fails vs Skips

兩件事看起來都是「沒 AC」, 性質完全不同.

失敗 (3 題) — 綠燈不等於對的實證

  • a095 麥哲倫的陰謀 — NA 50% (判題過一半樣例)
  • a215 明明愛數數 — WA line 7 (第 7 筆輸出不對)
  • c500 AEWE-645 的傷害 — NA 0% (完全沒過)

共通點: AI 本機樣例全綠, 以為自己對了. 但 ZeroJudge 有出題者寫的隱藏測資, 抓到 AI 沒想到的 edge case. 這正是 Day 21 「綠燈不等於對」的具體顯現 — 本機樣例過 ≠ 判題全過. 判准越強, 這類失敗越能被精準捕捉.

這 3 題之所以停在失敗, 是因為這次是單次送出的 loop: 判題一回 WA/NA 就記錄下來, 不給 AI 看判題訊息再改一輪. 如果開一個「WA 回去讀訊息、改、再送」的二輪 loop, 這 3 題有機會被救回來.

跳過 (4 題) — AI 自己止損

  • m930 正方型池塘水深 — 題意不明, 樣例對不上
  • b579 恢復分數 — 整數線性系統, 難
  • b590 單位分數分解 — 樣例對不上, 解題模型未定
  • i236 邊緣人 (NPSC2020) — 除數分塊數論, 難

共通點: AI 讀題後自己判斷「做不出來」或「題意不明」, 主動停下不送. 這是意外的好: 不會硬塞一個隨便的答案送上去. 一個「自認解不出而不交」比一個「自信交錯」乾淨多了.

這條線其實跟 Day 13 講的「願意說不知道」同根: AI 願不願意說「我不知道」, 比它說「我覺得這樣」還重要.

我的重點 — Takeaways

  • AC 96% 的前提是「有乾淨 ground truth」. ZeroJudge 是異常強的判准 (出題者寫的隱藏測資), 一般真實專案的測試幾乎沒這麼完整
  • 失敗全是「樣例過但隱藏資沒過」 — Day 21 的綠燈 ≠ 對, 這 3 題是直接的實證. 當你自己寫測試時, 你就是出題者, 想不到的 case 就測不到
  • 跳過 4 題是意外的好 feature: AI 遇到「讀不懂」或「做不出來」會主動止損, 比硬產一個錯答案乾淨

Sources


上一篇
[Day 21] 回到好驗證的主場: 文字難驗, 程式好驗
下一篇
[Day 23] ZeroJudge 進階測試: 按主題各挑一題, 看 AI 的上限跟自動多輪的能力
系列文
AI 心法三十天:用 Claude Code 當實驗場,從提問、驗證到拓展自己的想像 共 24 篇
圖片
  熱門推薦
圖片
{{ item.channelVendor }} | {{ item.webinarstarted }} |
{{ formatDate(item.duration) }}
直播中

尚未有邦友留言

立即登入留言