
Day 17 講 hooks,那是決定性的一層,事件發生就一定執行。Day 18 講 subagent,順帶提到定義檔有一個 skills 欄位可以預載 skill。今天把這個東西正面拆開來講:skill 到底是什麼、怎麼寫、怎麼評測,另外還有一個發現:它現在已經不只是 Claude 的東西,而是一個跨廠通用的開放格式。
先交代資料來源。下面的欄位、限制和行為來自 Claude Code 官方文件、Anthropic 平台文件和 agentskills.io 的規格原文,原文都逐條對照過。評測那一段的範例,是照官方文件的格式做的最小版本,在 Claude Code 2.1.288 上跑過兩輪,輸出是節錄自實際結果,節錄處會標明。
一個 skill 就是一個資料夾,裡面至少有一個 SKILL.md,上面是 YAML frontmatter,下面是給模型看的指令。它跟 Day 17 的 hooks 最大的差別在於誰決定「要不要用」:hooks 是 harness 在事件發生時執行,不需要模型同意;skill 是模型讀了描述,自己判斷該不該載入。所以 hooks 管「一定要發生」的事,skill 管「有的話會做得更好」的事,而模型的判斷靠的幾乎全是一段文字:description。
一個最小的示意 skill 長這樣:
---
name: changelog-entry
description: 依 git 提交紀錄整理一則變更日誌條目。當使用者要寫 release notes 或 changelog 時使用。
---

依下列步驟整理條目:
1. 讀取指定範圍的提交紀錄
2. 依「新增、修正、移除」分組
3. 每項一行,開頭用動詞,不寫提交雜湊
我讀了三份來源:Claude Code 的 skills 文件、Anthropic 平台的 Agent Skills 文件,還有 agentskills.io 的開放規格。它們對同一件事的說法並不完全一致,照其中一份寫,在另一份底下可能不合規。兩邊在人稱上其實一致,平台文件要避開的是「I can help you」這種寫法,它自己的範例也用「Use when…」:
| 項目 | Claude Code 文件 | 平台文件與開放規格 |
|---|---|---|
| 必填欄位 | 全部選填,只建議寫 description |
name 與 description 都必填 |
description 長度 |
與 when_to_use 合計,超過 1,536 字元會被截斷 |
最長 1,024 字元 |
建議取交集:name 和 description 都寫,description 壓在 1,024 字元以內,不用「I」「You」開頭。這樣至少不會違反任何一份文件,不過各份文件對 name 還有一些額外限制,寫之前要對照一次。name 在規格裡最長 64 字元,只能用小寫英文、數字和連字號,頭尾不能是連字號,且要跟資料夾同名。
Claude Code 文件列出的其他常用欄位如下,其中 allowed-tools 在開放規格裡是實驗性欄位,其餘都不在規格內:
| 欄位 | 用途 |
|---|---|
when_to_use |
補充觸發情境,附加在 description 後面 |
allowed-tools |
在這個 skill 被叫用的那一輪,預先核准列出的工具 |
disable-model-invocation |
設成 true,模型就不會自己載入,只能手動叫用 |
user-invocable |
設成 false,使用者不能用斜線叫用,只有模型能載入 |
context |
設成 fork,在分出去的 subagent 裡執行 |
paths |
用 glob 限定,只有處理符合的檔案時才自動啟用 |
hooks |
skill 被叫用時註冊的 hooks |
規格以外的欄位,各家支援程度不同。我查到的是:Cursor 讀 paths 和 disable-model-invocation,VS Code 讀 context、user-invocable 和 disable-model-invocation,但語意不一定跟 Claude Code 相同。另外,上傳到 claude.ai 或走 Skills API 時,多帶規格不允許的欄位會直接報錯,不是被忽略。
skill 設計的核心是漸進式載入,開放規格把它分成三層,Claude Code 的做法大致相同,只是它把所有描述放進一份名單,名單過長時會依預算裁切:
SKILL.md 的全文。規格建議本文不超過 5000 個 token,官方文件也寫了「Keep SKILL.md under 500 lines」。references/、scripts/ 檔案,用到才讀。平台文件特別提醒,引用要從 SKILL.md 直接連出去、只深一層,否則模型可能只讀到一部分。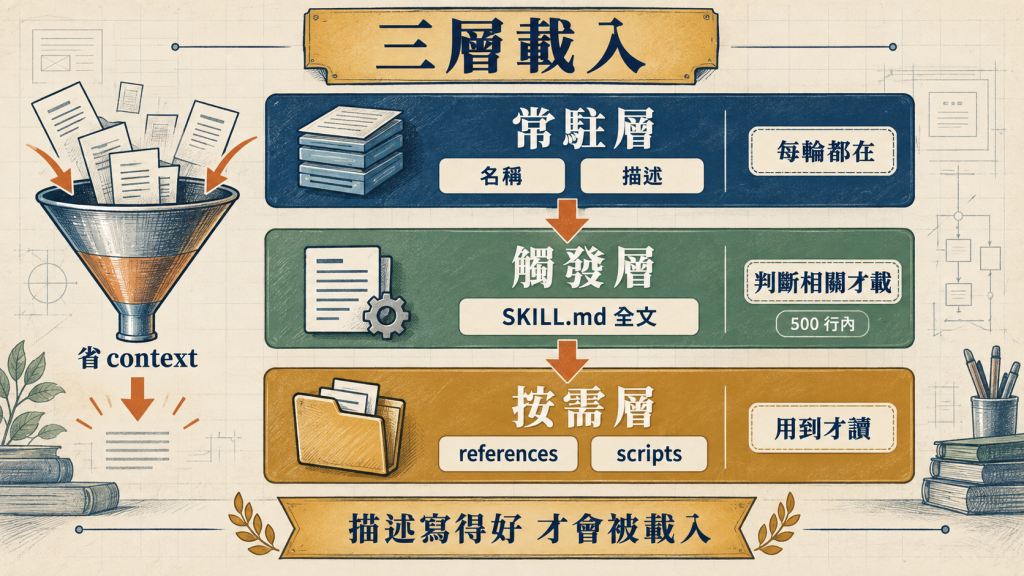
直接後果是:列在名單裡的 skill,描述不管用不用到,每一輪都佔著 context(這是 Claude Code 文件的說法)。所以 skill 不是裝越多越好。
既然模型判斷要不要載入,全靠這一段文字,它的寫法就是整個 skill 成敗的關鍵。像「處理文件的工具」這種描述什麼都沒說:處理什麼文件?什麼時候該用?模型沒有依據判斷,我的推論是結果會偏向其中一端:幾乎不觸發,或是什麼都想觸發。比較好的寫法是同時包含「它做什麼」和「什麼情況該用」:
description: 從 PDF 擷取文字與表格並轉成 markdown。當使用者提到 PDF、要擷取表格,或要把掃描文件轉成文字時使用。
官方文件建議把最關鍵的使用情境放在最前面,因為描述過長時會被截斷。結構就是:第一句講做什麼,第二句講什麼時候用,關鍵字放前面。
過寬和過窄是兩種不同的失敗。過窄是該用的時候沒觸發,要自己手動叫;過寬是不該用的時候也載入,白白佔 context。我推測後者更難發現,因為它不會報錯(這是推論,文件沒有專門討論)。怎麼量觸發準確度,後面評測會講。
這跟 Day 18 的內容很容易搞混。Day 18 的 subagent 定義檔裡,tools 是白名單,沒列就不能用。但 skill 的 allowed-tools 語意完全不同,它只是預先核准:在這個 skill 被叫用的那一輪,列出的工具不用再問你就能用,下一次你送出訊息,授權就清掉了。
換句話說,它是「少問一次」,不是「只能用這些」,官方文件明講它不會限制有哪些工具可用。如果你想用 skill 做權限收斂,這個欄位幫不上忙。要真的禁用某些工具,用 skill 的 disallowed-tools 欄位(在這個 skill 啟用期間把工具從可用池移除),或是 deny 權限規則。disallowed-tools 同樣在你送出下一則訊息時清掉,要整個 session 禁用得用 deny 規則。
三種叫用控制的對照如下:
| 設定 | 你能叫用 | 模型能叫用 | 描述是否常駐 |
|---|---|---|---|
| 預設 | 可以 | 可以 | 是 |
disable-model-invocation: true |
可以 | 不行 | 否 |
user-invocable: false |
不行 | 可以 | 是 |
有副作用的流程(部署、發送訊息)應設成 disable-model-invocation: true,時機掌握在你手上,描述也不佔常駐 context。
Day 18 提過 subagent 的 skills 欄位可以預載 skill。今天補上另一個方向,這兩個很容易搞反:
context: fork:這個 skill 被叫用時,在一個分出去的 subagent 裡跑,用 agent 欄位指定 subagent 類型。方向是「skill 指揮 subagent」。名字有點誤導:context: fork 不是把目前對話分叉出去,subagent 看不到你的對話歷史。skills:這個 subagent 啟動時,把列出的 skill 全文預載進它的 context。方向是「subagent 帶著 skill 出門」。預載有一個限制:設了 disable-model-invocation: true 的 skill 不能被預載,因為那類 skill 本來就是要由人決定時機。
接下來是跨廠的部分。SKILL.md 現在有多家工具在用,但「規範」這個詞要校正。
SKILL.md 現在是一個開放格式,規格站是 agentskills.io,由 Anthropic 發起。我沒有取得開放標準那則公告的一手頁面,查不到獨立的標準組織或治理單位,也查不到規格的版本號,所以它比較準確的說法是「一份被多家採用的格式規格」,而不是「業界標準規範」。
官方文件確認支援的有:OpenAI Codex、Google Gemini CLI 與 ADK(ADK 為實驗性支援)、GitHub Copilot、VS Code、Cursor、JetBrains Junie、Amazon Kiro,以及 Microsoft Copilot Studio(預覽中)。其中官方有明確日期的是:
| 工具 | 官方記載 |
|---|---|
| GitHub Copilot | 2025-12-18 changelog 宣布支援 |
| Gemini CLI | v0.23.0,2026-01-07(preview 版) |
| Cursor | 2.4,2026-01-22 |
| Kiro | 0.9,2026-02-05 |
其他幾家沒查到官方首發日期,不寫日期。規格站自列了數十家採用者,但那是自列、不是認證,本文只列官方文件確認支援的。
這件事對實務的影響有三個:
.agents/skills/,而 GitHub Copilot 和 VS Code 還會直接讀 .claude/skills/。name 和 description 是各家都懂的,context、paths、hooks 這類擴充欄位各家支援不一。要跨工具共用,就把擴充欄位想達成的行為也寫進本文,不要只依賴 frontmatter。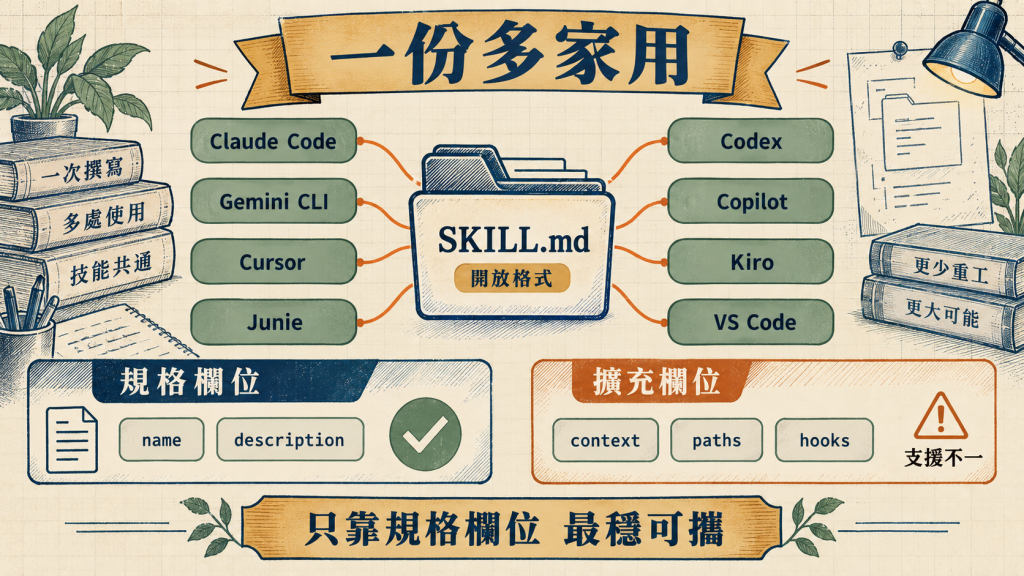
寫完一個 skill,下一個問題是它到底有沒有用。Day 16 講過,一個檢查要敢拿來做決定才算數,skill 也一樣,沒有量測,你只是覺得它好。
官方現在有三個機制,名字很像、用途不一樣:
| 機制 | 量什麼 | 不量什麼 |
|---|---|---|
/skill-doctor |
每個 skill 的成本與被叫用的次數 | 品質評分(官方文件未提) |
claude plugin eval |
在乾淨環境跑 case,用 grader 計分,比較有無 plugin | 需要 plugin 形式 |
| skill-creator(官方 plugin 內的 skill) | evals.json、有無 skill 的通過率比較、description 觸發率調校 |
跟 plugin eval 的 case 檔格式不通用 |
/skill-doctor 依文件標示需要 v2.1.252 以上,claude plugin eval 需要 v2.1.269 以上。官方文件特別說明,skill-creator 的 evals.json 和 plugin eval 的 case 目錄,兩個工具互相不讀對方的檔案。
plugin eval 的 case 是一個目錄,不是單一檔案:prompt.md 放提示,graders/ 底下每個檔案是一個評分器。期望寫成 grader(expected_outcome 欄位只給人看)。評分器有六種:regex、tool_used、tool_order、file_exists、llm、baseline,前四種不呼叫模型,不花錢。範例用的 plugin 只有一個 hello skill,描述是「用海盜口吻打招呼,使用者要海盜式問候時使用」。
第一版的題目是「Ahoy matey style please: give me a pirate-themed hello for my new teammate Sam.」,grader 是 llm、regex(找 Ahoy)和 tool_used 各一個。結果(節錄表格那一行):
CASE   WITH  W/OUT Δ      RUNS COST
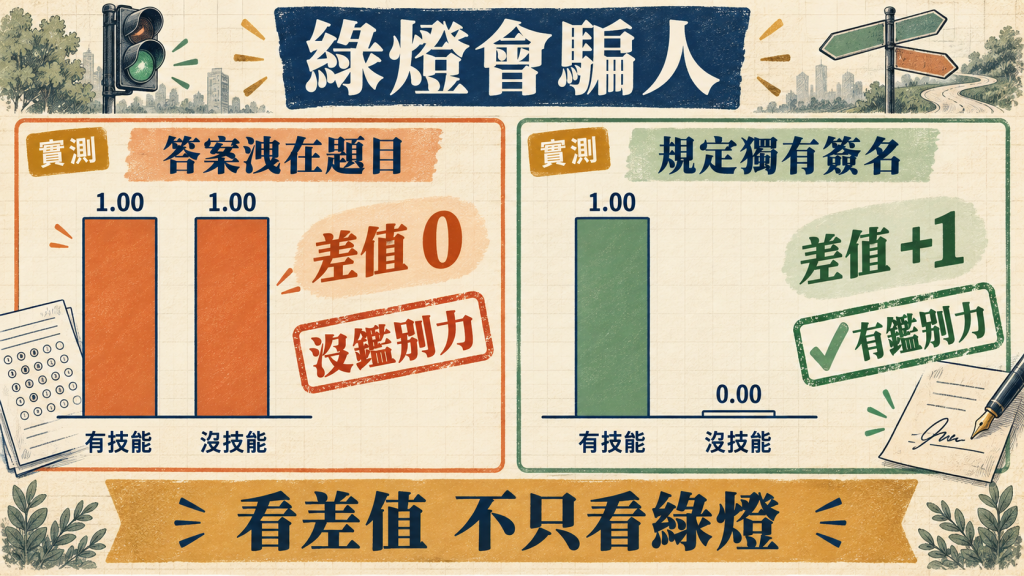
greet  1.00  1.00  0.00   2    $0.05
greet 的分數全綠,但 WITH 是 1.00,W/OUT(沒有 plugin 的基準臂)也是 1.00,差值 Δ 是 0.00。就算完全沒有這個 skill,Haiku 也拿了滿分。原因主要是答案洩在題目裡:除了「Ahoy」還有「pirate-themed」,而 grader 檢查的 Ahoy,正是任何模型被要求海盜口吻時都會寫的特徵。官方文件對這種情況有一句話:如果一個 case 有 plugin 和沒 plugin 都是 1.0,那讓它通過的就不是這個 plugin。
第二版的改法:題目仍留在 skill 的觸發範圍內,但不洩漏任何特徵;SKILL.md 本文規定一個只有它才會產生的簽名;grader 改檢查這個簽名。另外拿掉了 llm grader,描述也從 pirate greeting 改成 pirate-style greeting,對齊新題目。
<!-- skills/hello/SKILL.md -->
---
name: hello
description: Greets the user in pirate speak. Use when the user asks for a pirate-style greeting.
---
Reply with a short pirate-style greeting.
Always end the reply with the exact signature line: [Signed: Captain Hello]
<!-- evals/greet/prompt.md -->
---
max_turns: 5
allowed_tools: [Skill]
---

Give me a pirate-style hello for my new teammate Sam.
<!-- evals/greet/graders/has-signature.md -->
---
type: regex
pattern: 'Captain Hello'
---
另外保留第一版的 tool_used grader(skill-fired.md),檢查 hello 有沒有被叫用。指令是:
claude plugin eval . --trust-plugin --runs 1 --no-publish --model haiku --max-cost-usd 3
輸出(節錄,省略了開頭說明行、每輪的費用、NOTES 欄和兩行摘要):
greet run 1/1 [with]: score 1.00
  ✓ has-signature (weight 1): matched Captain Hello
  ✓ skill-fired [with-only, not scored]: Skill called 1x (expected 1..∞)
greet run 1/1 [without]: score 0.00
  ✗ has-signature (weight 1): pattern not found in last_message
CASE   WITH  W/OUT Δ      RUNS COST
greet  1.00  0.00  +1.00  2    $0.03
有 skill 是 1.00,沒有是 0.00,Δ 是 +1.00,這條 case 才有鑑別力。有兩個但書。第一,--runs 1 每組只跑一次,樣本很小,只能證明這條 case 分得出有無 skill,不能據此評斷 skill 品質,正式使用要用預設的三次以上。第二,with-only, not scored 表示 tool_used: Skill 在雙組比較時只當觸發指標、不計分;要兩組都計分得加 arm: both,寫「不該觸發」的負向 case 會用到。
這是整個評測最有價值的一課:一個全綠的 eval 不代表 skill 有用,要看 Δ。 這跟 Day 16 講的是同一件事:一條有沒有 skill 都會過的檢查,不敢拿來做決定。
另外幾個細節:
Δ 會被報告但不影響退出碼;分數低於門檻、case 載入失敗等會以非零退出碼結束。另一條路是官方的 skill-creator,evals.json 的結構是 skill_name 加 evals 陣列,每題有 id、prompt、expected_output、files 與 expectations(一組可驗證的陳述)。
這裡有一個命名不一致:我本機那份 skill-creator 的 schema 文件寫的是 expectations,但同一個 skill 的說明文字和中間產物裡用的是 assertions。引用時要註明來源檔,不要斷言只有一種叫法。
skill-creator 還有調 description 的流程:
近似題的設計很重要:只用「明確該觸發」的題目,過寬的描述也能拿高分。
平台文件的 best practices 有一條值得抄下來:先建評測,再寫大量文件。流程是先不帶 skill 跑一次找缺口,建三個情境,量基準,寫最小的指引去補,然後迭代,並在 Haiku、Sonnet、Opus 都測過。那一頁說「目前沒有內建方式跑這些評測」,那是平台文件的說法;在 Claude Code 這一側,現在有 plugin eval 可以跑。
claude --version 確認版本,版本需求見前面。name 和 description,1,024 字元內,先講做什麼、再講何時用。SKILL.md 本文壓在 500 行以內,細節拆到 references/,而且只從 SKILL.md 連一層。disable-model-invocation: true;記得 allowed-tools 只是預先核准,要禁用工具得用 disallowed-tools 或 deny 規則。name 和 description,擴充欄位想達成的行為也寫進本文。Δ,不只看綠燈。description 就重跑一次觸發 grader。skill 最容易讓人以為「我寫了就會被用」。實際上它是一段要靠模型判斷才會生效的文字,而生效與否是可以量的。


 iThome鐵人賽
 看影片追技術