iT邦幫忙

2026 iThome 鐵人賽

DAY 24
0
佛心分享-SideProject30

30 天實戰筆記:一個資料科學家用 Side Project 學會 AI Agents 的過程系列 第 24 篇

Day 24|快取入門:同一句搜尋,別讓模型算兩次

  • 分享至 

  • xImage
  •  

上一篇談的是搜尋引擎和 AI 怎麼找到網站。訪客進站之後,很多人接著會用站內搜尋找品牌和商品,而不同的人也常常打出同一句話。這篇要談的,是怎麼用快取(cache)讓同一句搜尋不用每次都從頭算一次:我們會先看沒有快取時會發生什麼事,再說明快取怎麼運作、哪些結果適合放進快取、保存期限要怎麼訂,以及怎麼挑選快取服務。

同一句搜尋重複出現時,沒有快取會發生什麼事?

先想像一下沒有快取的情況。訪客在搜尋框輸入「送男生的植鞣皮夾」,系統會請 AI 模型做兩件事:一是把這句話轉成一組代表語意的數字,也就是查詢向量,讓系統能找到意思相近、但用字不一樣的商品;二是判斷訪客想找的分類和材質,也就是意圖解析,好把這句話變成可以篩選的條件。這兩件事都要呼叫外部的 AI 服務,每呼叫一次就要付一次錢,訪客也要多等一下。

如果下一位訪客也搜尋「送男生的植鞣皮夾」呢?系統完全不記得剛剛算過,會把同樣的兩件事再做一遍,得到一模一樣的結果。假設網站一天有 1,000 次搜尋,其中 300 次是別人搜尋過的句子,每次搜尋要呼叫兩次模型,一天就多了 600 次重複的呼叫,一個月累積下來將近兩萬次。

網站剛上線、流量還小的時候,這些重複的費用可能不太明顯;但只要流量變大,或是換了比較貴的模型,帳單就會跟著搜尋次數一起往上長,訪客等待的時間也一樣。快取要解決的,就是這種「明明算過,卻還要再算一次」的浪費。

快取怎麼讓第二次搜尋不用再算一次?

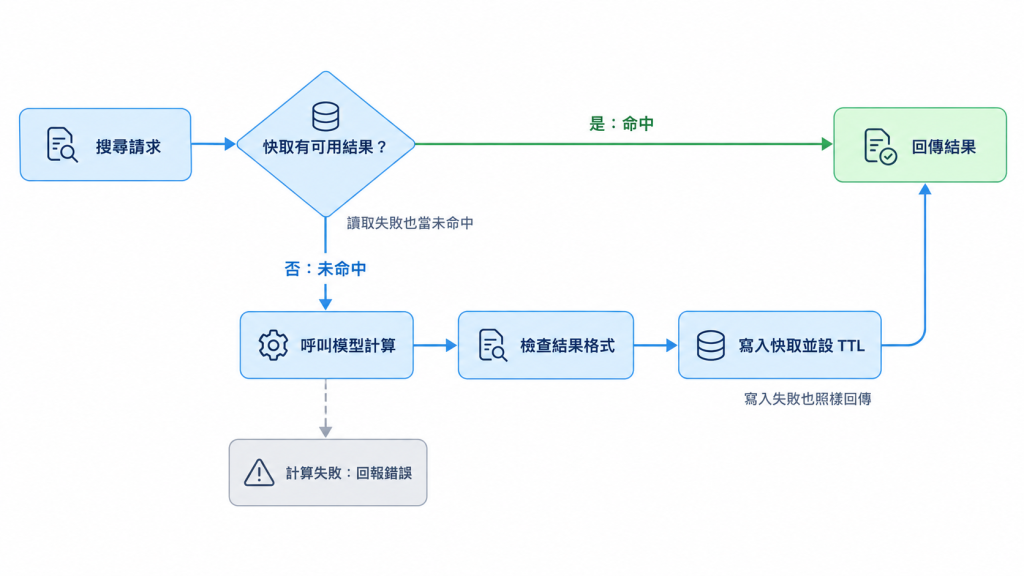
快取的概念很簡單:把算過的結果先存起來,下次遇到同樣的問題,直接拿出來用。以搜尋來說,第一位訪客搜尋「送男生的植鞣皮夾」時,系統照常呼叫 AI 模型,算完之後順手把結果存進快取;第二位訪客搜尋同一句話時,系統先去快取裡找,找到了就直接用,不用再呼叫一次模型。

快取裡的每一筆資料都用一個鍵(key)來找,就像用編號在抽屜裡找東西。每次查快取,會遇到三種情況:

  • 命中(cache hit):找到之前存的結果,直接拿來用。
  • 未命中(cache miss):沒找到,只好照原本的流程算一次,算完再存起來,留給下一個人用。
  • **過期:**每筆資料都有保存期限,稱為存活時間(Time to Live,TTL),時間一到就會被清掉,下次要重新計算。

不過快取也有成本:多了一個服務要維護,讀寫要花一點時間,存著的結果也可能已經過時。如果一個計算本來就很便宜,或是幾乎沒有人會重複查,加了快取反而只是多一道手續。所以在動手之前,要先想清楚什麼東西值得放進快取。

哪些結果適合放進快取,哪些不適合?

放錯東西進快取,輕則省不到錢,重則讓訪客看到過時、甚至不該看到的資料。比較適合放進快取的結果,通常有這幾個特徵:

  • 常常有人重複要:例如熱門的搜尋詞、大家都會看的頁面。
  • 算一次很貴或很慢:例如呼叫 AI 模型,或是很複雜的資料庫查詢。
  • 結果只取決於少數幾個條件:而且這些條件都能放進鍵裡,例如查詢向量只取決於搜尋文字和用的模型。
  • 晚一點更新也沒關係:例如分析出來的分類,就算過幾天才更新,影響也不大。

反過來,下面這些就不太適合:

  • 跟個人有關、或牽涉權限的資料:例如某個人的收藏清單、後台的管理資料,放進大家共用的快取,可能會被別人看到。
  • 變動很快、又一定要即時正確的資料:例如商品價格、是否還有販售。
  • 受到太多條件影響的結果:條件一多,兩個人剛好條件完全相同的機會就很低,存了也很少用得到。
  • 本來就很便宜的計算:直接算可能比查快取還快。

用這些條件,回頭看我們正在做的選物網站,也就是一個介紹台灣小品牌的網站。它的站內搜尋同時用了幾種方法找商品,稱為混合搜尋,一次搜尋會經過三條路:

  • 向量檢索:請 AI 模型把搜尋文字轉成查詢向量,再找意思相近的商品。
  • 詞彙檢索:直接用「植鞣」「皮夾」這些字比對商品內容。
  • 意圖解析:請 AI 模型判斷想找的分類和材質,例如分類是皮夾、材質是植鞣皮,再拿來篩選商品。這一步只在句子比較完整、像在描述需求時才會做,短短幾個字的搜尋會直接略過。

其中查詢向量和意圖解析都要呼叫 AI 模型,算一次不便宜,結果又只跟搜尋文字有關,正好符合適合快取的條件,所以我們把這兩個結果存起來。
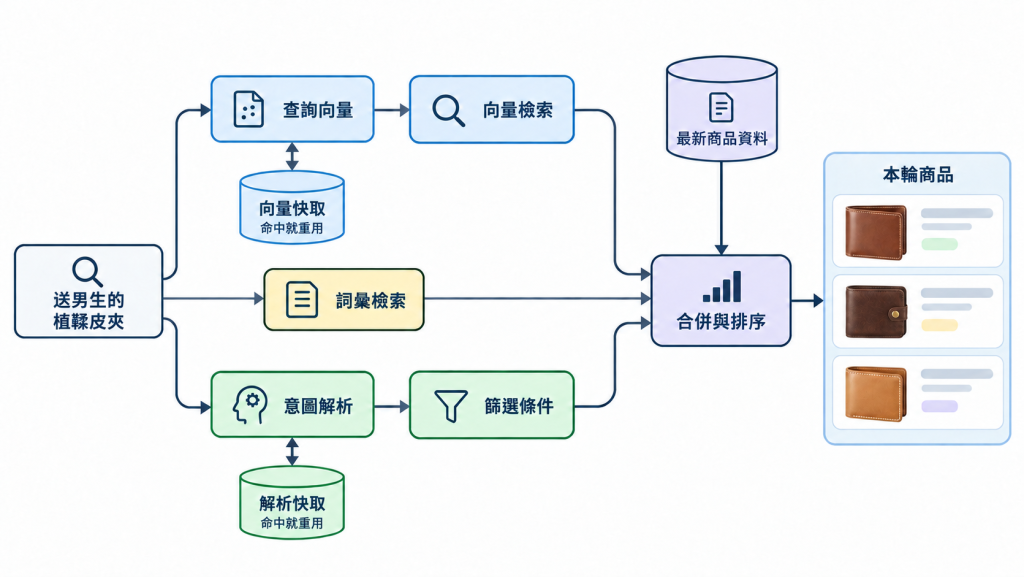
https://ithelp.ithome.com.tw/upload/images/20261008/20184246jAyVz20IzG.png

整份搜尋結果就屬於不適合的那一類。兩個人可能選了不同的價格範圍、排序方式,看的是不同頁數;商品也可能剛改價或下架,舊的結果馬上就不準了。所以我們只存跟搜尋文字有關的中間結果,每次再用最新的商品資料和這一次的條件找商品,商品一有變動,下一次搜尋就會反映出來。

保存期限要訂多久,資料更新後才不會一直看到舊的?

保存期限訂得太短,一筆結果還沒被用到幾次就被清掉,省不了多少;訂得太長,資料更新之後,訪客可能好一陣子都還看到舊的結果。訂之前可以先問自己兩個問題:這筆資料多久會變一次?變了之後,晚多久被看到還可以接受?

我們目前的設定是:查詢向量保存 24 小時,意圖解析保存 7 天。你可能會問:查詢向量只要模型不換就不會變,模型名稱也已經放進鍵裡了,為什麼還要設保存期限?因為保存期限除了處理資料過時,也控制快取的大小。很多搜尋只會出現一次,如果每一筆都永遠留著,快取會越存越多,費用也跟著增加;所以就算結果不會過時,通常還是會設一個期限,讓很少被用到的資料自己清掉。這兩個數字是我們的取捨,不是標準答案,你的專案可以依照資料變動的頻率和能接受的延遲來調整。

不過,保存期限只決定一筆資料最多能放多久,沒辦法發現規則已經改變。要讓更新真的被看到,還需要搭配其他做法:

  • 把版本放進鍵裡:規則或模型一換,鍵就跟著變,舊的結果自然不會再被讀到。
  • 資料更新時主動清掉:例如某筆資料一改,就把相關的快取刪掉,不用等它自己過期。
  • 一定要即時正確的東西不要快取:就像前面沒有快取整份搜尋結果,商品的價格和上下架狀態才不會停在舊資料。

以選物網站的鍵為例,鍵裡會放進所有會改變答案的東西:

  • 查詢向量:鍵包含格式版本、模型名稱和搜尋文字,形如 emb:v1:模型名稱:查詢雜湊。同一句「送男生的植鞣皮夾」,換了模型,算出來的向量就不一樣,所以模型名稱一定要放進去。
  • 意圖解析:鍵包含解析器版本、分類與材質清單的版本,以及搜尋文字。分類清單一更新,鍵就跟著換掉。

鍵裡的查詢雜湊(hash),是把搜尋文字轉成一段固定長度的代碼:同樣的文字一定會得到同樣的代碼,長短不一的句子也能變成整齊的鍵。
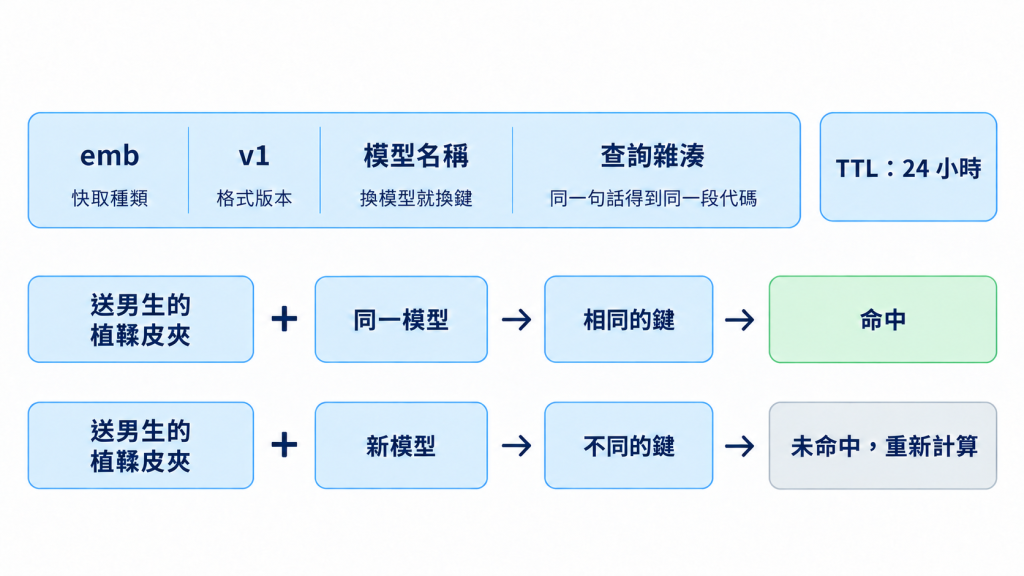
https://ithelp.ithome.com.tw/upload/images/20261008/20184246OvcMYECboG.png

存之前,我們也會先整理搜尋文字,讓意思一樣的句子能共用同一筆結果。例如意圖解析會拿掉標點和空白,「送男生的植鞣皮夾?」和「送男生的植鞣皮夾」就會用到同一筆結果,因為多一個問號,並不會改變想找的分類和材質。

有一種情況要特別小心:分類的名稱沒變,但判斷的方式調整了。這時鍵不會自動改變,舊的結果還是會被讀到,所以我們會手動把解析器的版本往上加,讓舊的鍵不再被使用。

市面上有哪些快取服務,又該怎麼挑?

決定要快取什麼之後,接著要決定快取放在哪裡。快取可以放在很多地方,每一種省下的工作都不一樣:
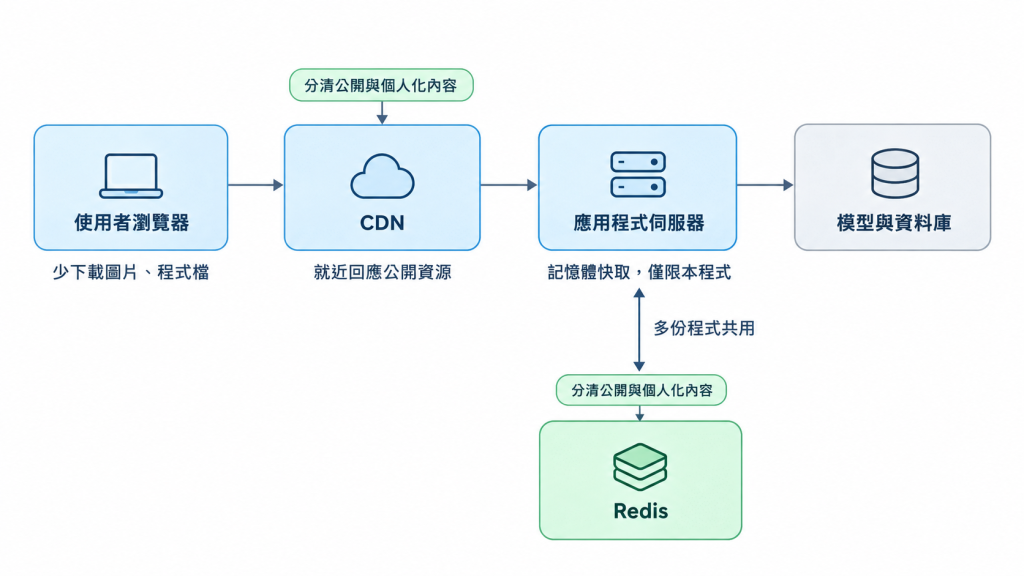
  • 瀏覽器:存在訪客自己的電腦或手機裡,少下載一次圖片和程式檔。
  • CDN:存在離訪客比較近的伺服器,替大家共用的公開內容加速。
  • 伺服器記憶體:存在程式裡,最容易開始;但程式一重啟就沒了,而且網站流量變大時,同一個程式常會同時開好幾份來分擔,每一份的記憶體並不會互通。
  • 專門的快取服務:例如 Redis,好幾份程式可以共用同一份快取,代價是多一次連線和服務費用。

https://ithelp.ithome.com.tw/upload/images/20261008/20184246uy1e59PjPh.png

像搜尋這種在伺服器上算出來、又要讓每一份程式都能共用的結果,通常會放在 Redis 這類專門的快取服務。常見的選擇有這幾種,選物網站用的是第一種:

  • Upstash:代管的 Redis 服務,可以依請求次數計費,也能直接透過網址(HTTP)存取,很適合跑在無伺服器(serverless)平台上的程式。
  • Redis Cloud:Redis 官方的代管服務,也有免費方案可以先試用。
  • 部署平台內建的 Redis:像 Railway 這類部署平台,可以直接在專案裡加一個 Redis,跟程式放在一起,帳單也集中在同一個地方。
  • Cloudflare Workers KV:分散在全球各地的鍵值儲存,讀取很快,但寫入要一段時間才會同步到各地,比較適合很少變動、讀取次數很多的資料。

挑選的時候,可以先看這幾件事:

  • 程式跑在哪裡:如果用的是無伺服器平台,程式不會一直開著,記憶體留不住資料,就需要外部的快取服務,而且最好能直接用 HTTP 存取。
  • 流量有多少:流量小、又不穩定時,用多少付多少的計費比較划算;流量大又穩定時,固定月費的方案可能比較便宜。
  • 已經在用哪個平台:部署平台本身就有提供 Redis 的話,直接用通常最省事。
  • 離程式多近:快取服務最好跟程式放在同一個地區,不然每次查快取,都要多等一段網路傳輸的時間。

剛開始做的話,選一個有免費方案、設定簡單的就好;等流量和費用真的長出來,再回頭比較也不遲。

實際動手時,你不一定要自己寫快取的程式,可以請 AI 工具幫你加上,只是要把這幾件事交代清楚:

  • 要快取哪一個結果:例如「把搜尋文字轉成向量的結果」,而不是整份搜尋結果。
  • 鍵要包含什麼:除了搜尋文字,也要放進模型名稱、版本這些會改變答案的東西。
  • 保存多久:依照資料多久會變、能接受多舊的結果來訂。
  • 快取連不上時怎麼辦:照原本的流程計算,不能讓搜尋跟著失敗,下一節會再說明。

快取壞掉的時候,搜尋還能不能正常運作?

快取只是用來加速的,就算它壞了,搜尋也不應該跟著壞。我們的做法是:

  1. 先查快取,查到就直接用。
  2. 查不到,或是快取服務連不上,就當作沒查到,照原本的流程呼叫 AI 模型。
  3. 算完存回快取;存不進去也沒關係,照樣把結果回傳給訪客。

https://ithelp.ithome.com.tw/upload/images/20261008/20184246o5fRos7heq.png

這種「快取壞了照常運作」的設計,叫做故障放行(fail-open)。不過它只適合純粹用來加速的快取;如果快取存的是「這個人有沒有權限」這類結果,讀不到就應該拒絕,不能直接放行。

另外要記得,快取一壞,原本省下來的模型呼叫會全部回來,費用和等待時間都會上升,所以最好替 AI 模型設好用量上限,例如每分鐘最多能呼叫幾次,避免費用突然暴衝。如果兩個人剛好同時搜尋同一句話,兩邊都會沒查到、各算一次;這種情況通常不多,等重複的費用明顯變高再處理就好。

至於快取到底有沒有效,最直接的是看命中率,也就是查快取時有多少比例真的找到。例如一百次意圖解析裡有六十次命中,就省下了六十次模型呼叫。不過搜尋還有其他步驟要花錢、要等待,總費用不會跟著少六成,所以也要一起看模型實際被呼叫的次數、整次搜尋的等待時間和總費用。


上一篇
Day 23|網站上線了,Google 和 ChatGPT 找得到嗎?SEO 與 AEO 入門
下一篇
Day 25|選模型入門:能力、速度和價錢怎麼取捨,帳單又該怎麼控制?
系列文
30 天實戰筆記:一個資料科學家用 Side Project 學會 AI Agents 的過程 共 25 篇
圖片
  熱門推薦
圖片
{{ item.channelVendor }} | {{ item.webinarstarted }} |
{{ formatDate(item.duration) }}
直播中

尚未有邦友留言

立即登入留言