

上一篇談的是訪客進到網站之後的事:他們有沒有找到值得了解的品牌,又該用哪些指標來判斷。不過在那之前,訪客得先找得到這個網站。假設網站上有一個台南手工皮件品牌的介紹頁,品牌故事、使用的皮料和價位都寫得很清楚,但有人在 Google 搜尋「台灣手工皮件品牌」時,結果裡可能根本沒有它;請 ChatGPT 推薦幾個台灣的皮件品牌,回答裡也不一定會提到它。
這篇會先說明搜尋引擎是怎麼找到並理解一個網頁的,也就是搜尋引擎最佳化(Search Engine Optimization,SEO)在處理的事;接著談最近常聽到的答案引擎最佳化(Answer Engine Optimization,AEO),你會發現它和 SEO 底層的邏輯其實差不多;最後再整理一個剛上線的網站,可以做哪些事讓網頁更容易被找到,以及做完之後怎麼確認有沒有效。
搜尋引擎處理一個網頁,大致會經過四個階段:
爬蟲來過,不代表頁面已經被收錄;即使被收錄了,也不保證在某個關鍵字會有好的排名。SEO 要做的就是讓網頁順利走完這四個階段:網頁沒出現在搜尋結果裡時,先弄清楚它卡在哪個階段,才知道該從哪裡改。
(以下為假設的案例)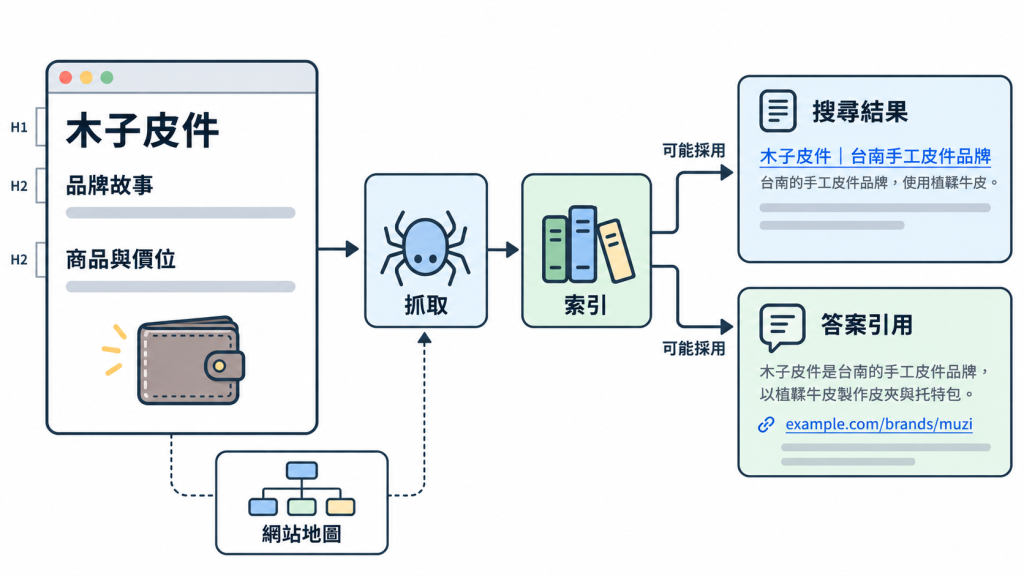
除了 Google,現在越來越多人會直接問 ChatGPT、Perplexity,或是看 Google 搜尋結果最上方的 AI 摘要(AI Overviews)。這類服務通常被稱為答案引擎(answer engine),它們不會只給你一排連結,而是直接整理出一段回答,再附上引用的來源。AEO 在意的,就是怎麼讓自己的網頁成為這段回答引用的來源。
AEO 聽起來像是一套全新的做法,但拆開來看,答案引擎前面的步驟跟搜尋引擎幾乎一樣:它也要先找到網頁、讀取內容,再判斷這個來源可不可信。有些 AI 服務在回答之前,甚至會先上網搜尋,再從搜尋結果裡挑內容來用。Google 也清楚的表示要出現在 AI Overviews 和 AI Mode(Google 搜尋裡的對話式搜尋),靠的仍然是一般的 SEO 基礎,不需要額外標示給機器讀的格式,也不需要另外準備一份給 AI 讀的檔案(例如有人提倡的 llms.txt)。
接下來這篇文章我們會談論 SEO / AEO 的基本入門知識,讓我們可以讓文章被機器有效爬取。
回到前面那個皮件品牌頁。想讓它更容易被找到,可以從四件事著手:把內容寫清楚、讓爬蟲找得到、決定哪些頁面該被收錄,以及擋掉惡意的爬蟲。網站剛上線、時間有限的話,先確認爬蟲讀得到內容、提交網站地圖,再慢慢把內容補完整;擋爬蟲的部分,可以等網站開始有流量再處理。
搜尋「台灣手工皮件品牌」的人,想知道的通常是:這個品牌做哪些東西、用什麼皮料、價位大概多少、在哪裡買得到。品牌頁把這些問題一一交代清楚,會比在頁面上重複十次「手工皮件推薦」更有用,因為搜尋引擎在判斷的,是這一頁能不能回答搜尋者的問題,不是關鍵字出現了幾次。
網站裡的頁面也最好各有分工:
頁面之間再互相連結,連結文字直接說明點進去會看到什麼,例如「看看其他台灣皮件品牌」,不要只寫「點這裡」。這樣搜尋引擎比較容易看懂每一頁的主題,以及頁面之間的關係。
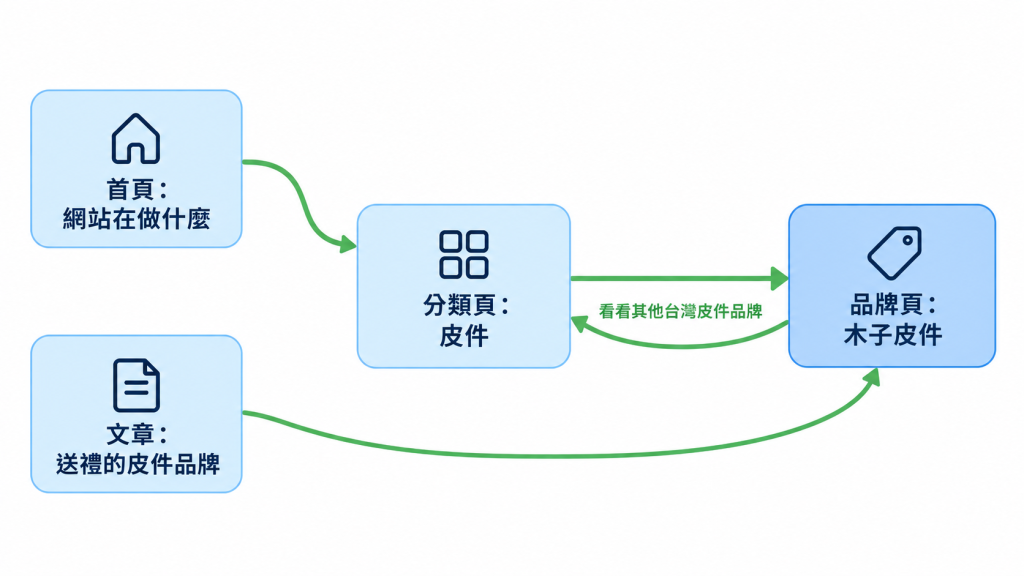
搜尋引擎也會判斷內容可不可信,以此作為評分的標準,以選物平台的頁面來說我們可以努力做到以下幾點:
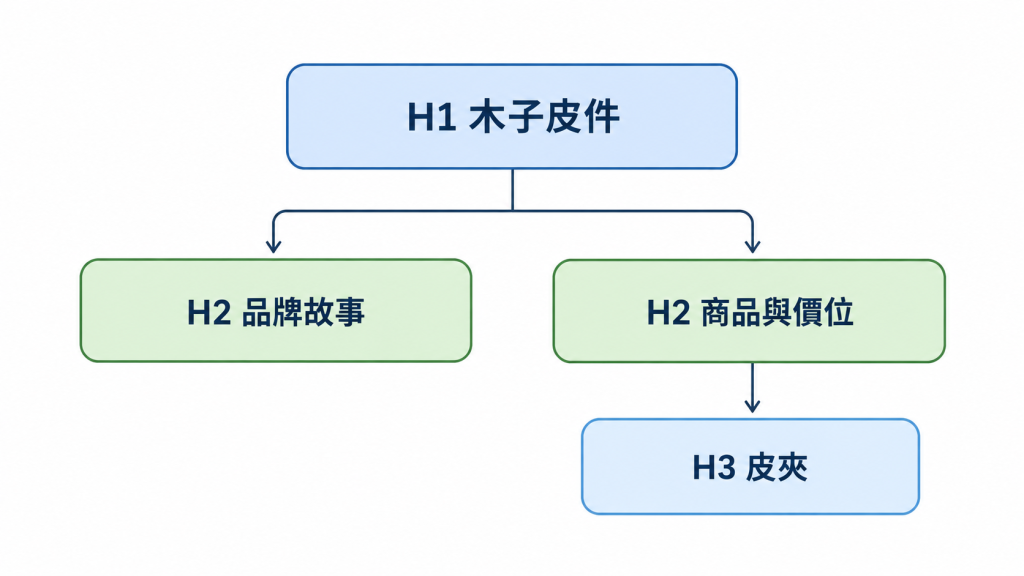
除此之外,頁面的結構也會影響搜尋引擎和答案引擎怎麼理解內容,因為它們會參考標題,判斷每一段在講什麼。HTML 是網頁用來標示內容結構的語言,其中 H1 是頁面的主標題,H2、H3 是底下一層一層的段落標題。標題代表的是內容的層級,不是字體大小;只看標題時,它們讀起來應該像一份目錄。
<head>
  <!-- title 是搜尋結果和瀏覽器分頁上顯示的標題 -->
  <title>木子皮件|台南手工皮件品牌</title>
  <!-- meta description 是搜尋結果摘要的候選文字 -->
  <meta name="description" content="木子皮件是台南的手工皮件品牌,使用植鞣牛皮製作皮夾與托特包。">
</head>
<main>
  <h1>木子皮件</h1>
  <section>
    <h2>品牌故事</h2>
    <p>……</p>
  </section>
  <section>
    <h2>商品與價位</h2>
    <h3>皮夾</h3>
    <p>……</p>
    <a href="/categories/leather">看看其他台灣皮件品牌</a>
  </section>
</main>
另外還有兩個常被忽略的細節:
<title> 和 meta description 會影響搜尋結果上顯示的標題與摘要,但搜尋引擎不一定照用,有時會改從正文挑一段更符合搜尋的文字。剛上線的網站外部連結很少,爬蟲不容易順著連結找進來,所以網站地圖特別重要:它直接告訴搜尋引擎網站上有哪些公開網址。網站地圖可以提交到 Google Search Console,這是 Google 提供的免費工具,用來查看網站在 Google 搜尋上的狀況。提交時有幾件事要先知道:
找到網址之後,爬蟲還要讀得到內容。有些 AI 建站工具做出來的網頁,內容要等瀏覽器執行 JavaScript 之後才會出現,但根據 Vercel 在 2024 年底的觀察,OpenAI 和 Anthropic 的爬蟲都不會執行 JavaScript;Google 雖然會,時間點也不一定。所以品牌介紹、商品資訊和頁面之間的連結,最好在伺服器回傳的 HTML 裡就已經存在。檢查方法很簡單:
這些 <title>、meta description 和網站地圖,通常不用自己一行一行寫。用 AI 工具或 Next.js 這類框架建站的話,大多可以自動產生,直接請 AI 工具幫你加上結構化資料(structured data)。
不是每一頁都適合出現在搜尋結果裡:後台管理頁、測試環境不該被外人看到;內容太少的頁面,就算被收錄了,也很難回答搜尋者的問題。
這時可以用三種設定來控制,但它們很容易被搞混:
robots.txt,告訴遵守規則的爬蟲哪些路徑不要讀。noindex,請搜尋引擎不要收錄這一頁;前提是爬蟲要讀得到這個設定。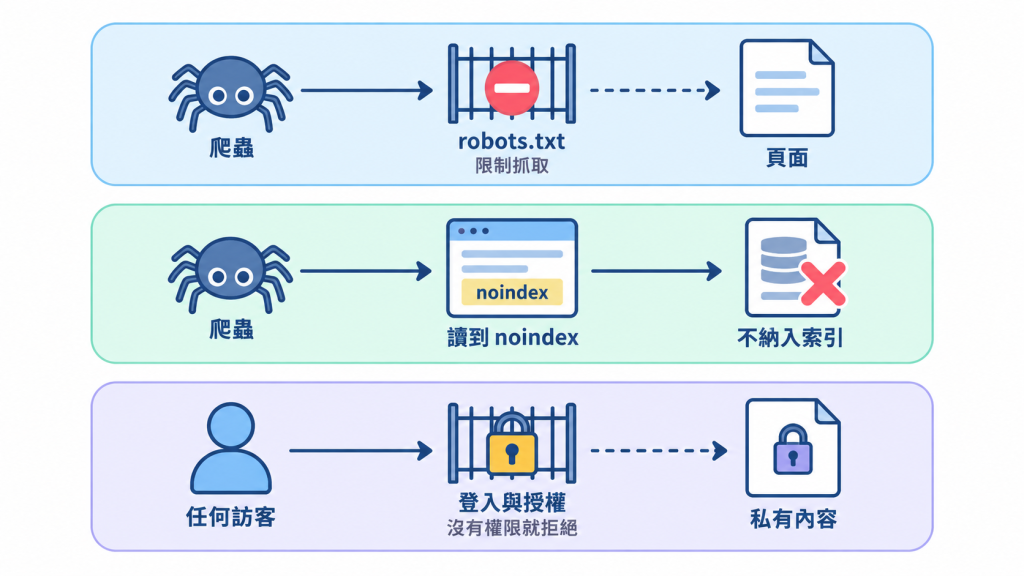
前兩種最容易互相干擾:如果先用 robots.txt 擋住抓取,爬蟲就讀不到頁面上的 noindex,這個網址反而還是可能出現在搜尋結果裡。至於後台管理頁或測試環境,一定要用登入保護,這兩種搜尋設定都沒辦法替它們保密。
網站上線之後,來的不只有搜尋引擎。有些爬蟲會大量抓取整個網站,拖慢速度,甚至把整理好的品牌資料直接搬走。而 robots.txt 只對守規矩的爬蟲有效,惡意的爬蟲不但不理它,還常常在 User-Agent(請求裡表明身分的欄位)冒充 Googlebot,因此可以使用 Cloudfare 來驗證來源並進行第一層的保護。具體來說有以下兩種常見的保護方式:
隨著近期 AI 服務的興起也有越來越多的爬蟲,而同一家公司的爬蟲可能有不同的用途因此需要特別留意。以 OpenAI 為例:
robots.txt 的規則不一定適用。依照 OpenAI 的爬蟲說明,可以在 robots.txt 裡分別設定,例如擋下訓練用的 GPTBot、允許 OAI-SearchBot。
設定做完,還要確認它們真的生效。依照想回答的問題,選對應的工具:
robots.txt 和替代文字。效能分數是固定環境跑出來的實驗室資料,真實使用者的體驗要看 Search Console 裡的 Core Web Vitals(載入速度、互動反應、版面穩定度);分數高也不代表排名一定好。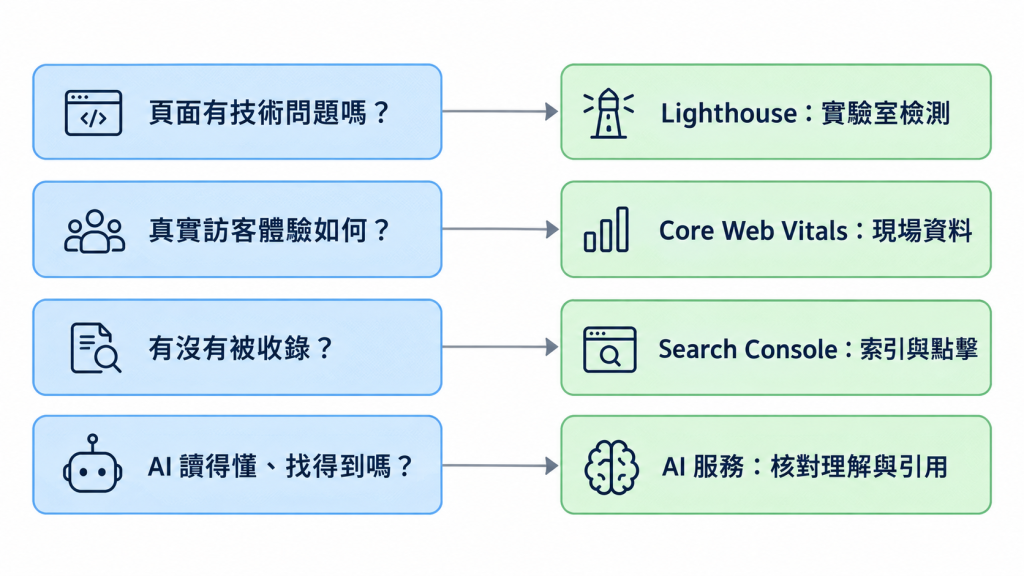
訪客透過搜尋或 AI 的推薦找到網站之後,很多人接著會用站內搜尋找品牌,而不同的人也常常打出同一句話。每一次搜尋,系統都要請 AI 模型把這句話轉成向量、分析搜尋的意圖,花的是時間,也是錢。下一篇我們回到網站裡面,談談怎麼用快取,讓同一句搜尋不用每次都從頭再算。


 iThome鐵人賽
 看影片追技術