iT邦幫忙

2026 iThome 鐵人賽

DAY 25
0
佛心分享-SideProject30

30 天實戰筆記:一個資料科學家用 Side Project 學會 AI Agents 的過程系列 第 25 篇

Day 25|選模型入門:能力、速度和價錢怎麼取捨,帳單又該怎麼控制?

  • 分享至 

  • xImage
  •  

上一篇用快取讓同一句搜尋不用每次重算。不過快取總有沒命中的時候:第一次有人搜尋「送男生的植鞣皮夾」,系統還是得呼叫模型,而每一次呼叫都要等待,也都要付錢。

前面整理商品資料的那幾篇,已經談過哪些步驟用規則就夠、哪些需要模型,也談過怎麼評估模型的答案好不好。確定某個步驟要交給大型語言模型(LLM)之後,還有三件事要決定,很多人要到第一次把 AI 功能放上線,才會遇到:

  • 模型要放在哪裡跑:直接呼叫服務商的 API,還是自己架?
  • 要用多強的模型:模型要選多大,要不要讓它先想再回答?
  • 要花多少錢:怎麼控制花費,才不會月底收到嚇人的帳單,之後換模型時又該比較什麼?

模型要自己架,還是用現成的?

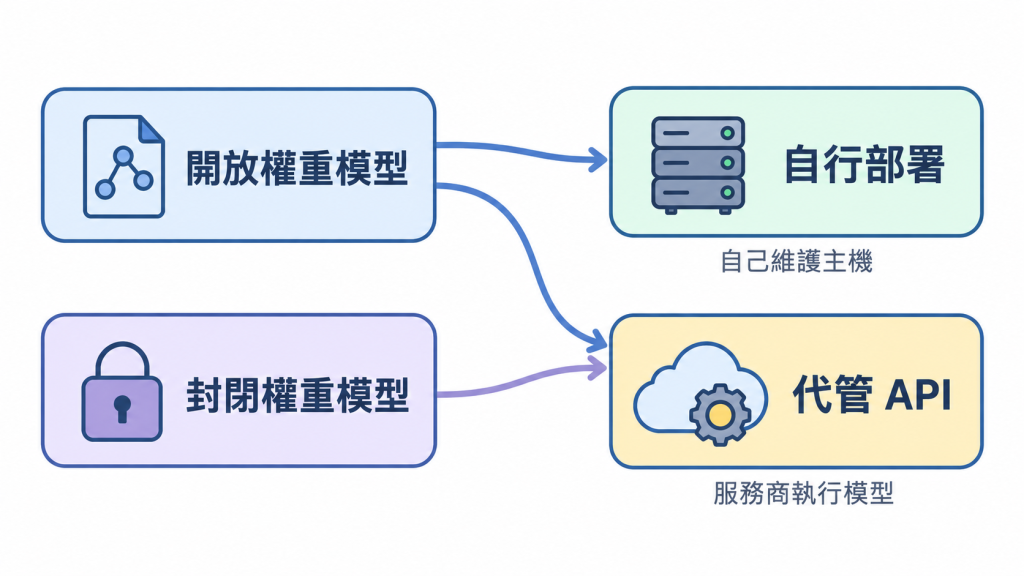
很多人聽過「開源模型免費」,就以為自己架模型比較省錢。但這句話把兩件事混在一起了:一是你拿不拿得到模型本身,二是誰負責把模型跑起來。

Qwen、Llama 這類大家常說的開源模型,比較精確的叫法是開放權重(open weights)模型。權重就是模型訓練好之後的參數,公開了,你就能自己架,也能用別人幫你架好的服務;GPT、Claude 這類封閉模型拿不到權重,只能透過 API 呼叫。開放權重模型能拿來做什麼,要看發布頁上的授權,例如 Qwen3-8B 是 Apache 2.0,Llama 3.3 則是 Meta 自己訂的社群授權。
https://ithelp.ithome.com.tw/upload/images/20261009/20184246px0gPWQs8D.png

自己架的好處是版本和資料都在自己手上,但主機要錢,就算沒人在用也一樣要付,硬體、擴充和維護也都得自己顧。所以流量還說不準的小產品,通常會先用現成的 API:註冊、拿到金鑰就能開始,代價是用多少付多少,每分鐘能呼叫幾次也有限制,也就是呼叫頻率限制(rate limit),資料也要交給對方處理。常見的選擇有這幾種:

  • 模型公司直接提供的 API:例如 OpenAI、Anthropic、Google。
  • 幫你跑開放權重模型的服務:例如 Together AI、Fireworks AI。
  • 一個帳號就能用多家模型的平台:例如 OpenRouter,想試不同模型或換模型都很方便。
  • 自己架:在自己電腦上試跑可以用 Ollama,正式上線則常用 vLLM。

挑的時候,先想清楚你的資料能不能交給外面的服務,還有萬一出問題,能不能很快換到另一家。

模型要挑多強?能力、速度和價錢之間怎麼選?

服務選好了,接下來要決定用多強的模型。能力、速度和價錢通常沒辦法全都要,越強的模型通常越貴,也可能比較慢。模型的強弱可以先從參數量(像 8B 就是大約 80 億個參數)或各家的等級(像 Claude 的 Haiku、Sonnet、Opus)大致判斷。同一個模型還可以讓它先想再回答,這個設定通常叫做推理強度(reasoning effort):想得越多,通常答得越好,但思考產生的 token(模型切分文字的單位,也是計費單位)一樣要算錢,使用者也得多等一下。

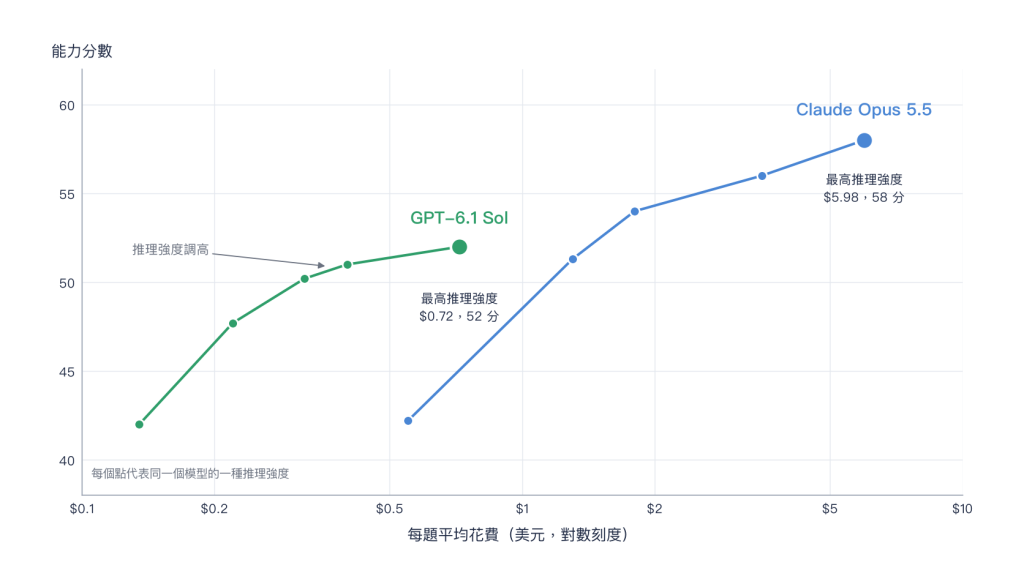
Artificial Analysis 用同一套測驗替各家模型打分數。下圖依它 2026 年 10 月初的資料,比較 Claude Opus 5.5 和 GPT-6.1 Sol,每個點是一種推理強度,越往右上,分數越高、每題測驗的平均花費也越多:
https://ithelp.ithome.com.tw/upload/images/20261009/20184246ZW1fkTajPV.png

兩個都開到最高時,Opus 5.5 多 6 分,花費卻是八倍多;但 Opus 5.5 只要調到 High,每題大約 2 美元就有 54 分。多出來的那幾分值不值得,要看你的工作需不需要,最後還是要拿自己的工作試過才知道。一般可以這樣挑:

  • 量大、格式固定的工作:像是從短文字裡抓出幾個欄位,先試又快又便宜的模型。
  • 要整理長篇資料、條件又不明確的工作:再看看能力強一點的模型,是不是真的答得比較好。

怎麼控制 AI 的花費,才不會月底收到嚇人的帳單?

各家的計價方式不太一樣,自己算很容易算錯,最準的還是服務商後台的帳單。與其自己算,不如先做好三件事:

  • 設好花費提醒:例如花到每月預算的一半時先通知你。提醒只會通知,不會擋下任何呼叫。
  • 定期看帳單:剛上線時每天看,穩定後每週看,突然變多就回頭查是哪個功能造成的。所以上線前我會先確定每次呼叫都有記下是哪個功能、哪個模型、用了多少 token,存在自己的資料表就夠用,也可以用 Langfuse、LangSmith 這類工具追蹤。
  • 設好硬性上限:花到上限之後,服務商會直接拒絕新的呼叫,例如 OpenAI 的專案花費上限(說明)、Anthropic Console 帳務頁的每月上限(說明)。有些服務商就算你沒設,也有預設的每月上限,例如 Anthropic 用完就會暫停到下個月 1 號,用量變大前要先申請調高。

上限擋下來時,AI 功能會直接失敗,而且這種錯誤看起來很像呼叫頻率限制。程式要能認出它、不要重試,直接改顯示不需要 AI 的版本,並通知自己。

帳單突然暴增,很多時候是程式出了錯,常見的有這三種:

  • 無限重試:失敗就馬上重試、沒有次數上限。要限制重試次數,等待時間也要逐次拉長。
  • 呼叫太頻繁:例如使用者每打一個字就呼叫一次模型,改成按下送出才呼叫。
  • 輸入越來越長:例如每次都把完整的對話紀錄送進去,只保留最近幾輪,或先整理成摘要。

最後,每次呼叫也要設上限:最多產生多少 token、最多等幾秒。要注意的是,模型先思考時,思考的 token 也算在輸出上限裡,上限設太小,答案可能被截斷,費用卻照算。

換模型之前,除了準確度還要比什麼?

模型選好之後,也不代表就不會再換。新模型推出、價格調整,或某個功能的品質一直不夠好,都會讓你想換模型。前面談評估的那一篇,已經看過怎麼準備測試資料、用哪些指標判斷答案好不好;比較兩個模型時,這套做法一樣適用:同一批測試資料、同一份正確答案、同一版提示詞(prompt),測試資料也要包含容易混淆、需求不明確的句子。除了準確度,還要一起比較這幾項:

  • 成本:同一批測試資料跑下來總共花了多少,失敗和重試的費用也要算進去。
  • 等待時間:常用 p95 來看,也就是 95% 的請求能在這個時間內完成,比平均值更能看出使用者偶爾碰到的那幾次慢。
  • 失敗率:有些呼叫會因為超過呼叫頻率限制或逾時而失敗,每失敗一次,就要多付一次重試的錢,使用者也得多等一下。

測試資料不多的時候,差一兩筆,正確率就會差好幾個百分點,所以結果只能看出大致的方向。新模型的準確度如果不輸原本的,又明顯更快、更便宜,就值得換;如果只好一點點,卻貴了好幾倍,就未必划算。比較結果也只適用於這件工作:搜尋的意圖解析換了模型,不代表撰寫品牌介紹也要跟著換。

為了讓換模型又快又安全,有幾個習慣最好一開始就養成:

  • 模型設定集中在一個地方:把每個功能用的模型名稱、推理強度和輸出上限,集中寫在同一個設定檔。請 AI 工具寫程式時,它很容易在不同檔案各寫一次模型名稱,等到要換就得一個一個找出來改;集中之後,換模型只要改一行。
  • 指定帶日期的版本:有些模型名稱沒有標日期,服務商會自動換成最新的版本。方便歸方便,模型卻可能在你不知道的時候被換掉,前面的比較結果也跟著失效。正式上線時,指定帶日期或版本號的模型名稱。
  • 清掉快取裡的舊結果:上一篇提到的快取鍵要換上新的版本號,不然舊模型存下來的結果,會繼續被拿出來用。
  • 留下退路:記下換之前的模型版本和設定,新模型表現變差時才能退回去。舊版本也會在某個時間點停止服務,看到停用公告,就要開始準備下一次比較。

上一篇
Day 24|快取入門:同一句搜尋,別讓模型算兩次
系列文
30 天實戰筆記:一個資料科學家用 Side Project 學會 AI Agents 的過程 共 25 篇
圖片
  熱門推薦
圖片
{{ item.channelVendor }} | {{ item.webinarstarted }} |
{{ formatDate(item.duration) }}
直播中

尚未有邦友留言

立即登入留言