
Day23 只把 10% 的流量放進 Canary,今天要把剩下的 90%,也依比例放量到 Canary,用上 Day24 昨天推導出的放量門檻。
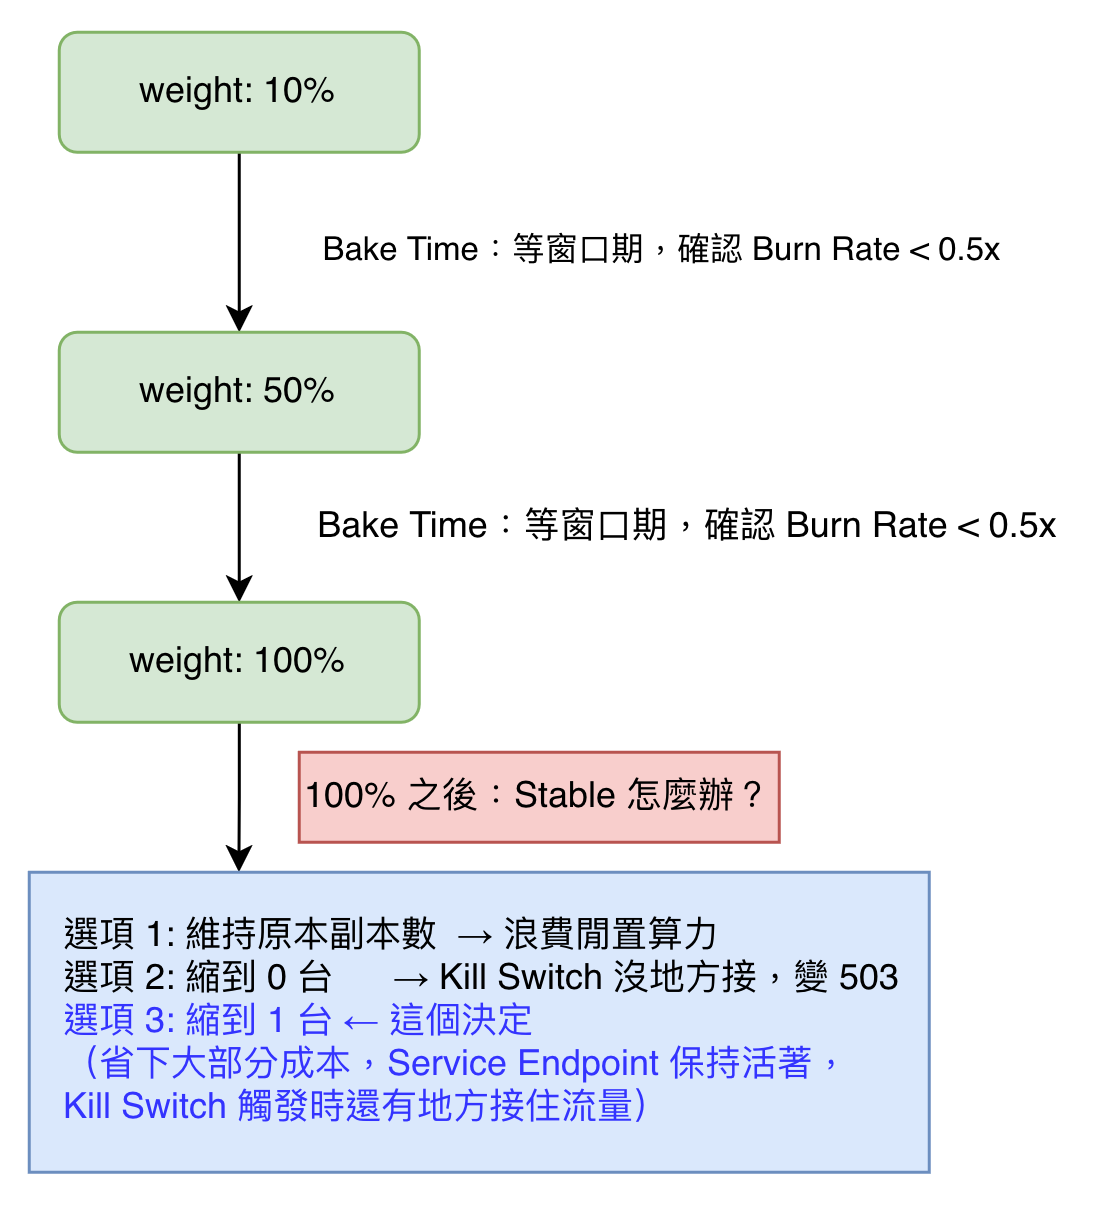
我們在 Day23 設定了一個數字 "10",用來與訪客的 x-user-id 取餘數 做比對,今天我們要分階段調整這個數字,把流量都導入 Canary。這個值依序推進:10 → 50 → 100,把流量從 10% → 50% → 100%。分站推進,就是把「爆炸半徑」拆成三個可以個別觀察、個別喊停的階段。
每個流量等級會暴露出不同的問題:
每個階段推進後,至少要維持一段時間,才能判斷是否健康、可以繼續往下推。這個維持的時間叫 "Bake Time"。就像 "燉煮" 的概念,靠時間讓食材慢慢熟透。放量之後的觀察期也是這樣,像 Memory Leak 這種問題,不會一推上去就馬上出現,得讓系統在真實負載下撐過一段時間,才會慢慢浮現。正式產線上會用更長的觀察時間,搭配多種偵測指標一起判斷。
Day24 已經推導過 Burn Rate 怎麼算、SLO 對應的 Error Budget 是多少。這裡直接拿來用:過去 1 小時窗口的 5XX error code 算出來的 Burn Rate,要低於 0.5x 才算滿足推進的條件——比 SLO 允許的速度慢一半,留安全邊際:
# Burn Rate(1h 窗口):應 < 0.5x
(sum(rate(http_server_request_duration_seconds_count{
    service_name="demo-app", service_version="v2-canary",
    http_response_status_code=~"5.."}[1h]) or vector(0))
 # or vector(0):完全沒有 5xx 時,Prometheus 對空序列的 rate() 會回傳
 # 空結果而不是 0,不加這段,門檻比較會直接因為查無資料而失敗
 / sum(rate(http_server_request_duration_seconds_count{
    service_name="demo-app", service_version="v2-canary"}[1h])))
 / 0.001
產線環境需要滿足的條件會更多,結合多個指標和多層次的判斷。
Canary 推到 100% 之後,直覺會想直接把 Stable 關掉,流量都不在它身上了,留著只是浪費錢。但這樣我們就沒有緊急回滾的地方了。像 Memory Leak、Connection Leak 這種遲發性問題,往往要在高負載下持續運行一段時間才會現形,100% 剛推進完的那一刻,還來不及暴露任何東西。所以我們要把 Stable 留下一段時間,當作備援。
所以 100% 之後不是立刻收斂,是進入一段 延長觀察期,同時做一個成本上的權衡:Stable 不用維持原本的副本數(那是純浪費),但也不能縮到 0(那樣 Kill Switch 觸發時沒有地方接得住流量,直接變成 503)。折衷是縮到 1 台:省下大部分閒置運算成本,同時讓 Kubernetes Service 的 Endpoint 保持活著。真的爆出問題,殺手開關一按,流量立刻有地方接住,用「降速」換「不中斷」。
今天推進 10%→50%→100%,走的是人工 SOP:手動改 canary.json、手動查健康指標、手動決定要不要往下推。業界常用 Argo Rollouts 做這種依比例放量的自動化,但這個專案的分流判斷權在 OPA 的 Rego Policy 裡,如果再疊一個 Rollout Controller 進來管理權重,會變成兩套系統同時想決定「這次請求該去哪裡」,所以今天不用。手動走一遍的目的,是讓大家先看清楚、內化這整套判斷邏輯 改值 → 查指標 → 判斷健康 → 決定推進或止步——Day27 會把這一整套邏輯,用一支 Python 服務自動化。
分流的百分比由 canary.json 的 weight 設定,現在是 10(Day23 留下的狀態),demo-app-v1.yaml 的 replicas 現在是 2,等一下看到它被改成 1,用來表示今天因為 Canary 到 100% 發生的決策。
在開始推進之前,先確認 Prometheus 本身有在運作、真的查得到數字——不然等一下查閾值,看到的可能不是真的「滿足閾值」,而是「查詢對象根本不存在,回傳空結果」,這兩種情況容易搞混:
kubectl port-forward -n observability svc/kube-prometheus-stack-prometheus 9090:9090

curl -s --data-urlencode 'query=sum(rate(http_server_request_duration_seconds_count{service_name="demo-app",service_version="v2-canary"}[1h]))' \
  http://localhost:9090/api/v1/query | jq .
確認 result 陣列不是空的、真的回傳一個數字,代表 Prometheus 有在收 Canary 的流量資料,接下來查的 Burn Rate 才有意義——不會把「查無資料」誤判成「滿足閾值」。
改 manifests/infra/opa/dayNN/opa-deployment.yaml 裡 ConfigMap 的 canary.json:
{"canary": {"enabled": true, "weight": 50}}
為了展示功能,這裡我們就不要真的等一個小時了。推上我們的修改:
git add manifests/infra/opa/dayNN/opa-deployment.yaml
git commit -m "chore(routing): increase canary weight to 50% (Burn Rate=0x, verified)"
git push origin main
步驟跟 Stage 1 完全一樣——改 weight 為 100、查閾值、等 1 小時(手動展示就不要真的等了)、commit。
把 manifests/apps/demo-app/demo-app-v1.yaml 的 replicas 從 2 改成 1:
spec:
  replicas: 1  # 縮編為 1 台,保持 Service Endpoint 存活


 iThome鐵人賽
 看影片追技術