
下面這張圖,是整個故事的全貌:
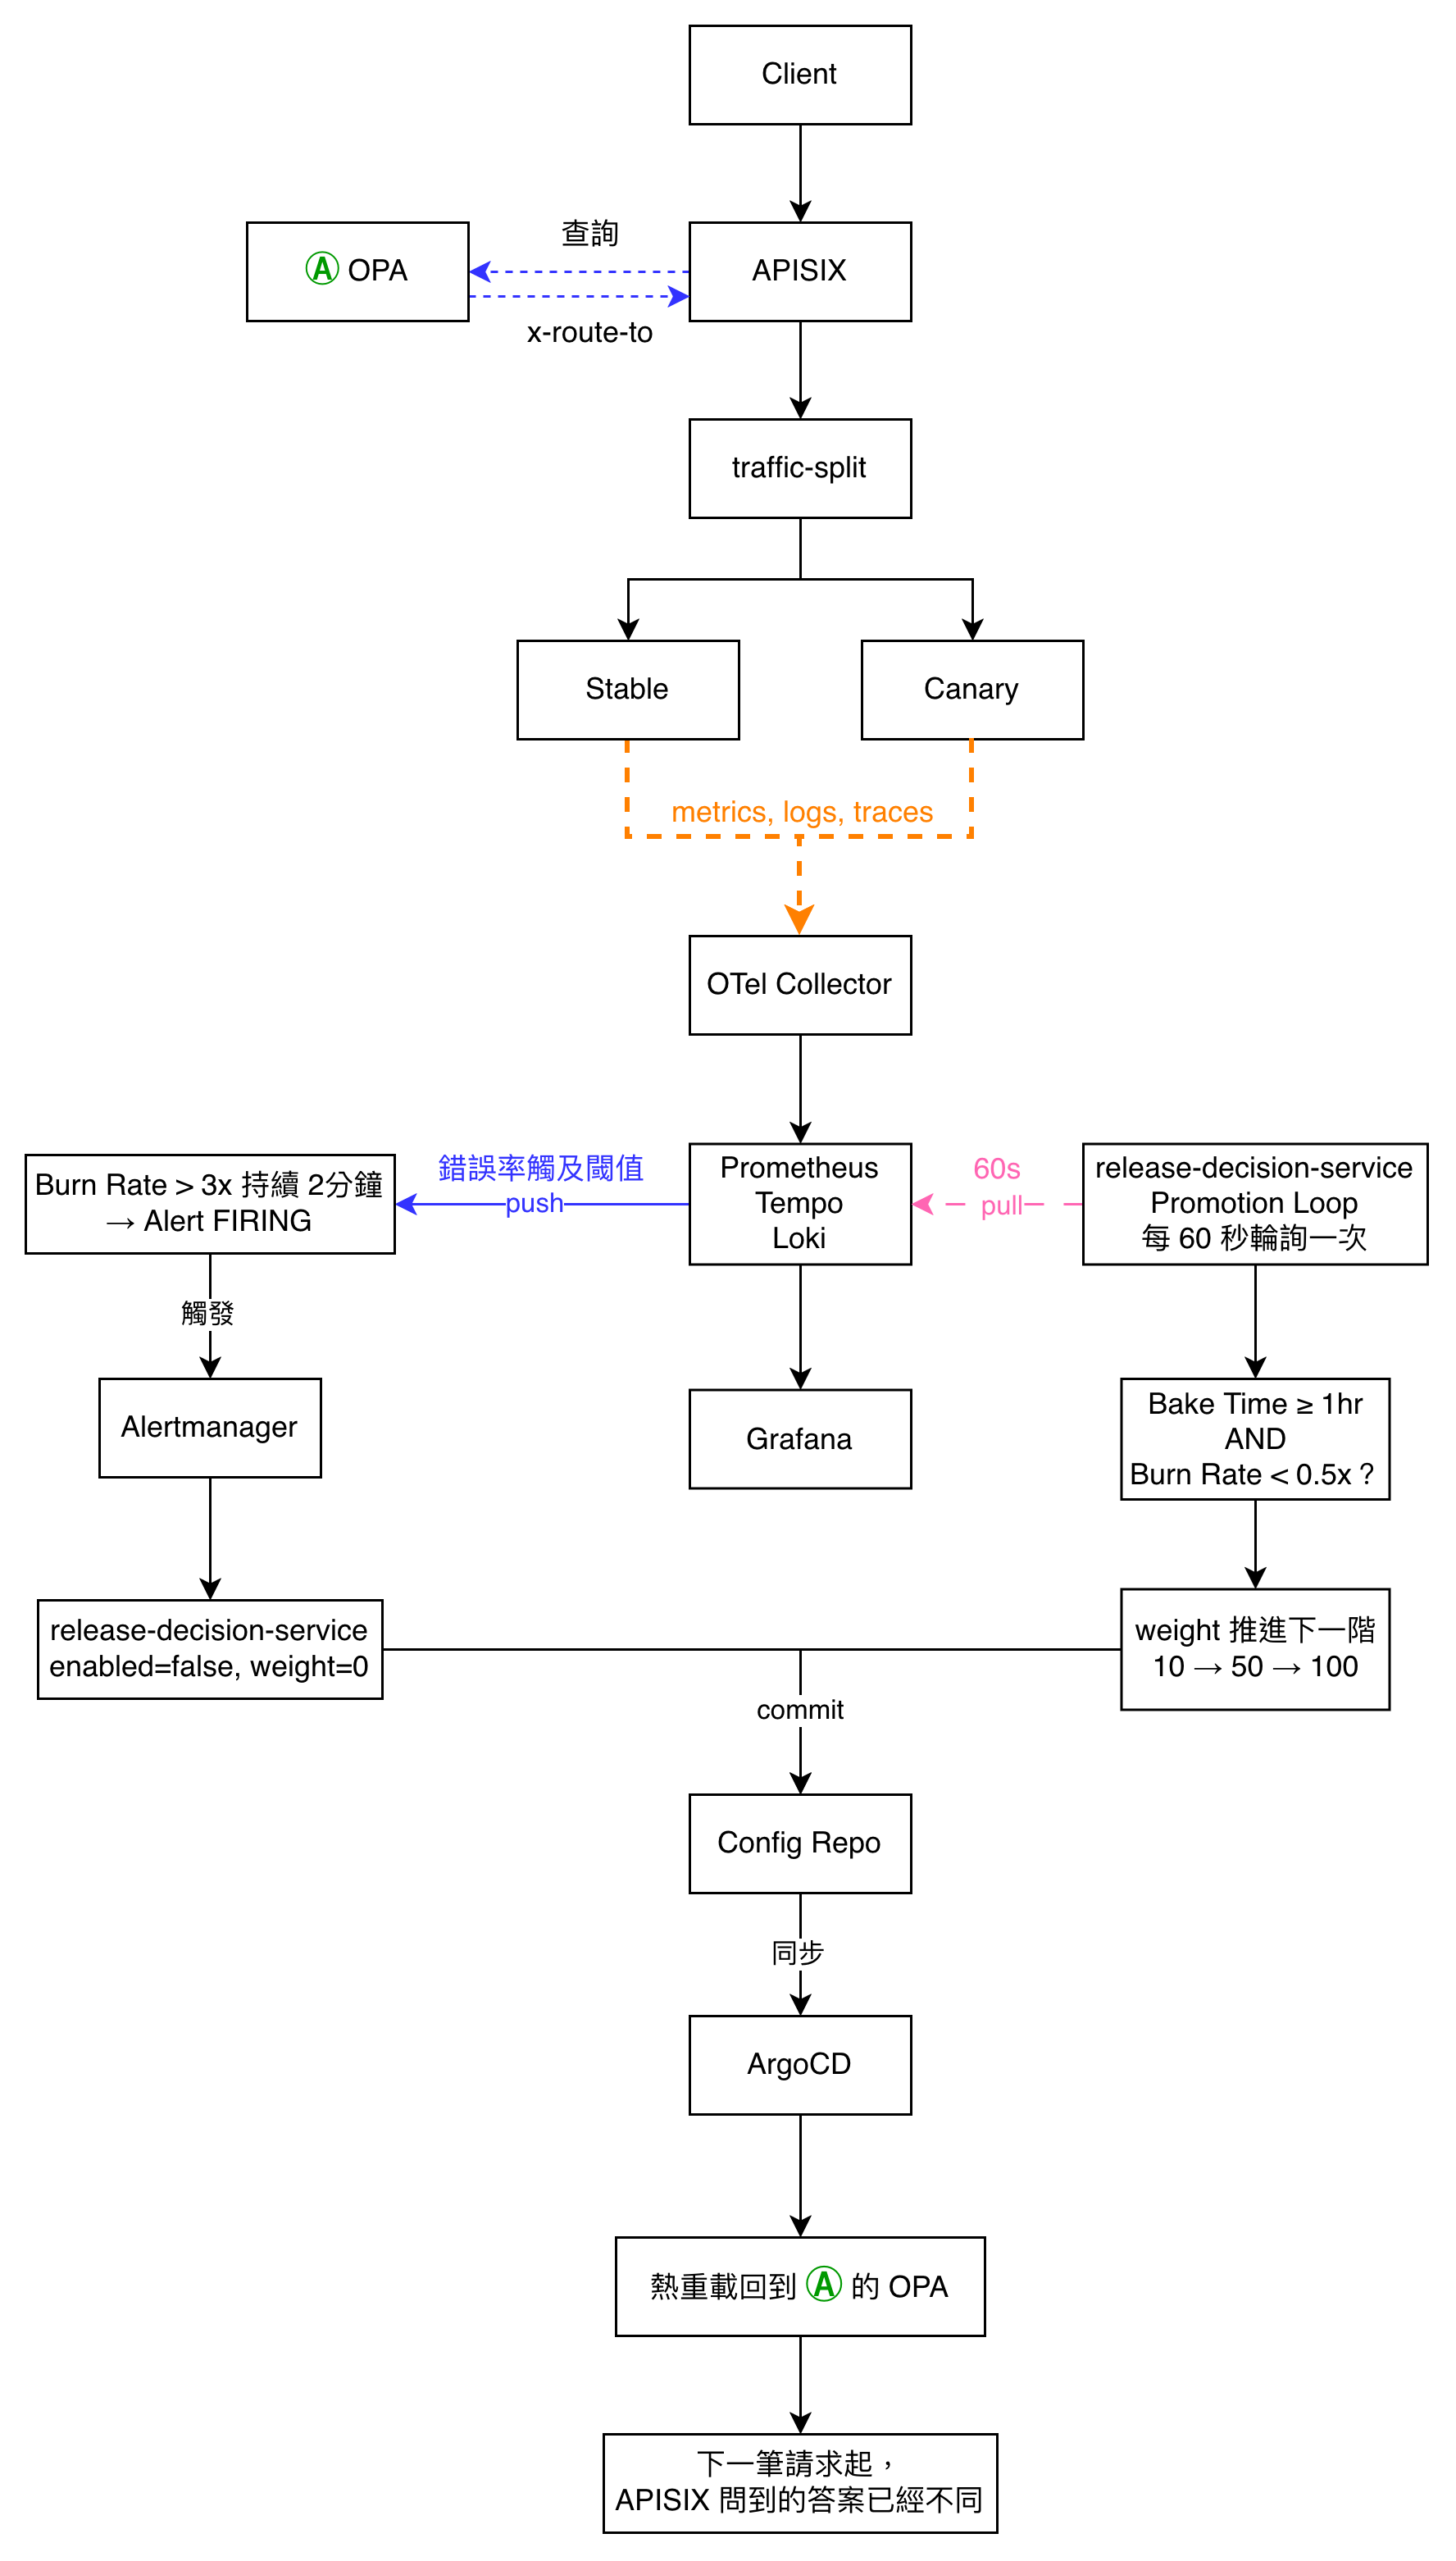
Client 打進 APISIX,APISIX 透過 opa plugin 查詢 OPA——這一步圖上標了一個 Ⓐ,後面會用到。OPA 判斷這筆請求該不該進 Canary,靠的是兩層機制 OR 合併的結果:x-canary Header/canary=true Cookie 的精確比對(Day08-11),或是 x-user-id 雜湊取餘數跟 weight 比大小(Day23)。判斷完回傳 x-route-to,APISIX 的 traffic-split 照這個值把請求送進 Stable 或 Canary 的 upstream。
不管請求落在 Stable 還是 Canary,這兩個版本的 OTel Java Agent 跟 APISIX 自己的三個插件(Day17-19),都會吐出 Metrics/Logs/Traces,送進 OTel Collector,再分流進 Prometheus、Tempo、Loki。這一層不是故障發生才啟動的,是從 Day15 開始,每一筆請求背後都默默在跑的。Grafana(Day20)把三者收斂成一個查詢介面,Day21、22、28 的三張 Dashboard 都建在這個基礎上。
今天的情境假設:這次放量後,Canary 自己的程式碼出問題,它收到的請求裡有 20% 開始回應錯誤——這個錯誤率會被 Prometheus 量到。
這一塊是整個系列最後拼起來的部分,是兩條方向相反、但共用同一組「改寫 canary.json → commit → ArgoCD 同步 → OPA 熱重載」機制的迴路:
release-decision-service 的 webhook,把 canary.json 改成 enabled=false, weight=0。release-decision-service 自己的 Promotion Loop,每 60 秒**自己醒來、主動去查詢(pull)**Prometheus,確認 Bake Time 夠久、Burn Rate 夠低,就把 weight 推進下一階(10→50→100)。這兩條路徑推送跟拉取的方向完全相反——左邊是 Prometheus 主動找上門,右邊是 release-decision-service 自己伸手去問——但殊途同歸,最後都走同一條 commit 回 Config Repo、ArgoCD 同步、OPA 熱重載的路。
OPA 熱重載之後,從下一筆請求開始,APISIX 問到的 Ⓐ 就是新答案了——不管是退版後的「全部回 Stable」,還是放量後的「更高比例進 Canary」。這就是為什麼圖上 OPA 只畫一次:它既是①平常被 APISIX 即時查詢的對象,也是③自動化迴路最後更新的對象,同一個 OPA,兩種身份。


 iThome鐵人賽
 看影片追技術