
Day26 讓 Prometheus 學會主動告警:Burn Rate 超標,Alertmanager 就會發出通知。今天要把「該不該退版、該不該晉升」這個判斷,透過這個通知來實現自動化。
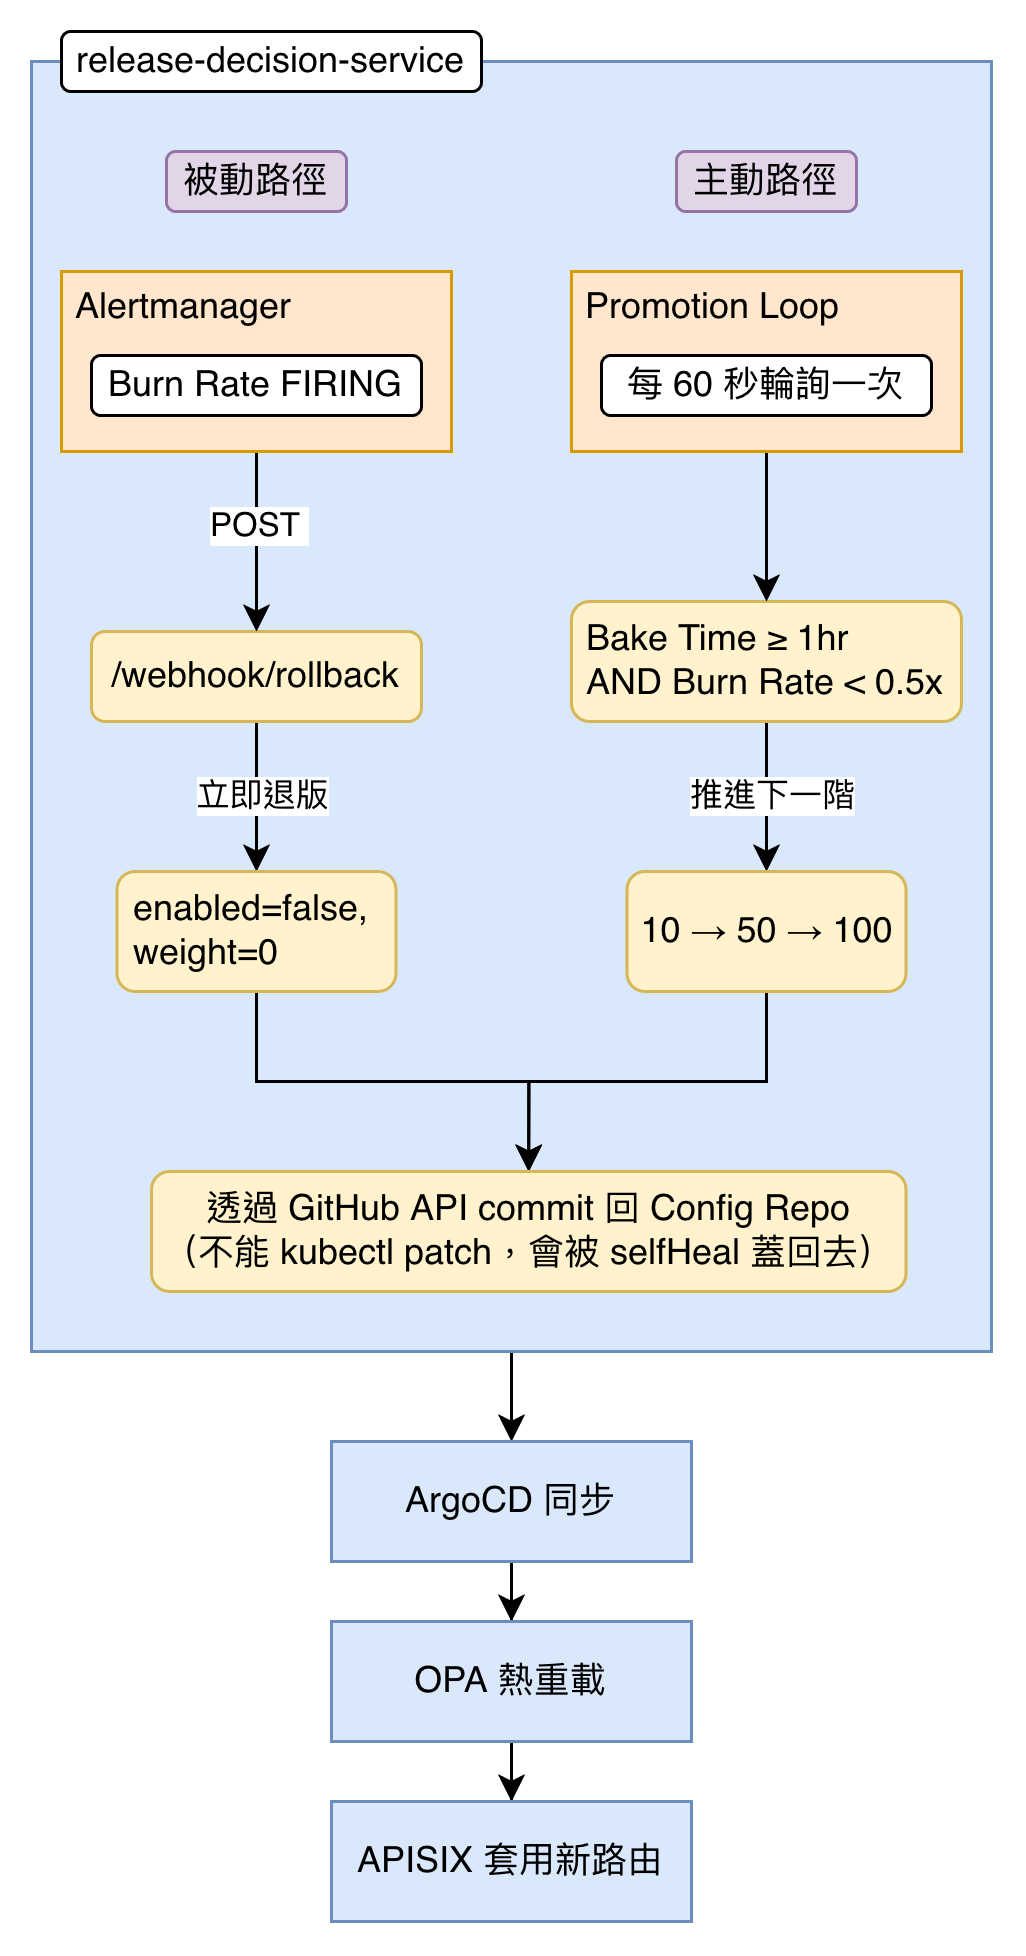
我們用 Python FastAPI 寫了一支服務叫 release-decision-service,是一個常駐在叢集內的 Pod。它同時盯著兩個方向:
/webhook/rollback,服務收到後就執行退版兩個方向最後都透過 GitHub API commit 回 Config Repo,交給 ArgoCD 去同步。
Promotion Loop 每 60 秒偵測一次,依序通過兩道閾值才會晉升:
canary-promotion/stage-started-at 開始,這個觀察期跟 Day25 手動放量 SOP 用的標準一致service_version="v2-canary"
Day24 的 0.5x(晉升)跟 Day26 的 3x(退版)之間,保留了一段安全緩衝帶:
| 狀態 | Burn Rate 值 | 系統行為 |
|---|---|---|
| 危險 | > 3x(> 0.3%) | 自動退版 |
| 觀察中 | 0.5x ~ 3x | 保持現狀,繼續等待 |
| 健康 | < 0.5x(< 0.05%) | 允許晉升 |
兩道閾值都過,才把 weight 推進下一階(10 → 50 → 100),同時把 stage-started-at 清空,讓下一階重新計時。
Promotion Loop 不是一個要另外呼叫 API 或下指令才會運作的功能,它是寫在服務啟動流程裡的一段背景迴圈。Pod 一旦變成 Healthy,這個迴圈就已經在跑,不存在「先部署、之後再決定要不要啟動」這個中間狀態。
這代表:把 release-decision-service 這個 Application 套用到叢集的那一刻,canary 的放量就已經交給自動化在管了。如果只是想先部署起來熟悉架構、暫時不想讓它真的自動改動 canary.json,唯一在部署前能做的決定,就是先不要套用這個 Application。
如果服務已經上線,不想再讓它繼續自動晉升/退版(例如專心測試其他天數的功能、不想被背景自動改動干擾),比「拆掉整個 Application」更乾淨的做法是把 manifests/apps/release-decision-service/release-decision-service.yaml 的 spec.replicas 改成 0,一樣走 git commit + push:
spec:
  replicas: 0
replicas=0 時沒有 Pod,Promotion Loop 跟被動退版的 /webhook/rollback 都不會運作,但 Application、Service、ConfigMap 掛載這些宣告都還在——跟「這個 Application 從一開始就沒被套用過」是不同的狀態,git log 上看得到明確的「什麼時候關的、為什麼關」。需要用到的時候,改回 replicas: 1,一樣用 commit message 記錄。
[真實踩坑] 改完
git push之後,ArgoCD 不一定會馬上反映到叢集——timeout.reconciliation雖然設定 60 秒,但實測遇過推送後超過 10 分鐘才自動同步的情況。如果等了一段時間kubectl get pods還看得到舊的 Pod,不用乾等,手動下一次強制刷新:kubectl annotate application release-decision-service -n argocd argocd.argoproj.io/refresh=hard --overwrite
Alertmanager 判定 Burn Rate Alert 進入 FIRING 後,帶著 severity=critical、action=auto-rollback 兩個 Label,用 HTTP POST 打到服務的 /webhook/rollback。服務收到之後,依序做這幾件事:
canary.json 的 weight 跟 enabled 一起改回 0/false
{"canary": {"enabled": false, "weight": 0}}
為什麼第 2 步要把兩個欄位一起改:
x-canary: true Header/canary=true Cookie)是被 enabled 這個總開關管理weight 只控制 Layer 2(Day23 建立的比例分流,依一般使用者的雜湊值決定要不要導入 Canary)weight,任何看過這篇文章的人依然能繞過比例分流,直接打進故障版本argocd-self-manage 設定 selfHeal: true:叢集的實際狀態永遠以 Git 為準。如果服務直接 kubectl patch OPA ConfigMap,ArgoCD 下一次 Sync 就會把它改回 Git 裡的舊版本——退版等於被撤銷,流量又流回 Canary。正確做法是把修改寫進 opa-deployment.yaml,透過 GitHub API commit 回 Config Repo,讓 ArgoCD 追蹤到新 commit 才觸發 Sync。每一次自動決策,都留下一個可以 git blame、可以 git revert 的紀錄。
Argo Rollouts、Flagger 這類工具本身就內建「自動分析指標 → 決定晉升或中止」的能力,正好是今天要做的事。但套進這個專案,會撞上兩個已經定案的架構規則:
規則一:Argo Rollouts 沒辦法在不寫 plugin 的情況下,接管我們的流量路由。 Argo Rollouts 的漸進式流量分配,是靠它跟一個受支援的 Traffic Router 整合(Istio、AWS ALB、Nginx Ingress、SMI 等),由 Rollout controller 直接去改那個路由資源的權重欄位。我們的路由邏輯是 APISIX + OPA Rego 自己讀 canary.json 算出來的(Day23 的 Layer1 精確比對 OR Layer2 取模百分比),不在 Argo Rollouts 官方支援的清單裡——要接上就得自己寫一個 TrafficRouter plugin,反而比直接寫這支服務更麻煩。
規則二:Argo Rollouts 的自動晉升不會 commit 回 Git,會讓 Git 跟真實狀態脫鉤。 Argo Rollouts 判斷過關後,是 controller 直接推進 Rollout.status.currentStepIndex,整個推進過程只發生在叢集內部的 status 欄位,不會寫回 Git。這正好違反這個專案從一開始就守住的 GitOps 規則——canary 現在的真實分流權重,任何時候都要能在 Git commit history 裡查到,而不是只存在叢集裡。
除此之外,CI 工具(Jenkins、Tekton)也不適用——我們需要的是持續在背景輪詢指標的常駐服務,不是「跑完就結束」的 pipeline。所以自己寫一個輕量的 Python FastAPI 服務,換來的是「陽春一點,但每次晉升/退版都是一個可 review、可回溯的 commit」。
在真實叢集上分別驗證退版跟晉升兩條路徑:
退版驗證
不等 Burn Rate 真的超標,直接用 curl 模擬 Alertmanager 的 webhook payload,打到服務的 /webhook/rollback:
kubectl port-forward -n <namespace> svc/release-decision-service 8080:8080

curl -s -X POST http://localhost:8080/webhook/rollback \
  -H "Content-Type: application/json" \
  -d '{
    "status": "firing",
    "alerts": [{
      "labels": {"alertname": "CanaryBurnRate", "severity": "critical", "action": "auto-rollback"}
    }]
  }'
服務照第 1 節的邏輯執行退版,透過 GitHub App 產生一個新 commit(作者顯示為 <GitHub App 名稱>[bot])
ArgoCD 偵測到新 commit 後同步,OPA 熱重載——確認 Layer 1 跟 Layer 2 的流量都完全斷流(要真的打流量驗證,不能只看 ConfigMap 的值有沒有變)
晉升驗證
chore(promotion): record bake start for stage 10%
auto-promote: canary weight 10% -> 50%
chore(promotion): record bake start for stage 50%
auto-promote: canary weight 50% -> 100%
0.0000 才推進BAKE_TIME_SECONDS = 3600(1 小時)方便在單次教學/測試 session 內跑完整個放量循環;正式產線建議更長(業界常見 24 小時起跳,涵蓋完整日夜流量週期),改這個環境變數即可,程式邏輯不用動。status.currentStepIndex)只存在於叢集的 status 欄位——支撐「規則二」自己寫服務、不用 Argo Rollouts 的論點。


 iThome鐵人賽
 看影片追技術