
Prometheus 從 Stage 3(Day15-22)上線以來,一直在幫我們收集指標,但「Canary 健不健康」這件事,到目前為止都需要我們自己動手查一次 PromQL 才知道。今天要啟動 Prometheus 的告警功能,在指標不健康的時候能主動通知我們。
這個「主動告警」的能力,靠的是 PrometheusRule,這種 Kubernetes 自訂資源(CRD),讓我們用宣告式 YAML 告訴 Prometheus「什麼情況該觸發警報」。圍繞著「告警」這個主題,今天要做三件事:
PrometheusRule
PrometheusRule
PrometheusRule 是 Prometheus Operator 定義的一種 Kubernetes 自訂資源(CRD),結構長這樣:
apiVersion: monitoring.coreos.com/v1
kind: PrometheusRule
metadata:
  name: canary-burn-rate-rules
  namespace: <namespace>
spec:
  groups:
    - name: canary.burn_rate
      rules:
        - alert: <告警名稱>
          expr: <PromQL 表達式,算出來超過門檻就觸發>
          for: <要持續超標多久才算數,濾掉瞬間毛刺>
          labels: <貼在告警上的標籤,Alertmanager 靠這個決定送去哪裡>
          annotations: <告警訊息內容,給人看的>
spec.groups 底下可以放好幾組規則,每組 rules 陣列裡的一條 alert,就是一條獨立的告警定義。
只要 kubectl apply 一份 PrometheusRule,Prometheus Operator 就會自動偵測到並熱載入。本專案一樣會用 ArgoCD 來管理,於是整條鏈路變成:改 YAML → PR 合併 → ArgoCD 同步 → Operator 偵測 → 熱載入生效,全程版本控制、可追蹤、可 Review、可 Rollback。
Day24 已經講過,Burn Rate 是「現在的燒錢速度」相對於「SLO 允許的燒錢速度」的倍數,倍數越高,代表消耗 Error Budget 的速度越快。今天要定下一個 Burn Rate 門檻,一旦超過,就代表情況嚴重到該讓 Prometheus 自動觸發告警、進而觸發自動退版。
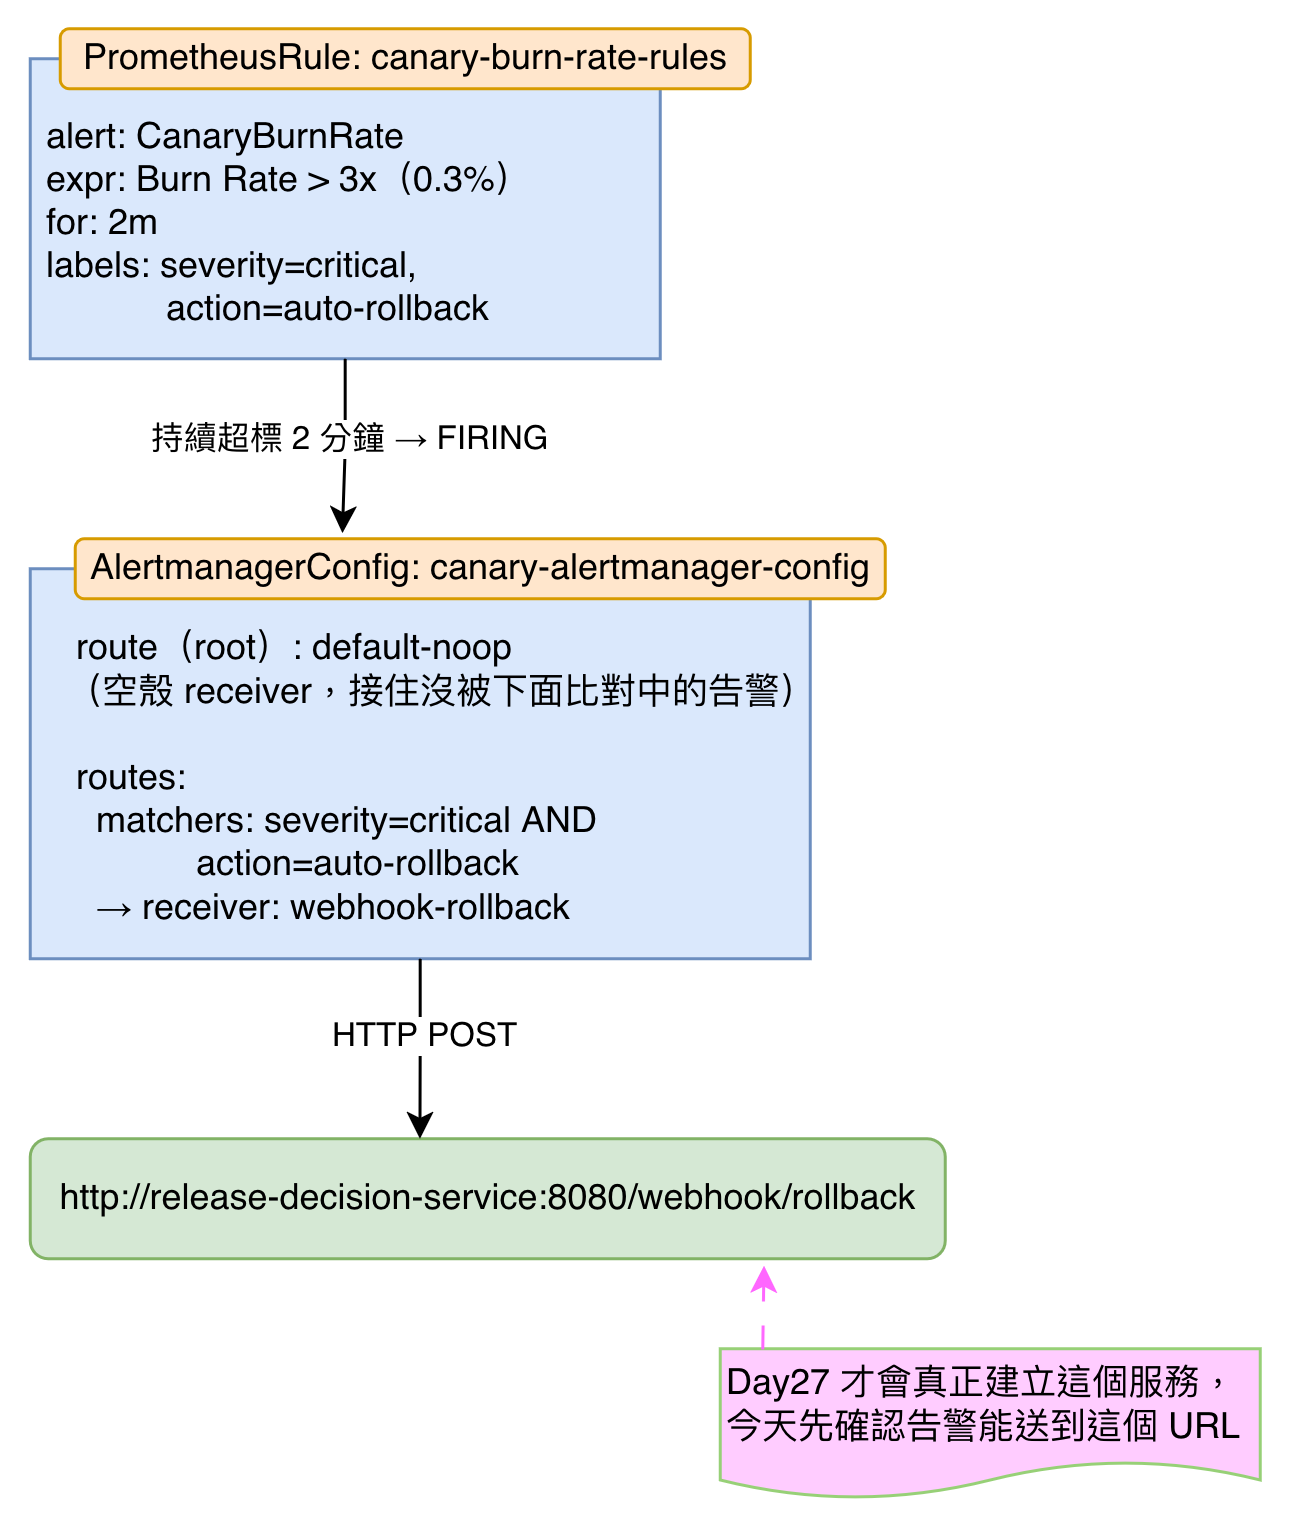
我們用來觸發自動退版的閾值是:Burn Rate > 3x(過去 1 小時的實際錯誤率,超過 SLO 允許速度的 3 倍,換算成實際錯誤率門檻就是 > 0.3%),且這個超標狀態要持續至少 2 分鐘(for: 2m,濾掉單一次網路抖動這種瞬間毛刺)。這個判斷邏輯寫在 canary-rules.yaml 的 PrometheusRule 裡。
這個 3 不是精算出來的最佳值,是這個 POC 判斷「可以接受並且值得自動退版」的一個數字。正式產線要沿用這套機制時,應該照自己服務的實際流量規模、歷史事故資料重新校準,不是每個專案都適用同一個數字。
- alert: CanaryBurnRate
  expr: |
    (
      sum(rate(http_server_request_duration_seconds_count{service_name="demo-app",service_version="v2-canary",http_response_status_code=~"5.."}[1h]))
      /
      sum(rate(http_server_request_duration_seconds_count{service_name="demo-app",service_version="v2-canary"}[1h]))
    ) > (3 * 0.001)
  for: 2m
  labels:
    severity: critical
    action: auto-rollback
每個欄位都能回頭指到 Day24 或今天定下的某個數字:
| YAML 欄位 | 值 | 來源 |
|---|---|---|
[1h] 滑動窗口 |
1 小時 | 需要足夠長的窗口,平滑凌晨低流量的偶發噪音 |
> (3 * 0.001) |
> 0.3% | 上面定下的 3x,乘上 Day24 的 error_budget_rate(0.001) |
for: 2m |
2 分鐘 | 確認持續超標,非瞬間毛刺 |
severity: critical |
critical | Alertmanager 路由比對用的 key |
action: auto-rollback |
auto-rollback | 給 Day27 的 release-decision-service 辨識用 |
跟 Day21/24/25 一樣,這裡查的是應用層的 OTel 指標(service_version="v2-canary")。
告警觸發後,由 Alertmanager 決定要送去哪裡。這個 POC 只用一條規則守住放量/退版,路由也只需要一條:
route:
  receiver: 'default-noop'  # root route 一定要指到一個存在的 receiver,否則會被擋下來
  routes:
    - matchers:
        - name: severity
          value: critical
        - name: action
          value: auto-rollback
      receiver: webhook-rollback

receivers:
  - name: default-noop  # 空殼 receiver,只是為了讓上面這個名字存在,沒有任何動作

  - name: webhook-rollback
    webhookConfigs:
      - url: 'http://release-decision-service.<namespace>.svc.cluster.local:8080/webhook/rollback'
        sendResolved: false
Alertmanager 會把告警內容用 HTTP POST 送到這個 URL,是因為光是「發出警報」還不夠——真正要做的是把 canary_weight 改回 0、commit 回 Git,讓 ArgoCD 同步、APISIX 停止把流量導向 Canary,這一連串動作需要一個服務接住告警、執行退版。這個服務就是 /webhook/rollback 背後的 release-decision-service,但它是 Day27 才會真正建立——今天的任務只到「確認告警正常流轉到這個 URL」為止,接住之後真正執行退版的邏輯,要等明天服務上線才會接通。


 iThome鐵人賽
 看影片追技術