
Day 25:可觀測性第一步,讓協程執行狀況不再是黑盒子 收尾時把話說得很直接:日誌能回答「這一個請求發生了什麼」,卻回答不了「這個系統整體長什麼樣子」。如果想知道平均有多少請求進來、逾時的比例是多少、Day 24 那兩種鎖機制版本衝突的頻率究竟高不高,一筆一筆翻日誌不是一件有效率的事。今天要正面接手這個問題。
日誌適合做的事,是回頭追查某一個特定請求發生了什麼事。Day 25 建立的 RequestId 搭配結構化日誌,讓一次請求橫跨多個協程、甚至跨越多條執行緒時,依然能被正確地串接回同一個請求,這對除錯與異常調查非常有幫助。但如果問題換成「過去一小時,系統平均每秒處理多少請求」「今天下午三點到四點,錯誤率是不是比平常高」,日誌就顯得笨拙,得先把海量的日誌行匯總、計算,才能得出一個數字,而這個數字往往還是延遲產生的,不是系統當下正在發生的狀態。
今天要導入的東西,處理的正是系統整體隨時間變化的量化趨勢,這類量化資料有一個統稱,Metrics,中文常譯為指標或度量,這個系列選擇保留英文原文,因為這是監控工具鏈裡最常直接使用的稱呼。日誌記錄的是一筆一筆的事件細節,Metrics 記錄的是持續累加或即時反映的數字,兩者互補。一個健康的系統,通常需要日誌回答「發生了什麼」,也需要 Metrics 回答「現在狀況如何,跟平常比起來正不正常」。
Day 19:幫協程模型量身打造一場效能比較 當時定案了三個核心的量測指標:回應時間、每秒能處理的請求數量、錯誤率。那次量測靠的是 k6 打出一批模擬流量,在一個事先設計好的測試情境裡觀察系統表現,測試結束,這批數據也跟著定格在那個時間點。這是一次性、有計畫的量測,好比找一天專程去醫院做全身健康檢查,能看出當下的狀態,卻沒辦法告訴你三個月後的某個深夜,身體是不是也一樣正常。
系統上線之後面對的是真實流量,變化模式往往比事先設計好的測試情境複雜得多。促銷活動可能提前湧入一波預熱流量,也可能因為某個外部服務忽然變慢而拖累整條鏈路,這些狀況不會照著 k6 腳本的節奏發生。如果只在上線前做過一次測試,之後系統的健康狀況就成了一片空白,等到真正出問題,往往只能事後從日誌拼湊真相,拼湊出來的也只是這一次事故的片段。
今天要做的事,是把 Day 19 定案的那幾個指標概念,從測試當下才看得到的一次性數字,轉化成系統上線後隨時都能查看的持續性紀錄。回應時間、每秒請求數、錯誤率,這三個名字不會變,量測的邏輯也不需要重新設計,變的只是時機,從一次性的計畫測試,換成隨著真實流量持續累積的長期觀察。健康檢查該做的事還是同一套抽血驗尿量血壓,只是這次要做的是每天量體溫,而不是一年一次的全身健檢。
要把量測做成持續性的,需要一套工具在應用程式運作過程中隨時記錄這些數字,Spring Boot 生態系裡,這件事通常交給 Micrometer 處理。它是一套可以在應用程式內部記錄各種量化指標、並將這些指標以標準格式暴露出去供監控系統收集的函式庫,扮演的角色類似一層轉接介面:應用程式這邊只需要呼叫 Micrometer 提供的 API 記錄數字,底層要把數字送到哪一套監控系統,Prometheus、Datadog 或其他選擇,交給對應的介接元件處理,應用程式的程式碼不需要跟著改動。這裡只建立這一層基本定位,Micrometer 完整的架構設計與所有指標類型,不在今天要展開的範圍。
Micrometer 最常用到的兩種記錄方式,一種是 Counter,計數器,只會單調遞增,適合記錄「這件事發生了幾次」,例如某個例外被觸發了幾次;另一種是 Timer,計時器,同時記錄發生次數與每次花費的時間,適合記錄一段操作的耗時分布。這兩種記錄方式,等一下會分別對應到今天要設計的監控項目上。
如果只是籠統記錄伺服器的 CPU 使用率、API 端點的整體回應時間,這些通用系統指標當然有價值,但貼不上這個系列一路建立的協程專屬風險點。今天要設計的三個監控項目,分別對應系列前面三篇文章建立的三個具體風險,讓監控機制瞄準的是這個系統過去確實暴露過的弱點,而非憑空想像出來的通用範例。
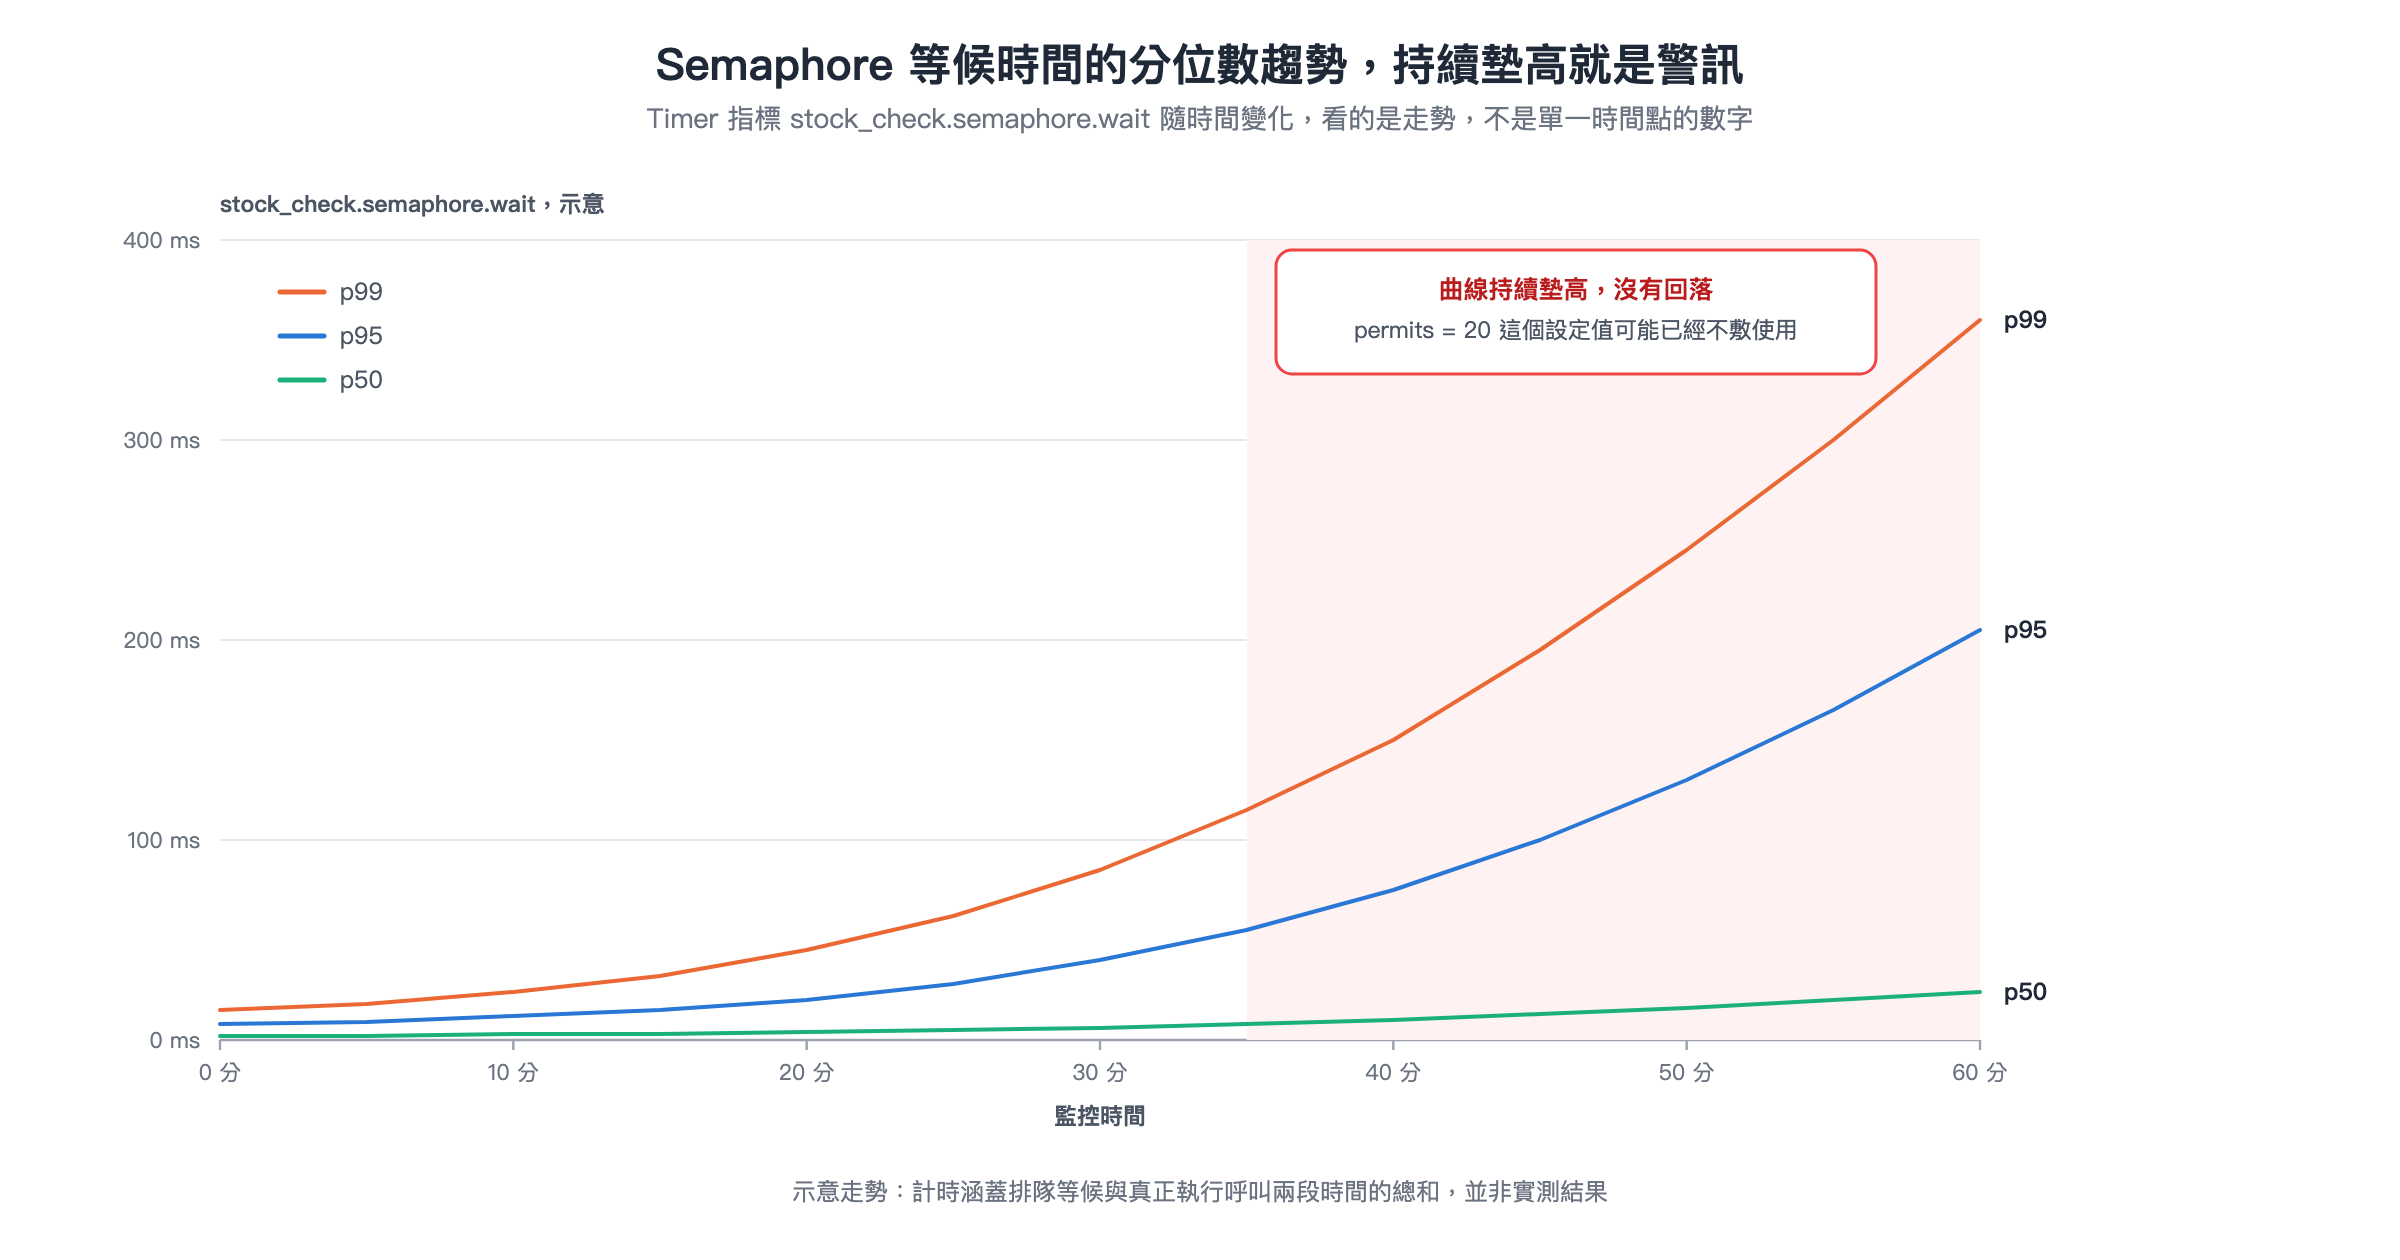
Day 15:併發限制,用 Semaphore 保護下游別被打爆 定案了用 Semaphore 限制同時呼叫下游服務的協程數量,Day 23:把併發控制手段實際裝進訂單服務 把這個 stockCheckSemaphore 實際裝進了 OrderService.getOrderDetail,permits 設為 20。但這個數字設得合不合理,一直沒有任何方式能被驗證,全靠當初的評估假設,如果實際流量遠超過 20 個併發,排隊等候的協程可能大量堆積,這件事現在完全是隱形的。
要讓這件事現形,需要記錄協程從準備取得名額到真正開始執行呼叫為止,實際等了多久,用 Timer 就能同時掌握等候發生的次數與時間分布。把這項記錄疊進既有的 getOrderDetail 裡:
@Service
class OrderService(
    private val orderRepository: OrderRepository,
    private val stockClient: StockClient,
    private val meterRegistry: MeterRegistry,
) {
    private val stockCheckSemaphore = Semaphore(permits = 20)

    suspend fun getOrderDetail(orderId: Long): OrderDetailResponse {
        val order = checkNotNull(orderRepository.findById(orderId))
        val stockStatus = recordSemaphoreWait {
            stockCheckSemaphore.withPermit {
                try {
                    withTimeout(2_000) {
                        stockClient.checkStock(orderId)
                    }
                } catch (e: TimeoutCancellationException) {
                    null
                }
            }
        }
        return OrderDetailResponse(
            orderId = order.id,
            status = order.status,
            stockAvailable = stockStatus?.available ?: false,
        )
    }

    private suspend fun <T> recordSemaphoreWait(block: suspend () -> T): T {
        val sample = Timer.start(meterRegistry)
        return try {
            block()
        } finally {
            sample.stop(meterRegistry.timer("stock_check.semaphore.wait"))
        }
    }
}
這裡刻意把記錄邏輯抽成 recordSemaphoreWait 這個小函式,而不是直接在 getOrderDetail 裡堆疊。Timer.start(meterRegistry) 在進入 withPermit { } 之前先取得一個計時起點,這個計時起點會連同 sample 這個物件,隨著 suspend function 的執行狀態被攜帶著,就算協程在等待名額或等待下游回應期間暫停、恢復後換了一條執行緒,這個計時仍然會在 finally 區塊裡正確結束,因為它跟著協程走,不是跟著執行緒走。這正是 Day 25 建立的心智模型在這裡的延伸應用,識別碼能跟著協程走,計時器同樣能跟著協程走。
要提醒一點,這裡計的時間涵蓋了排隊等候與真正執行呼叫這兩段時間的總和,不是單純的排隊時間。如果想更精細地只量出排隊本身的等候長度,需要把計時起點與 withPermit { } 的呼叫再拆得更細,這裡為了保持範例精簡,先用這個較粗略但足夠反映趨勢的版本。
Day 18:協程遇上 R2DBC 連線池,小心連線被偷偷耗盡 已經把話講得很清楚:等待取得連線的行為是暫停而非阻塞,但連線供需失衡依然會造成排隊,這件事跟執行緒有沒有被卡住無關。當時設定的組態範例裡,max-size 是 50,max-acquire-time 是 3 秒,這兩個數字設得合不合理,同樣一直沒有被驗證過。
這個監控項目跟前一個不太一樣,不需要自己動手插入計時邏輯。連線池本身使用中的連線數量與等待中的協程數量,屬於連線池這個元件內部已經在維護的狀態,R2DBC 的連線池實作透過 Micrometer 的整合,會把這些數字暴露出來。這裡只需要建立這層認識:使用中連線數量越接近 max-size 設定的上限,代表連線池越接近被打滿;等待中的協程數量如果持續不是零,代表供給已經追不上需求。具體要啟用哪一項組態設定才能讓數字被收集到,屬於連線池與監控工具鏈介接的細節,不在今天的範圍。
把這件事放回訂單服務的情境想一次。如果某次促銷活動期間,使用中連線數量長時間貼著 50 這個上限,同時等待中的協程數量也不是零,代表 Day 18 當時設定的連線池大小,在這次真實流量下已經不夠用,團隊可以據此決定調高連線池大小,還是回頭檢查是不是有交易遲遲沒有正常結束、占著連線不放。促銷活動當下就能看到這個趨勢,不必等到活動結束、事後翻日誌才發現連線池早就吃緊了。
Day 24:庫存扣減的併發正確性,用資料庫機制取代分散式鎖 收尾時老實承認:樂觀鎖的版本衝突實際上發生得頻不頻繁,悲觀鎖的等待實際上會讓請求卡多久,這些問題當時完全答不出來。今天要具體回答第一個問題。
回頭看 Day 24 建立的 deductOneWithVersionCheck,這個方法回傳的 Int 代表這次更新實際影響了幾列資料,Service 層依照這個回傳值判斷 affectedRows > 0 是否成立,成立代表扣減成功,不成立代表版本號已經被別人改過,或者庫存本來就是零。要記錄版本衝突發生的次數,正好可以在這個判斷分歧的地方插入一個 Counter:
@Service
class StockService(
    private val stockRepository: StockRepository,
    private val meterRegistry: MeterRegistry,
) {
    private val versionConflictCounter = Counter.builder("stock.deduct.version_conflict")
        .description("樂觀鎖版本衝突發生次數")
        .register(meterRegistry)

    suspend fun deductStockOptimistic(stockId: Long): Boolean {
        val stock = checkNotNull(stockRepository.findById(stockId))
        val affectedRows = stockRepository.deductOneWithVersionCheck(
            stockId = stockId,
            expectedVersion = stock.version,
        )
        val succeeded = affectedRows > 0
        if (!succeeded) {
            versionConflictCounter.increment()
        }
        return succeeded
    }
}
跟 Day 24 的原始版本相比,改動只有兩塊:新增 versionConflictCounter 這個屬性,以及在 affectedRows > 0 判斷為否的分支裡呼叫 increment()。deductStockOptimistic 的方法簽章、deductOneWithVersionCheck 的呼叫方式完全沒有變動,監控埋點加在既有邏輯的判斷分歧點上,不推翻重寫整段邏輯。Counter.builder 這種鏈式寫法是 Micrometer 目前建立自訂指標的標準方式,.register(meterRegistry) 把建立好的 Counter 註冊進 MeterRegistry,之後每次呼叫 increment(),這個數字就會累加一次,並隨著時間持續被監控系統收集。
要留意這裡記錄的是版本衝突這個語意本身,不是單純這次更新失敗。affectedRows > 0 為否,實際上可能是版本號被別人改過,也可能是庫存本身已經是零,兩種原因混在同一個計數器裡,長期下來會讓數字的意義變得模糊,團隊若想更精確地分開,可以在 Service 層多查一次目前的版本號與庫存量來判斷是哪一種,這裡為了聚焦監控埋點的基本寫法,先不展開這層區分。有了這個計數器,Day 24 結尾那個懸而未決的問題,衝突實際發生得多頻繁,終於有了具體的數字可以回答。
至於悲觀鎖那條路徑,等待鎖定的平均時間,原理跟監控項目一的 Semaphore 等候時間如出一轍,同樣用 Timer.start 包住 findByIdForUpdate 到交易結束這段區間,這裡不重複展開完整程式碼,讀者可以直接套用監控項目一示範過的手法。
記錄了這些指標,只是把數字從無到有生產出來,這件事本身不會自動讓任何人注意到異常。如果這些數字只是安靜地存在某個地方,沒有任何方式被視覺化呈現,團隊還是得靠人工去查詢原始數字才能判斷現在的狀態正不正常,這跟一開始想擺脫的一筆一筆翻日誌,本質上沒有差太多,只是換了一種更累人的方式重複同一個問題。
要讓這些數字真正發揮作用,通常還需要搭配一套能把數字畫成圖表、隨時間呈現趨勢的視覺化工具,讓團隊能一眼看出某條曲線是不是忽然墊高,而不必自己動手比對數字。這裡不展開特定視覺化工具的完整設定,只需要建立一個務實的認識:記錄指標只是第一步,這些數字被實際擺在畫面上、被人實際看到,才真正產生價值。
另外一件同樣點到為止的事,是告警。如果這三個監控項目都設定了合理的閾值,例如 Semaphore 等候時間的 p95 超過某個秒數、樂觀鎖版本衝突次數在短時間內異常飆升,理想情況下應該要有機制主動通知團隊,而不是被動等著哪天有人剛好打開監控面板才發現異常已經持續了好一段時間。告警系統的設計,門檻該怎麼抓、通知該用什麼管道,是另一個獨立且份量不小的主題,今天只點出這件事的必要性,不深入展開。
今天把 Day 25 建立的日誌與今天建立的 Metrics 監控放在一起看一次。日誌負責回答這一個請求發生了什麼,Metrics 監控負責回答這個系統整體長什麼樣子,兩者合起來,這個系統終於不再是一團迷霧。Day 19 定案的三個量測指標,回應時間、每秒請求數、錯誤率,從一次性測試的產物,轉化成了隨時可以查看的持續性紀錄,而 Semaphore 排隊、R2DBC 連線池、樂觀鎖版本衝突這三個系列一路建立的協程專屬風險點,也都各自有了對應的監控項目。
但這些機制目前為止還只是安靜地掛在那裡,等著哪天真正被高併發流量考驗一次。Semaphore 的等候時間曲線會不會如預期般在流量攀升時墊高,連線池的使用中連線數量會不會真的在尖峰時段貼著上限,樂觀鎖的版本衝突計數器會不會如實反映衝突頻率,這些今天寫的每一段監控埋點,都還沒有真正被檢驗過。
下一篇會延用 Day 19、Day 20 建立的 k6 方法論,進行一場真正的壓力測試,驗證前面所有控制手段與今天建立的監控機制是不是真的有效。
我們下篇文章見。


 iThome鐵人賽
 看影片追技術