
團隊的內容處理服務原本直連原廠 API,遇到兩個實際問題。
一是付款:原廠要外幣信用卡,公司的卡常常被拒,請款流程也不好處理。二是網路:正式環境得維持特定連線狀態才穩定,這在維運上是額外負擔。
再加上業務要同時比較幾家廠商的模型,等於要開三個帳號、管三把金鑰、對三份帳單。
第三方中轉站把這三件事一次解決:統一入口、台幣或人民幣付款、一把金鑰調所有模型。程式改動只有一行,把 Base URL 換掉就好,走的還是 OpenAI 相容協定,SDK 不用動。
但多了一層轉發,也多了一個問題:你怎麼知道它回傳的真的是你點的那個模型?
這篇是我接入前實際跑過的四項檢查,以及中間踩到的幾個坑。
所謂中轉站,本質是聚合服務商:它接上各家模型的官方 API,你呼叫它的介面,它轉發給官方再把結果回傳。絕大多數都做成 OpenAI 相容格式,所以你只要改 base_url 和 api_key,程式幾乎不用動。
會用它的理由就是前面那幾項:國內外連線、付款方式、一把金鑰管所有模型、批量採購拿得到階梯價。
但風險也要講清楚,有三條:跑路(這個行業門檻極低)、降智(標著旗艦模型,實際路由到便宜模型)、隱私(你的 prompt 會經過第三方伺服器)。
這三條直接決定了要檢查什麼。 降智對應模型回傳值核對,跑路對應上游來源和小額試水,隱私對應資料邊界——下面四項檢查就是照這個來的。
其中「跑路」這條,可以從價格優勢的來源判斷:
說得清楚上游的,走 Azure、AWS Bedrock、Google Vertex AI 這類雲端供應商的管道,或是廠商的企業合約。雲端有自己的計價體系和批量協議,跟原廠掛牌價本來就不是同一回事。
說不清楚上游的,一種是逆向管道,把只能在瀏覽器裡聊天的功能「改裝」成 API;另一種是帳號池和訂閱拆賣,只要控制同時上線的人數就行。第二類的代價是違反上游條款,隨時可能整批失效——服務跑得好好的,某天早上全線回報錯誤,這在正式環境不能接受。
所以我的判斷順序是先問上游,再看其他。說得出每個模型走哪條管道的,比喊得大聲的可信。
另外市面上的東西要分三類別混著比:託管聚合平台(OpenRouter、硅基流動、Crazyrouter 這些,註冊儲值拿金鑰就能用)、自建閘道(One API、LiteLLM,本身不提供模型,要自己填各家原始金鑰,前提是有人維護)、觀測與管控(Cloudflare AI Gateway 這類,應用上線之後才用得到)。要選的是第一類。
| 檢查項 | 對應風險 | 怎麼判斷 |
|---|---|---|
| 模型回傳值 | 降智 | 回應裡的 model 欄位是不是你點的模型 |
| 首字回應 | 可用性 | 串流下第一個 data: 區塊到達的時間 |
| 效能波動 | 可用性 | 同一個請求跑多輪,看最慢那次 |
| 併發限速 | 可用性 | 同時打一批,統計 429 比例 |
第一項成本最低、效益最高,一次請求就能做完。在 OpenAI 相容協定裡,回應的 model 由上游填寫、閘道原樣轉送,它是少數幾個不依賴平台自述、能客觀核對的訊號。
實際做法就一條指令。把請求內容存成 req.json(model、messages、temperature=0、max_tokens=60 四項),然後:
curl https://api.crazyrouter.com/v1/chat/completions \
  -H "Authorization: Bearer $CR_API_KEY" \
  -H "Content-Type: application/json" \
  -d @req.json
重點看回傳的 model 是不是帶日期的完整版本號。請求 gpt-4o-mini 回 gpt-4o-mini-2024-07-18 是正常的(上游把簡稱補齊了),所以判斷要用「開頭相符」而不是完全相等;回了別家的模型就不正常,當場停下來問清楚。
這裡還有個順手的旁證:system_fingerprint、service_tier 這類平常根本用不到的冷門欄位,正經轉發原廠介面的平台會原樣帶回來。逆向管道是把網頁版的聊天結果重新包裝成 API 格式,造不出這些欄位,往往乾脆就沒有。回應「乾淨」得只剩必要欄位,反而要留個心眼。
測波動和併發,同一條指令改兩個地方就好:把 -w 換成 "%{time_total}\n" 連續跑十次看耗時,或換成 "%{http_code} "、結尾加 & 讓它背景併發,看會不會出現 429。測這兩項把 max_tokens 調到 5 左右,又快又省。
2026 年 10 月 14 日,Windows 10.0.19045 加 PowerShell 7 的環境:
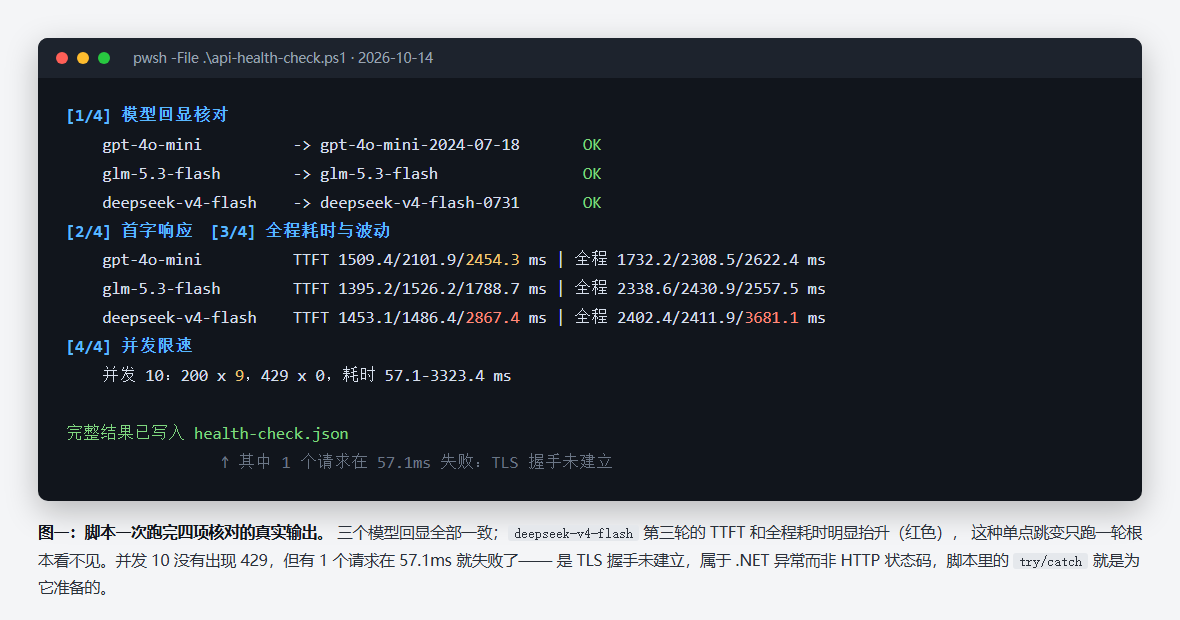
圖為實際終端機輸出的排版呈現,資料未經修改。
三個模型的回傳值全部一致,都帶了上游真實版本號。另外測 claude-haiku-4-5 回的是 claude-haiku-4-5-20251001,gemini-3-flash 回的是 gemini-3-flash-preview,都屬於正常的版本補齊。
首字回應集中在 1.4 到 2.9 秒。 注意 deepseek-v4-flash 第三輪是 2867 毫秒,明顯高於前兩輪的 1453 和 1486——這種單點抬升不跑多輪根本看不出來。
併發 10 沒有出現 429,但有一個請求在 57.1 毫秒就失敗,回報 The SSL connection could not be established。
還有一次單獨測到的極端值:某一輪 gpt-4o-mini 全程耗時 77.6 秒,同一個模型其他輪次都在 2 到 4 秒。如果程式設了 30 秒逾時,這一次就是線上事故。這就是為什麼要看最慢那次,而不是平均值。
第一個坑最花時間:PowerShell 的萬用字元會把 [DONE] 當成字元集。 統計串流區塊時寫了 $line -notlike '*[DONE]*',結果 HTTP 回 200、串流也在推,但統計數恆為 0,一度以為這家不支援串流。原因是 [DONE] 不是字面值,而是比對單一字元 D、O、N 或 E,而每一行 JSON 都含有 o 或 e,於是整個條件恆為假,所有資料行被濾掉。改用 StartsWith 這類字串方法就正常了。
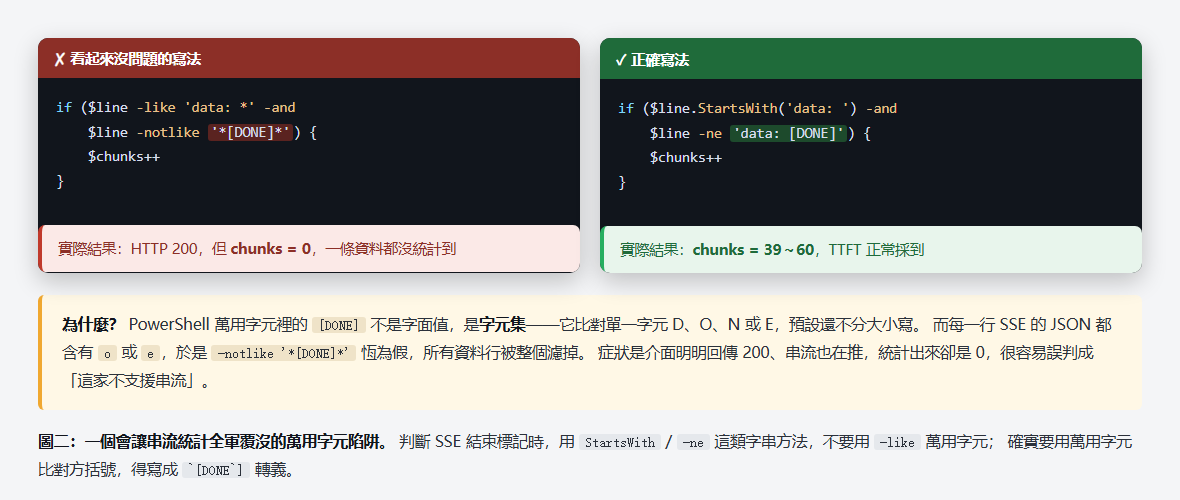
圖為程式碼對照示意,兩側結果取自實際執行。
第二個坑症狀一模一樣:HttpClient 預設不解壓縮,沒設 AutomaticDecompression 的話,伺服器回 gzip 時讀到的是壓縮位元組,一樣比對不到 data: 行。兩個原因疊在一起更難定位。
第三個坑會讓數據偏小:這個介面在正式內容之前會先送一行 : PING 心跳,按 SSE 規範冒號開頭是註解行,計時前要先跳過。
第四個坑是併發時的 TLS 失敗,它丟的是 .NET 例外而不是 HTTP 狀態碼,-SkipHttpErrorCheck 攔不住。併發測試的執行緒一定要包 try/catch,不然整個腳本直接中斷,前面幾項白跑。
速度來自上面的實測,品質是定位說明、不是跑分:
| 情境 | 可以先看的模型 | 實測首字 | 品質定位 | 為什麼是它 |
|---|---|---|---|---|
| 先接通、跑通流程 | gpt-4o-mini |
1.5–2.5 秒 | 輕量夠用 | 回傳值帶完整版本號、冷門欄位齊全,拿它驗最直觀 |
| 批次處理中文、怕逾時 | glm-5.3-flash |
1.4–1.8 秒 | 國產輕量 | 三輪全程耗時波動最小,2338–2557 毫秒 |
| 互動式情境、要首字快 | deepseek-v4-flash |
1.5–2.9 秒 | 國產主力 | 前兩輪穩定在 1.45 秒上下,第三輪有抬升要注意 |
| 正式環境 | 不押單一平台 | — | — | 自建閘道做多上游容錯,中轉站只當其中一條線路 |
要長上下文和強推理的工作,再上 claude-sonnet-5、gpt-5 這類旗艦。這次沒測它們的速度,上線前一樣把四項檢查跑一遍。
這個平台目前 /v1/models 回傳 171 個模型,型號和各自走哪條上游管道可以在模型清單頁上對照;轉發鏈路和接入方式可以看這篇AI API 中轉站原理與接入指南。
最後一句:先小額儲值把四項跑完,再決定投多少。 指令改個 Base URL 就能測別家,歡迎把你的結果留言對照。

 18924485322

 iThome鐵人賽
 看影片追技術