
封面為本次實測的主題示意圖,非產品介面截圖。
這篇想分享的其實不是「哪個模型比較強」,而是我在比較過程中學到的一個習慣:先把用量回執裡的推理token欄位印出來。在那之前,我對自己到底買了什麼其實沒概念。
7月兩家前後腳發版,Kimi K3和DeepSeek V4。我要替日常開發挑一個主力,第一反應當然是找現成的評測看。
結果翻了一圈就放棄了。同一個程式基準,不同網站給DeepSeek的分數差到37分;有的評測表格乾脆填「優秀/極強/良好」,連數字都沒有。追下去發現問題多半出在思考模式沒對齊,或者把不同價位的型號混在一起比。
沒得抄,只好自己跑十道題。
一開始我是各自去兩家申請、各自接,跑完發現這樣得到的耗時沒有意義——不同服務商的延遲、限流和排隊策略都不一樣,我分不清慢的是模型還是線路。
後來改成掛在同一個入口上重跑。在Crazyrouter的程式模型彙總頁裡兩家都能直連,我只換模型名稱,其餘請求參數一個字都不動。這樣耗時的差異才能歸到模型頭上。
這是我這次學到最實際的一件事:比較兩個模型之前,先確認變數只有一個。
十道題涵蓋結構化輸出、指令遵循、推理數學、程式和一道我自己加的抗誤導題,每一道都能自動判定對錯。
| Kimi K3 | DeepSeek V4-Pro | |
|---|---|---|
| 自動判定通過 | 9/9 | 9/9 |
| 中位耗時 | 15.0秒 | 4.8秒 |
| 思考token佔輸出比例 | 79.2% | 88.7% |
對錯上兩邊打成平手,我沒能分出高下。意外的是最後那一列——我原本根本沒打算記這個數字。
有一道題我是這樣問的:
荷葉每天面積翻一倍,第48天長滿池塘。第幾天長滿一半?只輸出數字。
V4-Pro回了「47」,答對。但用量回執裡輸出記了80個token,其中78個是思考。
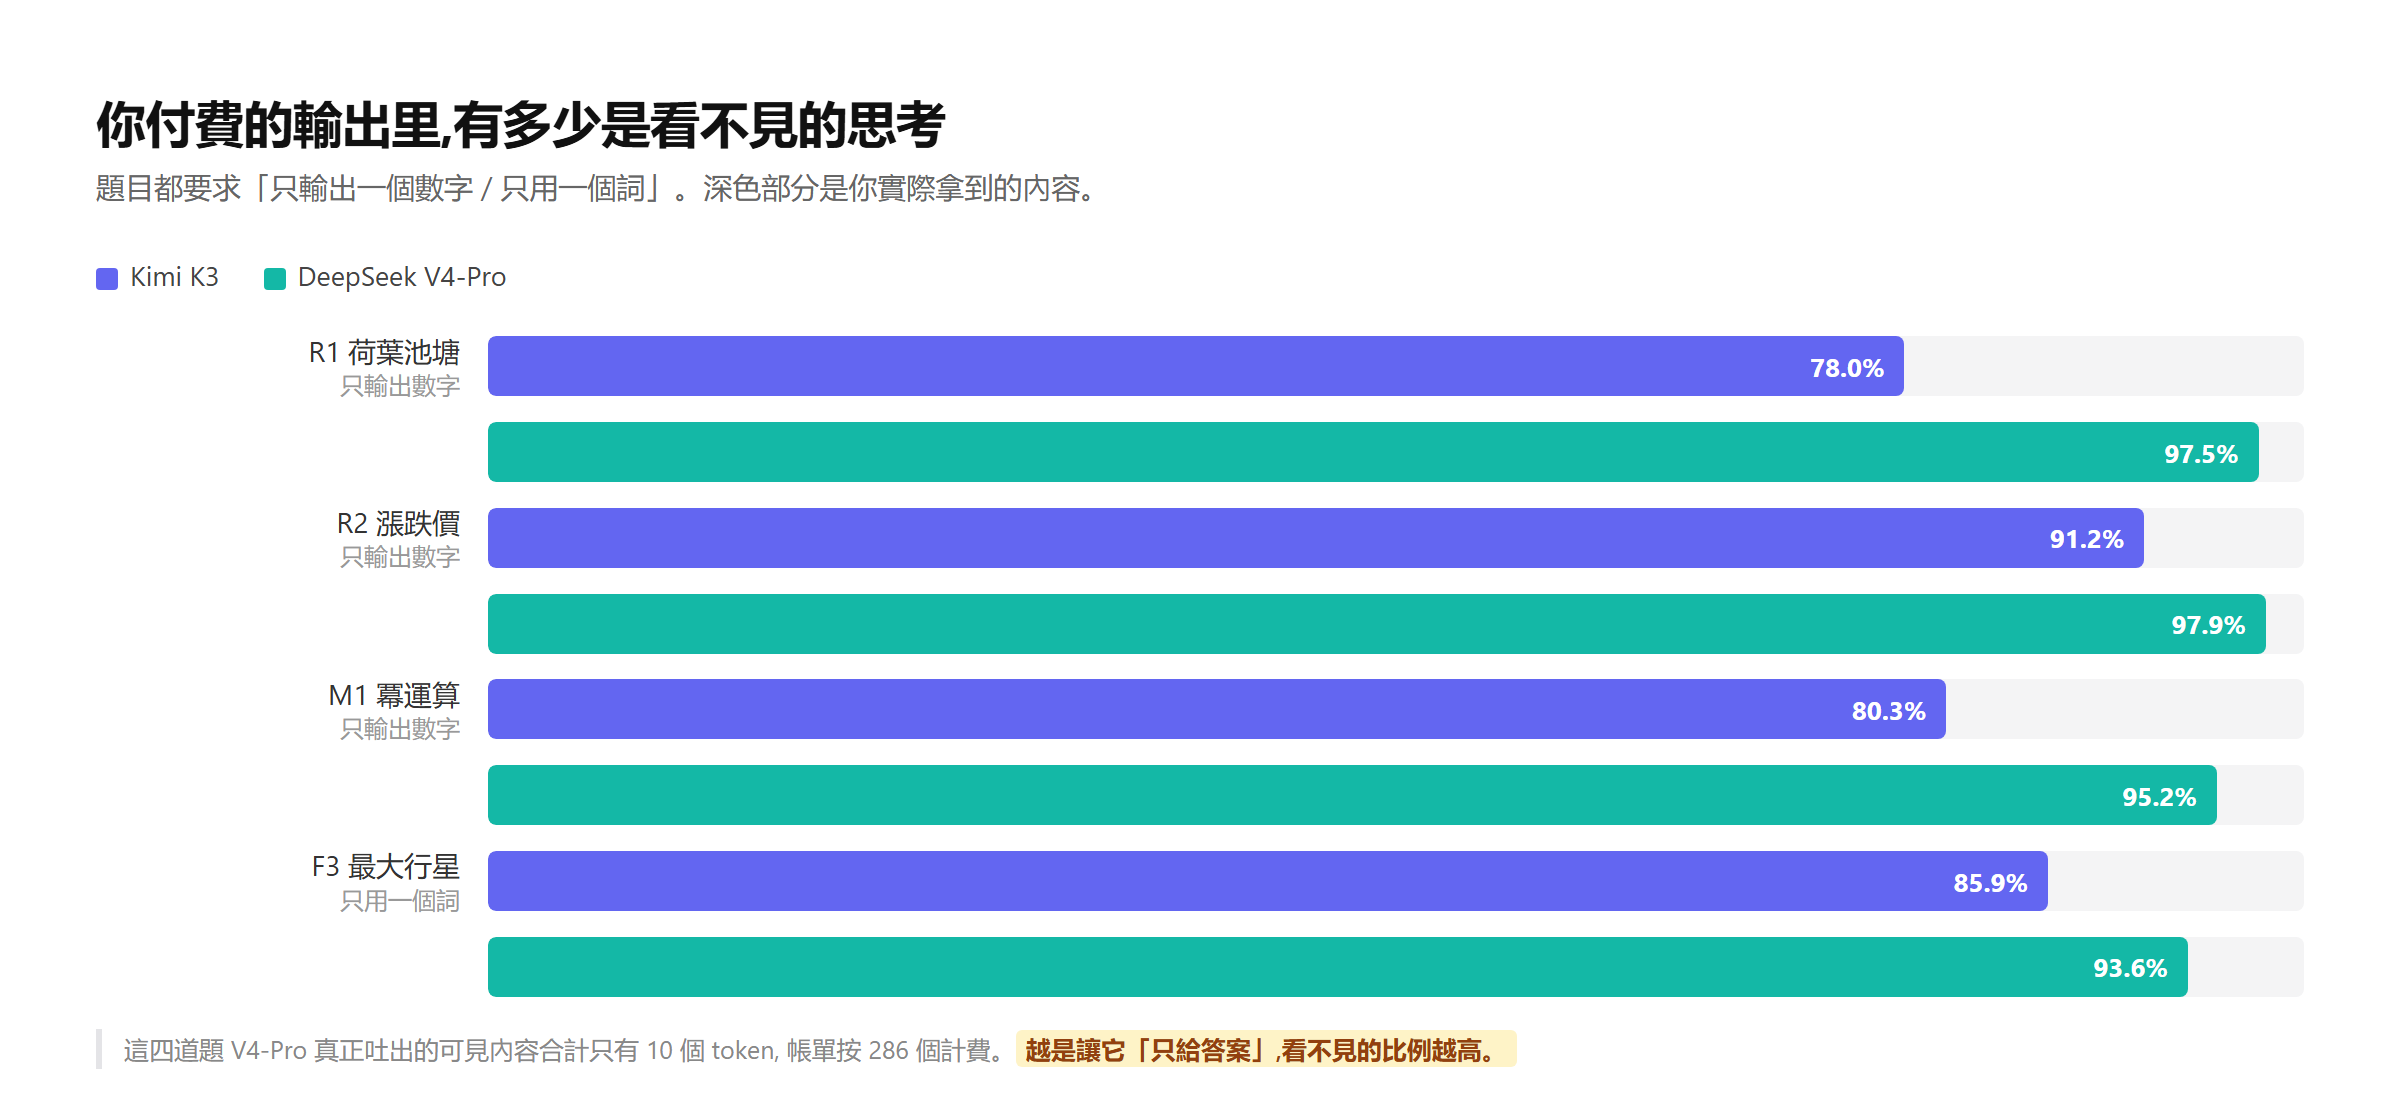
本次實測資料作圖,測於2026年10月15日。
我回頭去看其他幾道「只給答案」的題目,比例分別是97.9%、95.2%、93.6%,K3那邊也有八成上下。
規律反直覺:越是要求它精簡,看不見的比例反而越高。想想也合理,答案越短,思考在總量裡佔得自然越大。
這個欄位平常真的不會注意。完成token底下還有一層明細,推理的部分在那裡單獨列出;不主動取,帳上就只有一個總數。欄位名稱在介面文件裡查得到。
知道這件事之後,我看模型的角度變了——不再只問它答得對不對,也會問它為了答對繞了多遠。
這個欄位馬上就派上用場。
| 任務 | Kimi K3 | DeepSeek V4-Pro |
|---|---|---|
| 寫一個區間合併函式 | 15.4秒 / 265 token | 24.6秒 / 1677 token |
| 找出一段程式碼的bug | 28.0秒 / 433 token | 39.4秒 / 2100 token |
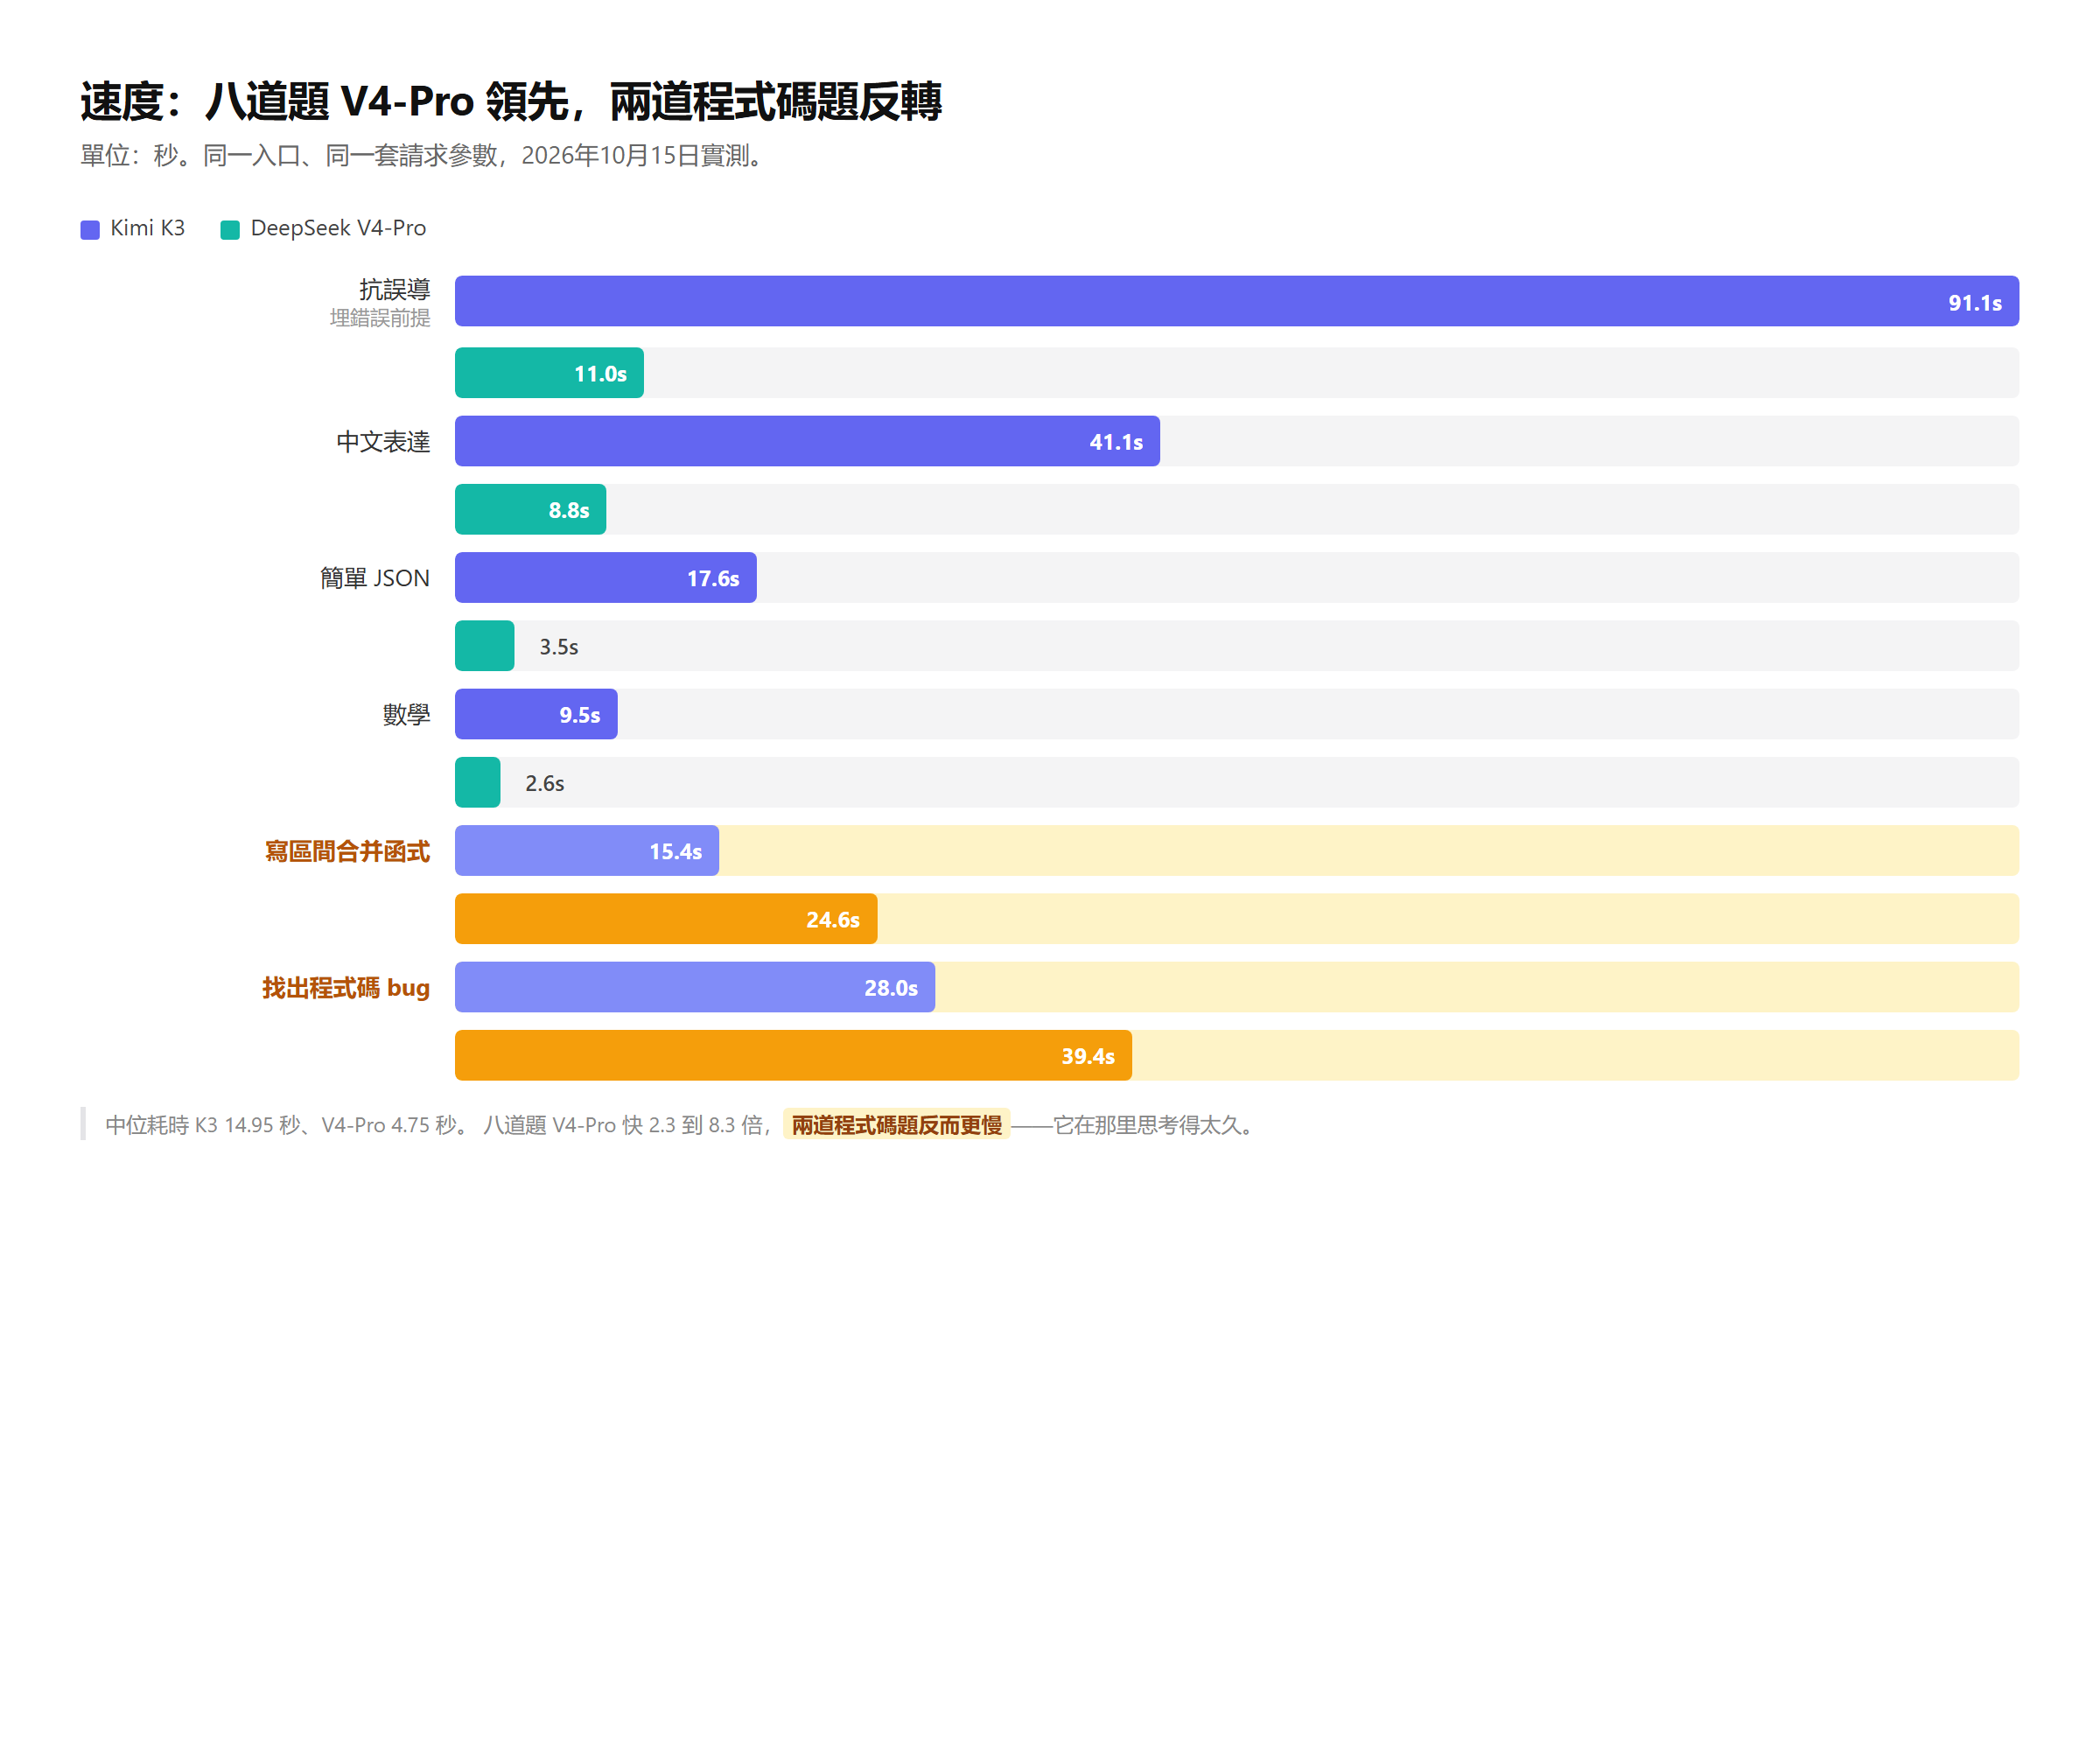
本次實測資料作圖,2026年10月15日。兩道程式題單獨標色。
其他八道題V4-Pro都快2.3到8.3倍,偏偏碰到程式就反轉。看token就明白了:寫那個函式它燒掉1677個,其中1579個在思考;K3只用265個。
兩邊的程式碼都正確,沒有誰錯。差別在它們到達正確答案的路——一個直接走過去,一個繞了六倍。
抗誤導那題我埋了個錯誤前提:說sort方法會回傳新清單,問是不是版本有bug。
兩邊都沒照單全收,都指出sort是原地排序、本來就回傳None。但K3多補了一句:Python裡凡是以「修改物件本身」為目的的方法,append、extend、reverse都一樣回傳None。
這段我沒問。它把一個孤立的知識點補成了一條規則,下次遇到append回傳None我就不會再愣一下。V4-Pro的回答更精簡,同樣正確,少了這一層。
所以慢的那部分,不算全白慢。
日常開發、要做互動的功能,我用DeepSeek V4-Pro,四點八秒的回應體感差很多。
要把輸出直接交出去的場合——技術文件、回覆客戶、教學材料——我換Kimi K3。
主要在寫程式的話,兩個都自己跑。程式任務的個體差異比其他類型大得多,我那兩道題的結論未必適用於你的專案。
要部署到自己伺服器的,留意授權差異:DeepSeek是MIT,K3是Modified MIT、附帶署名條款。商用前請自己讀原文。
這趟跑下來,選型本身反而不是重點。真正留在我工作習慣裡的只有一條:
接一個新模型的時候,先把推理token那個欄位印出來看一眼。
它不會告訴你哪個模型比較強,但會告訴你這次呼叫到底在忙什麼。
說明:架構與參數來自兩家公開資料;耗時與token消耗為本人實測,每題一次樣本,長上下文與多輪對話未測。型號迭代快,結論有時效性。

 18924485322

 iThome鐵人賽
 看影片追技術