
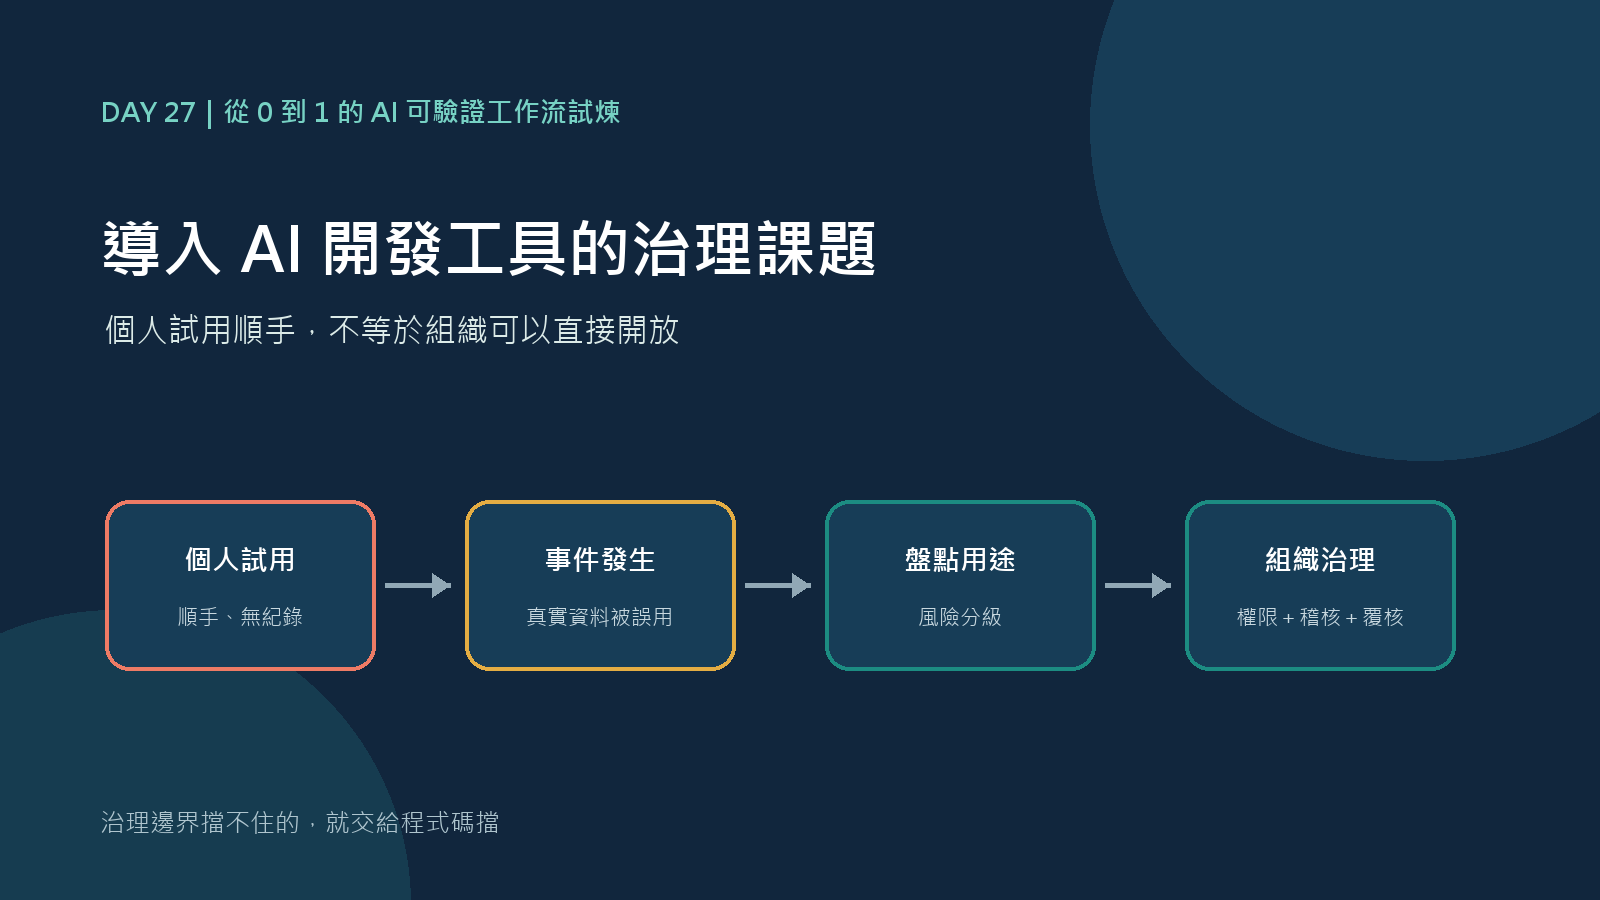
Day 26 把提示詞做成能重跑的團隊資產後,這週輪到我自己的組被抓包。有同事用 Codex 幫「AI 輔助生成系統」的光學字元辨識(Optical Character Recognition,OCR)前處理補單元測試,測試資料直接拿真實客戶掃描檔案。案例需求書第五節寫得清楚:資料要分級、含個資要能去識別化——只是那份分級標準,我們公司自己都還沒訂出來。工程師沒有惡意,他只是缺一份「哪些資料能給 Codex 碰」的清單。需求書第五節管的是系統怎麼保護「客戶」的資料;今天要處理的是開發團隊自己用 Codex 修系統時,能不能拿客戶資料當測試素材、誰批准、事後怎麼查。對象換了,盤點用途、依風險分級管控的邏輯可以直接借用。
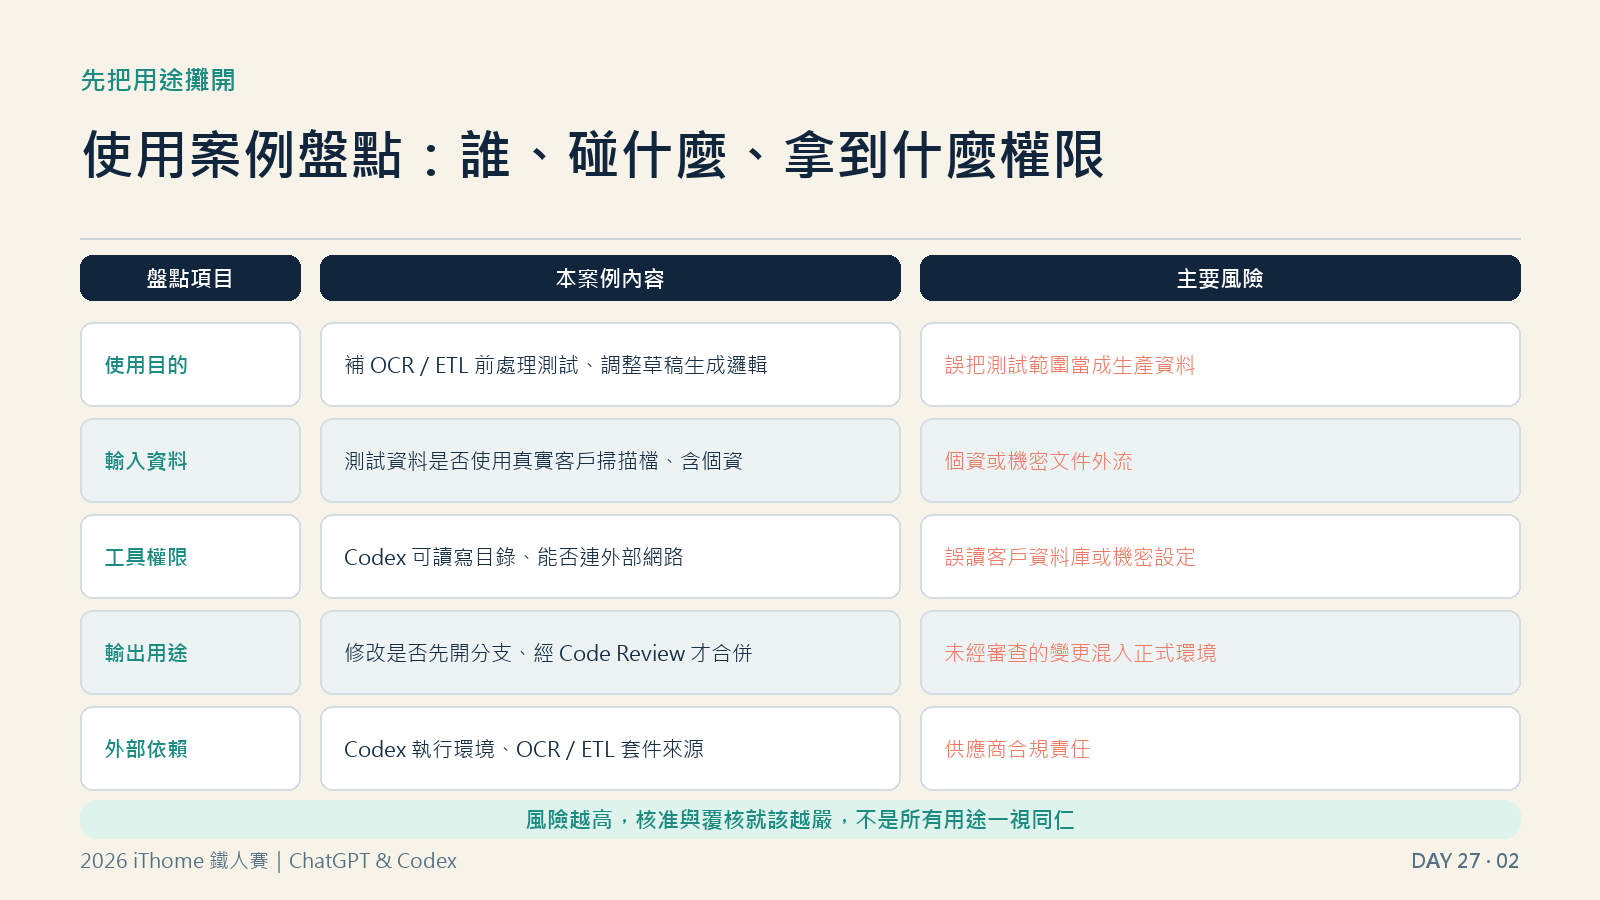
我把這次事件攤開成一張表:誰要用 Codex 做什麼、碰了什麼資料、拿到什麼權限、輸出會不會直接進正式環境。表裡的 ETL(Extract-Transform-Load,資料擷取轉換載入)指的就是需求書第四節那段 OCR 之後的文字清理與格式標準化流程。
| 盤點項目 | 本案例內容 | 主要風險 |
|---|---|---|
| 使用目的 | 補 OCR/ETL 測試、調整生成邏輯 | 誤用生產資料 |
| 輸入資料 | 是否用真實掃描檔、含個資 | 個資外流 |
| 工具權限 | 可讀寫目錄、能否連外網 | 誤讀客戶資料庫 |
| 輸出用途 | 是否經 Code Review 才合併 | 未審變更上線 |
| 外部依賴 | Codex 環境、OCR 套件來源 | 供應商合規責任 |
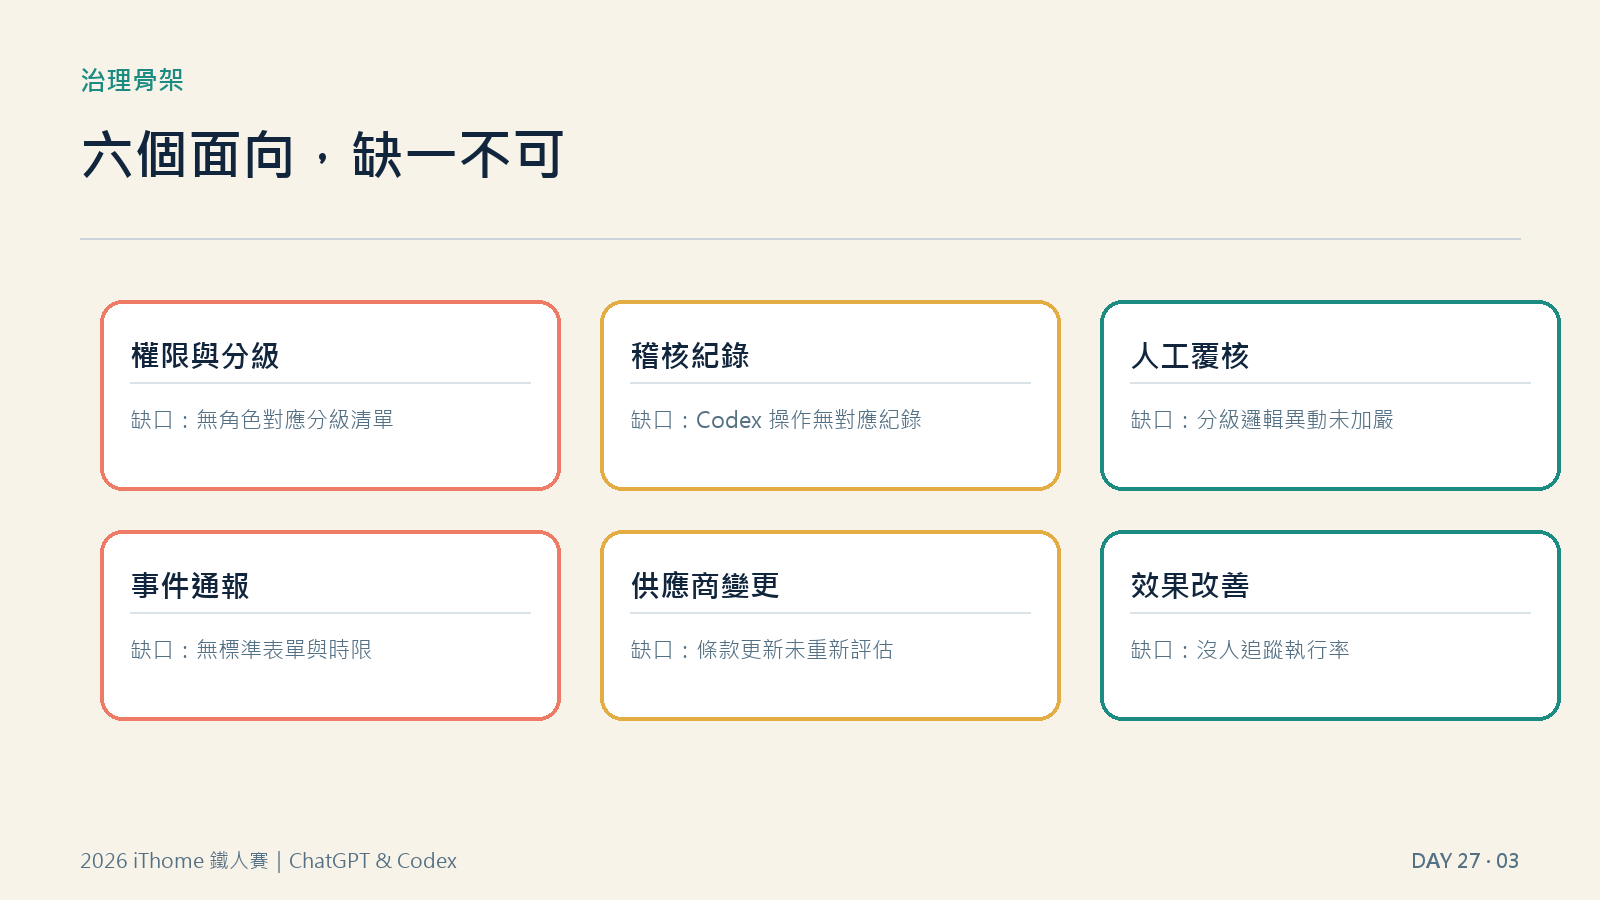
盤點只回答「這次事件出了什麼問題」,治理骨架要回答「下次怎麼提早擋下來」。現況多半只有系統對客戶的承諾,開發團隊自己這一層還是空的。
| 治理面向 | 缺口 | 下一步控制 |
|---|---|---|
| 權限與分級 | 無角色對應分級清單 | 訂公開/內部/限閱三級 |
| 稽核紀錄 | Codex 操作無對應紀錄 | 留存任務、核准人與執行紀錄 |
| 人工覆核 | 分級邏輯異動未加嚴 | 觸及存取控制要求雙人覆核 |
| 事件通報 | 無標準表單與時限 | 訂窗口、24 小時內回報 |
| 供應商變更 | 條款更新未重新評估 | 版本異動觸發重新評估 |
| 效果改善 | 沒人追蹤執行率 | 每季檢討,回饋進 SOP |
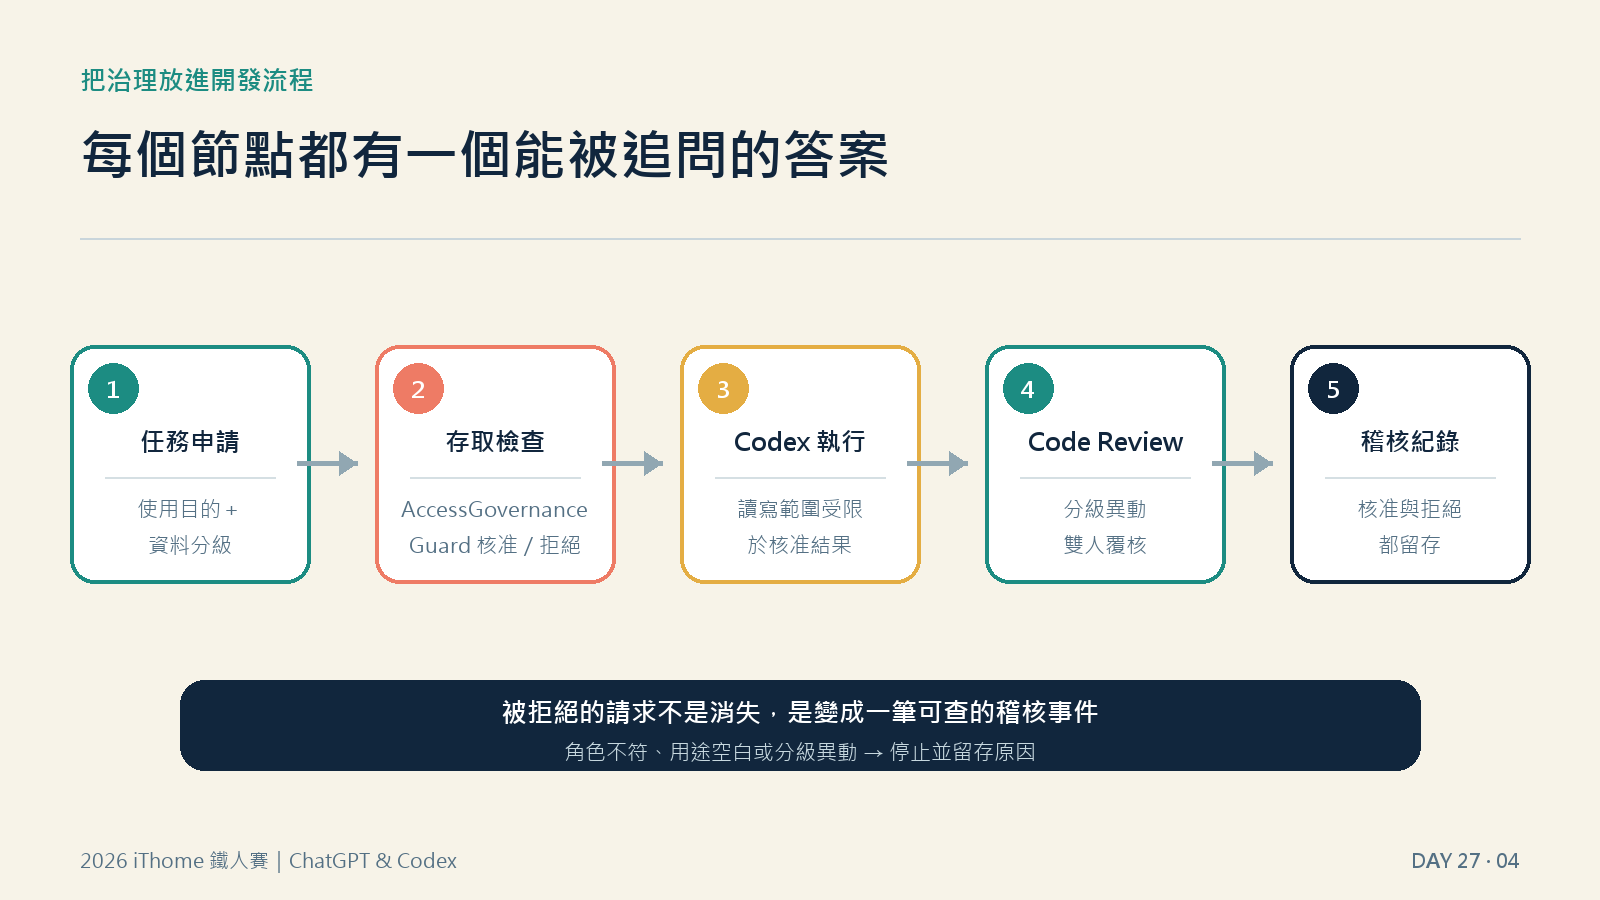
規則寫在文件裡,工程師照樣可能沒看到。我加了一段最小的 Java 檢查,把角色能碰哪一級資料做成程式契約:被拒絕的請求一樣留下紀錄。
boolean approved = ALLOWED_ROLES.get(classification).contains(requester);
events.add(new AuditEvent(Instant.now(), requester, classification, normalizedPurpose, approved));
if (!approved) {
    throw new SecurityException(requester + " 無權存取 " + classification + " 等級資料:" + normalizedPurpose);
}
工程師角色申請存取「限閱」等級的客戶掃描檔會被擋下並記錄,只有法遵/資安角色能通過。這只驗證存取判斷本身,不含檔案系統、單一登入或稽核儲存,完整測試見程式碼目錄。
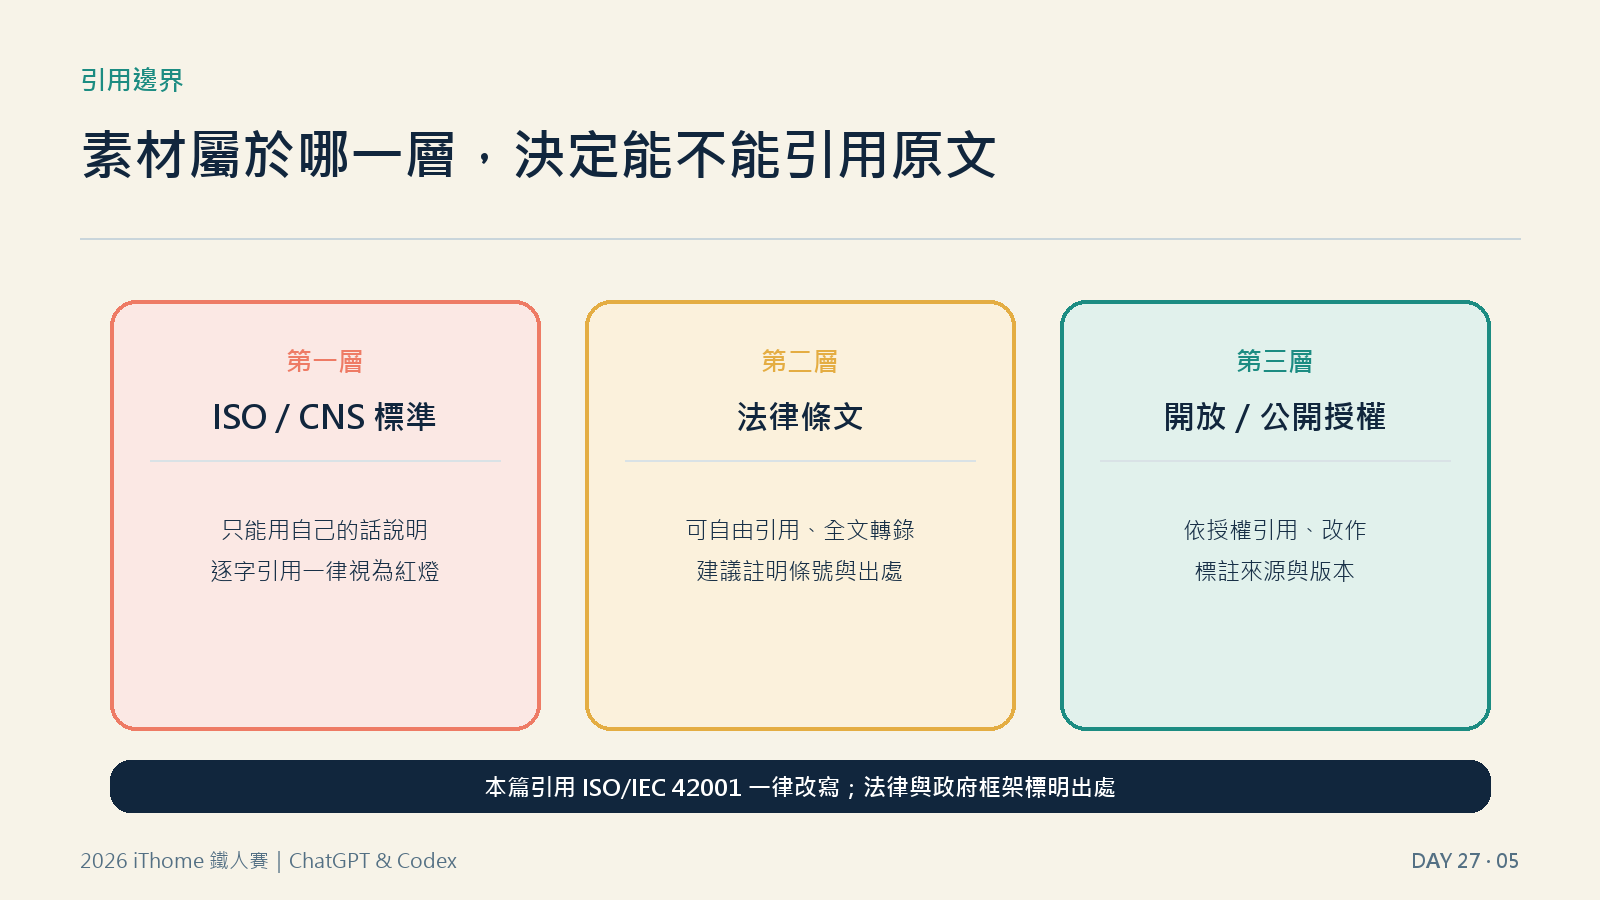
需求書建議比照資訊安全管理相關標準(例如 ISO/IEC 42001)檢視內控措施,對照方式仍待法遵與資安確認。ISO 標準受著作權保護,我只用自己的話說明條款要求什麼,不逐字引用或翻譯。法規面,《人工智慧基本法》已於 2025 年 12 月三讀通過、2026 年 1 月公布施行,主管機關為國家科學及技術委員會;數位發展部依該法訂定的人工智慧風險分類框架同年 7 月發布,採「盤點應用情境、識別風險、評估風險、應對風險」四步驟。這些屬於可直接引用出處的公開資料,怎麼對應到我們的 Codex 情境,仍要法遵與資安逐案確認。
盤點表讓「Codex 能不能碰這份資料」從個人判斷變成有紀錄可查的決定;治理骨架也提醒我,這是要跟著事故持續修的清單,不是一次寫完的文件。風險不對等卻套同一套流程,高風險存取反而被稀釋;控制寫進系統但沒人追蹤執行率,等於沒做。
今天把治理從公告變成一份盤點表、六個面向的缺口清單,以及一段真的會擋下請求的程式碼。缺口填完之前,這套流程只算起步。Day 28 會在這些護欄下,算開發「AI 輔助生成系統」這條流程實際花掉多少詞元(token)、時間與人工成本。


 iThome鐵人賽
 看影片追技術