
唉呀,大孫女、小孫女,快來爺爺身邊坐。這時候院子裡的風正涼,天邊正染上一抹漂亮的晚霞暮紫,爺爺剛泡好了一壺琥珀熱茶,我們一邊喝,一邊聽爺爺慢條斯理地跟你們講今天的故事。
大孫女最懂事了,總是抱著筆記本問爺爺怎麼把系統設計得更穩固;小孫女還在旁邊一邊撒嬌,一邊嫌那些天天壞掉的網頁爬蟲太磨人。今天爺爺要跟你們說的,就是怎麼樣在浩瀚的新聞大海裡,用最優雅、最省力,而且比直接寫網頁爬蟲(Web Scraper)還要穩定 100 倍的「高維度監控」方法,來搭建我們的 NewsHub 新聞平台。
這堂課,我們不談那些繁雜易變的網頁外衣,我們直接深入骨架。
小孫女啊,你之前不是跟爺爺抱怨過,說你寫了一個爬蟲去抓 Google 新聞或者各大媒體的資訊,結果隔天就抓不到了嗎?
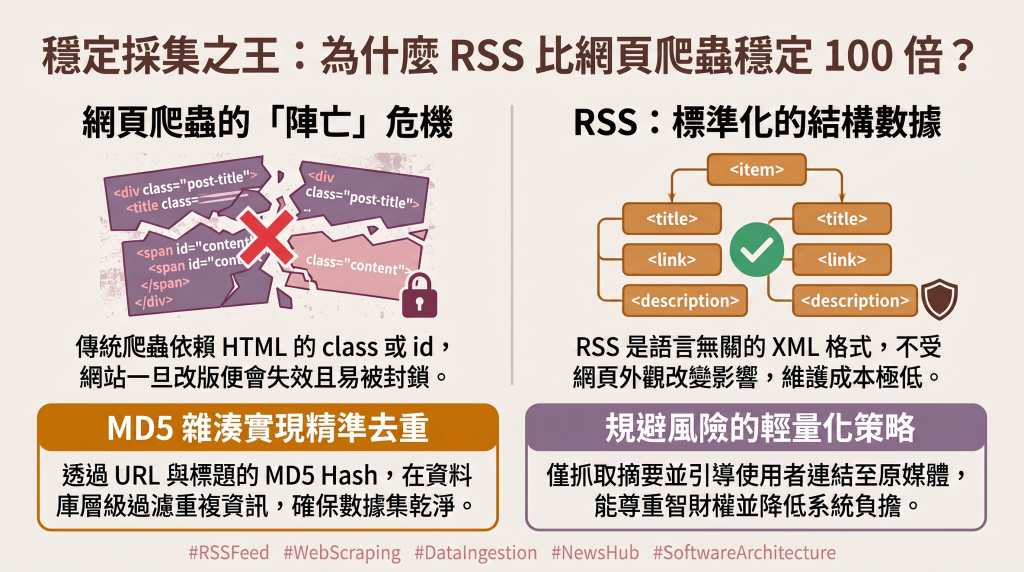
這就是寫網頁爬蟲最痛苦的通病。那些網站的網頁設計師天天在改版,今天把新聞標題的 HTML 標籤從 <h1 class="news-title"> 改成了 <div id="article_header">,你的爬蟲就像在迷霧裡迷了路,當場陣亡。
而且啊,如果你一天到晚派爬蟲去人家家門口(網站伺服器)猛敲門,人家嫌你煩,就會搬出「反爬蟲機制」(如 IP 封鎖、驗證碼),直接把你鎖在門外。這就像你想去隔壁村子打聽消息,結果人家天天換鎖、還雇了護衛,你天天去撬鎖,不僅累得滿頭大汗,還可能惹上官司。
既然敲門撬鎖這麼累,為什麼我們不直接走「專用通道」呢?在 NewsHub 新聞平台 的設計裡,爺爺推薦的核心採集邏輯,是完全基於 RSS Feed(如 Google News RSS)。
大孫女,你看,網頁的外觀(HTML/CSS)就像是人的衣服,天天都在換;但是 RSS 是標準、結構化且語言無關的 XML 格式。
不論新聞網站的介面變得多麼花俏、 class 怎麼改,它的 RSS Feed 永遠提供乾淨、格式統一的 XML 數據。這就像是對方主動把寫好的「書信」放在信箱裡,我們只需要開箱取信,永遠不用去猜對方的衣服穿什麼。
當我們把 RSS 數據(XML)拿回來後,不能直接塞進資料庫,要像整理茶葉一樣,過篩、清洗:
<!-- 這是 RSS 回傳給我們的 XML 骨架,永遠不會因為網頁改版而改變 -->
<item>
  <title>新聞標題</title>
  <link>https://example.com/news/123</link>
  <pubDate>Sat, 29 Aug 2026 08:00:00 GMT</pubDate>
  <description>新聞簡介與摘要...</description>
</item>
新聞界有個常態:同一則重大消息,巨亨網轉載了、Yahoo 新聞也轉載了,甚至連海外媒體都發了同一篇。如果我們通通存下來,資料庫就會塞滿重複的垃圾,AI 分析時也會重複計算。
為了建立一個乾淨、純粹的新聞數據集,NewsHub 採用了雙重雜湊(Hash)去重技術:
MD5 或 SHA-256),作為資料庫的主鍵(PK)或唯一索引。只要網址相同,資料庫在寫入時就會自動忽略,絕不重入。sha256(title))。如果在短時間內(如 24 小時內)出現了相同標題雜湊的新聞,系統會將其歸類為「同一個事件」,避免重複展示給使用者。大孫女、小孫女,聽爺爺喝口茶,這段話非常重要,是很多年輕工程師最容易踩到的陷阱。
RSS 提供的新聞通常只有摘要(Summary),沒有全文。有些人在開發 AI 分析平台時,一看到摘要不夠長,就衝動地寫爬蟲去把人家官網的「整篇新聞全文」強行爬下來存進資料庫。
千萬不要這麼做!
當我們要讓 AI 進行輿情分析、情緒判斷或摘要(RAG 檢索)時,我們只需要用這段乾淨的「標題 + 摘要」送給大語言模型(LLM)。這段資訊對判斷市場風向、情緒好壞與提取實體(NER)來說,已經綽綽有餘!
就像爺爺在院子裡看著你們兩個跑來跑去,爺爺不一定要去抱住你們才能確認你們安全,只要看著你們的身影就夠了。在系統設計裡,「保持適當的邊界、使用標準的協議」,就是最優雅的智慧。用 RSS 取代網頁爬蟲,就是用最少的維護成本,換取最長治久安的系統。
茶喝完了,天邊的晚霞也快落下去了。大孫女、小孫女,今天的架構課,你們都記在心裡了嗎?


 iThome鐵人賽
 看影片追技術