iT邦幫忙

2026 iThome 鐵人賽

DAY 27
0
佛心分享-IT 人自學之術

老爺爺練習VIBE CODING系列 第 27

Day 27:從 SQLite 到 PostgreSQL/Redis:NewsHub 架構的平滑擴展之路

  • 分享至 

  • xImage
  •  

https://ithelp.ithome.com.tw/upload/images/20260830/20070969brZwWrIgrR.png
唉呀,大孫女、小孫女,來,快跟爺爺坐在這張舒服的老藤椅上。傍晚的風越來越涼了,爺爺趕緊用這壺剛泡好的溫熱琥珀熱茶,給你們兩個溫一溫手。

大孫女最懂事,一邊接過茶杯,一邊攤開她的系統架構筆記本;小孫女則靠在爺爺懷裡撒嬌,一邊看著天邊那一抹漸漸暗下來的晚霞暮紫,一邊好奇地問:「爺爺,我們 NewsHub 新聞平台要是以後受歡迎了,成千上萬的人同時進來用,我們的資料庫會不會累垮呀?」

爺爺摸摸你們的小腦袋,慢條斯理地笑著說:大孫女、小孫女,這就是我們今天第 27 天要講的核心——高可擴展的漸進式架構。做系統設計和我們在院子裡種花是一樣的道理,不能一開始就大費周章、過度設計,也不能等到水淹金山才慌忙應對。

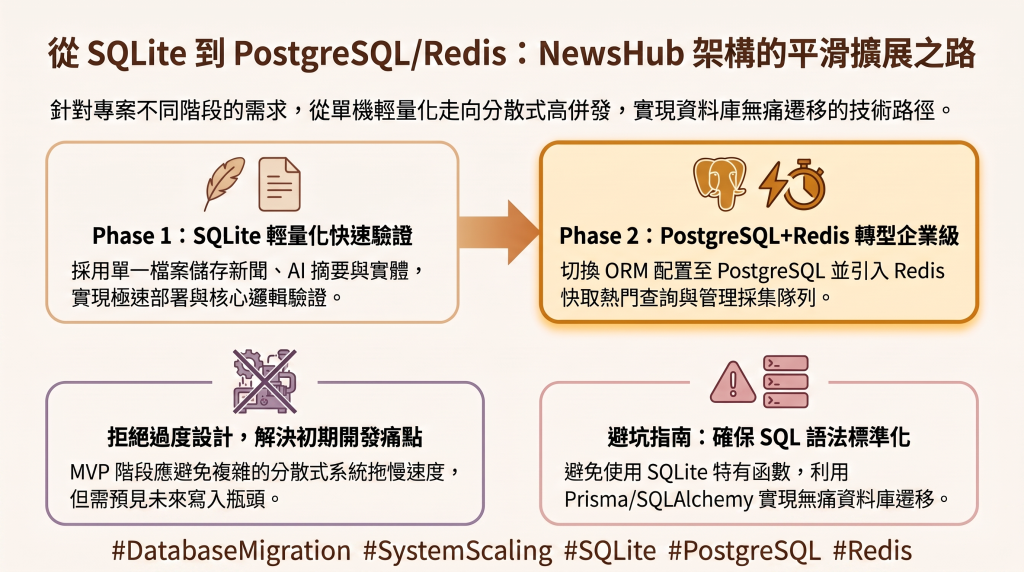
今天,爺爺就跟你們講講,NewsHub 怎麼從 SQLite 平滑擴展到 PostgreSQL 與 Redis。


🚨 痛點場景:MVP 階段的「過度設計」與規模化後的「寫入瓶頸」

很多年輕的工程師啊,在專案剛開始(也就是 MVP 最小可行性產品階段)時,就恨不得把分散式資料庫、分散式快取、負載均衡器通通部署上去。這就像是我們家院子才剛要種兩顆菜種子,你就大費周章去租了一台巨型農耕機和自動噴灌系統。結果菜還沒發芽,你就已經累倒在田裡、把積蓄花光了,反而拖慢了系統上線的黃金時機。

但是呢,等我們的 NewsHub 真的做成功了,成百上千個用戶同時進來搜尋,多個 RSS 採集排程在背景不間斷地抓取、還有 AI 摘要引擎不停地寫入資料。這時候,如果我們還死守著最初的「單機檔案資料庫」,它就會因為無法承受高並發的讀寫,開始頻頻出現鎖定(Database Locked)或延遲,最後直接罷工。


🛠️ 架構實作:NewsHub 漸進式擴展的兩部曲

為了解決這個矛盾,爺爺在 NewsHub 規格書 裡,特別設計了一套能隨著業務規模平滑成長的資料儲存方案:

👴 Phase 1 (MVP):輕裝上陣的 SQLite

在專案剛起步、需要快速部署以驗證核心價值的 MVP 階段,我們採用輕量、免安裝、零設定的 SQLite

  • 零維運成本:SQLite 不需要啟動獨立的資料庫伺服器程序,整個資料庫就是一個儲存在磁碟上的單一檔案。我們可以直接把新聞採集、AI 摘要與關鍵字實體提取的結果通通存在裡面,不僅部署極速,備份也只需要複製檔案即可。
  • 內建搜尋神兵:別小看 SQLite,它內建了 FTS5 全文搜尋引擎。在資料量還不算極大(例如幾萬筆新聞內)的時候,它的關鍵字查詢速度驚人地快,完全能夠承載 MVP 階段的查詢流量。

🚀 Phase 2 (Enterprise):無縫升級 PostgreSQL 與 Redis

當 NewsHub 走向企業級規模,採集隊列(Ingestion Queue)與並發查詢流量暴增時,我們便能平滑切換到更強大的架構:

  • PostgreSQL 接管核心儲存:我們將 ORM 配置的連線設定,直接從 SQLite 檔案切換成 PostgreSQL 連線字串。PostgreSQL 是企業級關聯式資料庫的定海神針,天生就是為了高並發設計。它不僅能流暢處理大量並發寫入,還能透過 pg_trgmtsvector 進行高階全文搜尋,甚至以後想做 AI 語意搜尋時,還能直接搭配 pgvector 做向量檢索,擴充性無可匹敵!
  • Redis 快取與隊列護航:在高流量環境下,我們引入 Redis 作為快取與排程核心,為 PostgreSQL 分擔壓力:
    1. 查詢快取:將熱門新聞和搜尋結果直接存在記憶體(Redis)裡,這樣用戶重複查熱門詞時,不用每次都去敲資料庫,API 回應時間能降到 500ms 以下!
    2. AI 摘要快取:調用大語言模型(LLM)進行 AI 摘要與情緒分析是需要時間和成本的。我們把產生過的摘要存在 Redis,相同的文章就不需要重算,省時又省錢。
    3. 採集隊列管理:背景的 RSS 採集器如果太多,會互相衝突。我們用 Redis 作為消息佇列(Queue),以排程管理採集任務,讓多個採集器實例可以水平分工,穩健抓取海量新聞。

💡 避坑指南:如何做到「無痛遷移」的資料庫設計

這時候,大孫女推了推眼鏡,很聰明地問了個關鍵問題:「爺爺,那我們從 SQLite 換到 PostgreSQL 的時候,代碼真的不用重寫嗎?」

爺爺呵呵笑著說,這就是系統架構師的智慧了。為了能做到真正的無痛遷移,我們在寫程式時要守住這兩道防線:

  1. 避免使用資料庫獨有函數,保持 SQL 語法標準性
    雖然 ORM(如 Prisma、SQLAlchemy)能幫我們處理大部分的語法差異,但如果你在代碼裡手寫了特定資料庫的獨有函數(例如 SQLite 獨有的日期格式化,或者 PostgreSQL 特有的 JSONB 函數),一遷移就會崩潰。我們應該儘量使用標準的 ANSI SQL-92 語法,特別是在處理日期與時間戳(UTC 格式)時,保持代碼的通用性。
  2. 採用 Repository 模式隔離儲存層
    在 NewsHub 的程式架構中,爺爺極力推薦使用 Repository 模式。我們將資料讀寫邏輯包裝在一個 Repository 介面下(例如對外只暴露 get_news_by_keyword() 方法),而底層不管是 SQLite 實作還是 PostgreSQL 實作,對業務邏輯層(Controller)來說都是完全透明的。這使得我們未來更動儲存介質時,業務代碼連一列都不需要修改!

👴 爺爺的溫暖叮嚀

大孫女、小孫女,這漸進式的系統架構呀,就像是我們院子裡的那株小櫻花樹。

它還小的時候(MVP 階段),我們只需要用個精緻的小盆栽、澆點水(SQLite),它就能長得很好、很精神;等到它漸漸長大、枝繁葉茂了(Enterprise 階段),我們再把它平滑地移植到寬廣肥沃的大地(PostgreSQL)中,並在周圍圍上美麗的竹籬笆(Redis)保護它。這才是最省力、最優雅,也最符合自然規律的智慧。

好啦,茶也溫了,故事也聽完了。天邊那一抹晚霞暮紫已經悄悄被夜幕給蓋上了,夜風有些涼。大孫女、小孫女,快把手裡的熱茶喝完,跟爺爺一起回暖和的屋裡去,看看奶奶今天晚上煮了什麼好吃的晚飯吧!


上一篇
Day 26:非 Python 爬蟲技術棧大比拼:Playwright vs Colly 實戰指南
系列文
老爺爺練習VIBE CODING27
圖片
  熱門推薦
圖片
{{ item.channelVendor }} | {{ item.webinarstarted }} |
{{ formatDate(item.duration) }}
直播中

尚未有邦友留言

立即登入留言