
大孫女,你昨天聽爺爺講完 RSS 的定海神針妙處後,是不是一整晚都在想著:「要是遇到那些真的不提供 RSS 的頑固網站,而且公司出於維運、資安或既有系統的考量,偏偏不讓我們用 Python 寫爬蟲,那我們該怎麼辦呢?」
小孫女也在一邊抱著爺爺的手臂撒嬌,一邊好奇地問:「對啊爺爺!大家都說 Python 是爬蟲的天下,要是不能用 Python,我們是不是就只能手動複製貼上了?」
爺爺呵呵笑著,摸摸你們兩個的小腦袋。這時候院子裡的老藤椅深膠襯著天邊那一抹漸漸暗下來的晚霞暮紫,爺爺給你們倒滿了暖呼呼的琥珀熱茶,我們一邊吹涼,一邊聽爺爺跟你們講講非 Python 爬蟲的「神兵利器」。
在企業級的真實環境中,如果不允許使用 Python,我們其實有更多、甚至在效能和穩定性上遠超 Python 的技術棧可以選型!今天,爺爺就給你們上一堂:「Playwright vs Colly 實戰指南」。
在一般的學校專案裡,大家最愛用 Python 寫爬蟲,因為簡單好上手。但在大企業的生產環境中,往往有嚴格的技術規範。
有些公司的主力系統是微軟技術棧,有些則是重型的 Java 企業級架構,或者出於效能、多執行緒併發的管理,不希望在伺服器上額外安裝 Python 的執行期(Runtime)與雜亂的虛擬環境。這個時候,如果需要爬取資訊,我們就必須尋找非 Python 的解決方案。
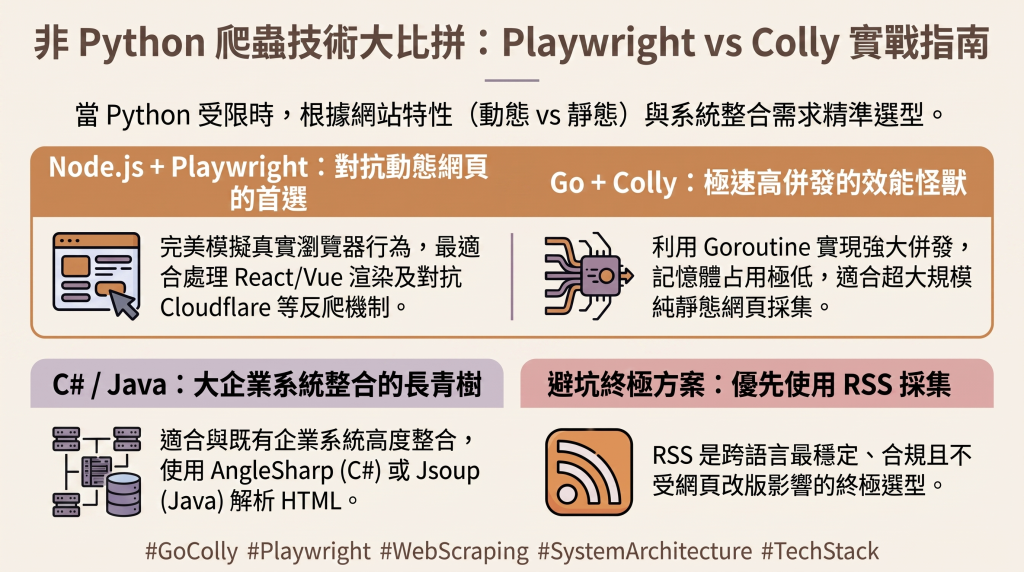
大孫女、小孫女,快拿筆記本記下來。根據非 Python 技術棧選型指南,我們要把不同的技術,用在最適合的戰場上:
如果我們要對抗的是高度動態渲染(如 React、Vue 等 SPA 框架),或者是裝了強大反爬蟲防禦系統(如 Cloudflare 驗證牆)的現代網站,Node.js 加上 Playwright 是爺爺最推薦的首選。
evaluate 腳本,解析動態資料就像在自己家一樣自然。要是大孫女的專案,是要去爬取超大規模、純靜態網頁(比如幾十萬頁的歷史報表、靜態論壇資料),那 Playwright 就太笨重了。這時我們需要的是 Go 語言的 Colly 框架。
如果我們的系統需要跟企業既有的重型系統(例如 ERP、帳務核心)高度整合,那我們就直接融入既有技術棧,使用 C# 或 Java:
.exe 讓業務人員雙擊即用。大孫女、小孫女,雖然上面這些兵器看起來很威風,但爺爺還是要叮嚀你們一句:「能不寫爬蟲,就不要寫爬蟲。」
無論你們用 Playwright 把瀏覽器模擬得再像、或者用 Go Colly 跑得再快,只要對方網頁的 HTML 結構改版,你們昨晚熬夜寫的解析代碼,今天照樣會失效。
所以,記住爺爺這條最頂尖的架構思維:如果目標網站提供了 RSS Feed,永遠優先使用 RSS 採集!
解析 RSS(XML)不需要動用沉重的 Playwright 瀏覽器自動化,也不需要去處理複雜的反爬蟲,任何語言(Node.js、Go、C#、Java)只需要用最基礎的 HTTP 套件配上 XML Parser 就能穩如泰山地抓取資料。這才是跨語言最穩定、最安全、最合規的「終極選型」!
小孫女,現在不覺得爬蟲很難搞了吧?不能用 Python,我們還有 Playwright 幫我們對付繁雜的動態頁面,還有 Colly 幫我們沖鋒陷陣,甚至還有萬能的 RSS 幫我們一勞永逸。
大孫女,你聽完今天這堂課,手是不是又癢了,想把這些技術架構寫進你的新系統規格書裡?
天色真的暗了,夜風涼了起來,你們把熱茶喝完,跟爺爺一起進屋準備吃晚飯吧。


 iThome鐵人賽
 看影片追技術