
 設計核心,並結合日常實務,點撥其中最容易被忽視的資安細節。
諸位請入座。寡人向來以為,治國理政與精進專業無異,皆貴在「知行合一、利民便用」。今日此項教育訓練,並非令諸位死記教條,而是要讓大家掌握在生成式 AI 時代,能切實化繁為簡、提升效能,同時確保資訊安全的數位防禦利器。
在與 AI 協作的浪潮中,大眾往往只看見其便利,卻忽略了數據背後的隱私風險。以下,寡人將為各位同仁逐步拆解
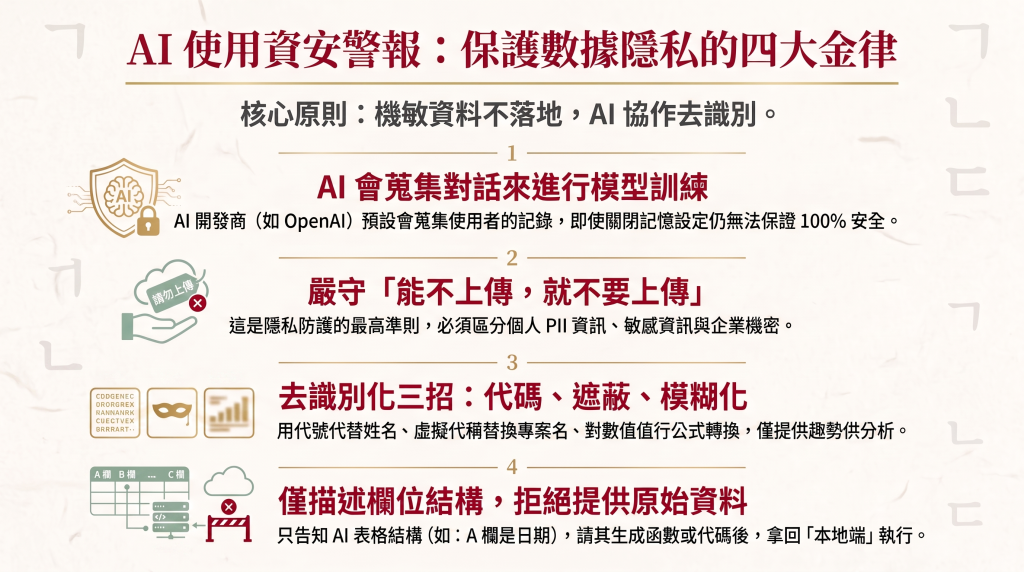
大眾在與生成式 AI 對話時,常將其視為一位萬能的「真人顧問」,卻不知其運行本質背後僅是大量的數學矩陣與語意機率運算。諸位在對話框中所輸入的每一行字、上傳的每一份檔案,在預設情況下,都可能被開發商蒐集用來訓練未來的 AI 模型。
若我們在無意間將個人的私密資訊、或者是組織內部尚未公開的機密數據交付給 AI,便等同於將這些機敏資訊無防備地散播在公共網路中。因此,「能不上傳真實資料,就不要上傳」,是我們進入 AI 協作時必須立下的第一條鐵律。
既然我們希望利用 AI 提升效率,又不能提供真實資料,唯一的出路便是學會 「將情境與資料去識別化」。寡人將親自引導諸位實作以下三種去識別化技巧:
對於上萬筆的大量數據,如果逐一複製貼上,不僅效率低落,更有極高的洩密風險。本單元將教授一項高階且安全的合作模式:我們不給 AI 任何一筆真實數據,僅向它描述我們的「資料欄位長相」。
在實作 AI 生成 Excel 函數時,寡人常看見求學者踩入以下兩個誤區,諸位必須特別留意:
「諸位研習之士,治國有法,防務有方。今日我們研習此資安防禦之道,並非要阻礙大家使用新科技,而是要讓大家在穿上堅固的鎧甲後,方能更放膽地在 AI 的戰場上馳騁。
大家在日常工作與日常生活中,是否也曾無意間將含有同仁名字、或是機密合約的對話直接貼給 AI 呢?在我們明日進入『如何對抗 AI 幻覺與評估數據品質』的課程前,大家是否已準備好,將手中的模擬資料進行去識別化的實兵操練了?」


 iThome鐵人賽
 看影片追技術