iT邦幫忙

2026 iThome 鐵人賽

0
佛心分享-IT 人自學之術

資訊安全系列 第 42 篇

Day 42:對抗 AI 虛假資訊與數據源頭品質安全

  • 分享至 

  • xImage
  •  

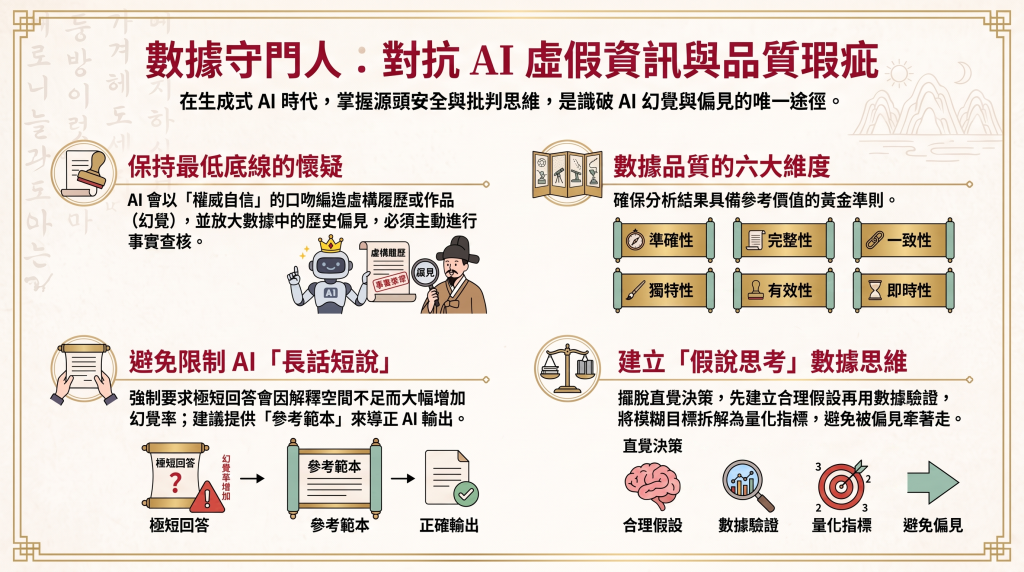
https://ithelp.ithome.com.tw/upload/images/20260901/20070969hJCE5K35TL.png
諸位請入座。寡人向來以為,治國理政與精進專業無異,皆貴在「知行合一、利民便用」。昨日,我們已共同研習了如何穿上資安的鎧甲,學會了「個資去識別化」與「只提供欄位結構」的安全協作法則,確保在與 AI 溝通時,隱私絕不外洩 ``。

然而,僅僅守住數據的隱私,還稱不上真正掌握了經世致用的利器。寡人要帶領諸位越過防守,進入「辨偽存真」與「主動出擊」的境界。在數位資訊氾濫的時代,AI 產出的虛假訊息往往能欺瞞大眾,而我們自己手中的原始數據若品質不佳,亦會導致決策破產 ``。因此,今日之研習,意在開民智慧,建立諸位識破 AI 幻覺與偏見的雙眼,並掌握評估數據品質的準則與主動驗證的假說思維。


對抗 AI 虛假資訊與數據源頭品質安全

一、 破題導入:為何數據時代必須具備「批判性思維」?

大眾在享受 AI 帶來的便利時,常犯下「過度依賴」的錯誤,這會導致我們學習技能與批判性思維逐步下降 ``。面對 AI 滔滔不絕、一本正經的回應,我們絕不能全盤接收。

今日的授課核心,在於教導學員如何在龐雜的數位環境中築起防範虛假訊息的防線,並從源頭上確保數據的安全與品質 ``。這是一堂讓大眾從「被動接收者」蛻變為「客觀查核者」的必修課。


二、 逐步拆解:核心授課單元與防禦實務

單元五:識破 AI 幻覺(Hallucination)與提示詞防範

  • 認清 AI 說瞎話的本質:學員必須理解,AI 常常會以極度權威、自信的口吻,憑空編造完全不存在的虛假資訊,這在學術上稱為「幻覺」 ``。
  • 真實案例警示:詢問 AI 某位特定人士(如「林阿貓」)是誰時,AI 竟能捏造出她是香港傑出教師,並在某小學任教,甚至還煞有介事地附上假的資料來源網址,極具欺騙性 ``。
  • 避坑指南(字數限制的風險):大眾在使用 AI 時,為了圖方便常會下指令要求 AI「長話短說、在 20 字內回答」 。然而,研究指出,要求 AI 用更簡短的方式回答,反而會使其抗幻覺能力下降,產生更多錯誤與幻想。這是因為 AI 被剝奪了解釋細節與澄清錯誤前提的空間。
  • 防禦對策:學習撰寫防範提示詞,例如提供 AI 正確的參考範例(Multishot Prompting),或明確在提示詞中加入限制(如「沒有提及的功用,請不要自行腦補」) ``。

單元六:識別 AI 偏見(Bias)與保持最低懷疑

  • 偏見的底層來源:AI 的訓練數據源於人類歷史在網路上累積的痕跡,因此它會如實吸收,甚至在無意間放大社會中的種族、文化與性別偏見 ``。
  • 真實職場偏誤案例:2019 年亞馬遜(Amazon)終止了一項研發多年的秘密 AI 履歷篩選工具 。該系統因為使用了過去的招募數據進行訓練,導致演算法對女性求職者產生了嚴重的篩除偏見 。
  • 求學者的防禦心態:面對 AI 生成的所有內容,求學者應建立 「保持最低底線的懷疑」,隨手查核,切勿在不經求證的情況下直接引用 ``。

單元七:源頭安全——數據品質評估的六大維度

  • 數據分析的鐵律:「垃圾進,垃圾出(Garbage In, Garbage Out)」 。如果我們輸入的原始數據本身是有缺漏、格式雜亂的,不論用多強大的 AI 進行分析,得出的結果也只能是一堆無用的垃圾 。
  • 評估品質的六把尺:教導大眾在生活中運用「六大數據品質維度」來檢視資料安全性 ``:
    1. 完整性 (Completeness):檢查資料是否殘缺,例如電話號碼欄位是否無故出現大量空值 ``。
    2. 一致性 (Consistency):確保不同來源的資料定義前後相同(例如不會有幣別格式混亂的問題) ``。
    3. 獨特性 (Uniqueness):確認每筆記錄有唯一識別碼(如員工編號、身分證字號),不應出現重複計算的列 ``。
    4. 有效性 (Validity):檢查數值是否合乎規則,例如「年齡」不該出現負值,格式不該出錯 ``。
    5. 準確性 (Accuracy):數據是否真實且正確地反映真實世界的情況 ``。
    6. 即時性 (Timeliness):數據的新鮮程度是否符合要求,這對變動迅速的金融或即時環境極其重要 ``。

單元八:生活與職場中的客觀假說思考法

  • 擺脫直覺決策:引導學員從「聽人說」的直覺思維,轉換為科學的數據思維 ``。
  • 什麼是「假說思考」? 指在面對問題時,我們不盲目在數據大海中撈針,而是根據過去的經驗與有限的資訊,提出最接近原因的「猜想與假設」,再主動去尋找對應的數據指標來檢驗它 ``。
  • 實例拆解(凌晨事故案):
    當觀察到「凌晨 2 到 5 時事故件數不是全天最高,但死亡率卻偏高」的現象時,我們可以引導學員建立三個假說:
    1. 假說一:深夜時段生理警覺最低,可能存在疲勞駕駛或酒駕,導致事故致命性高。
    2. 假說二:凌晨路況空曠、車速較快,一旦碰撞則能量巨大。
    3. 假說三:偏遠郊區發生事故,醫療救援抵達的時間較長。
      我們引導學員針對這些假設,列出其背後的「理由」,並指定「可驗證的方式」(例如比對車速數據、事故路段或酒測比例),在不符時快速修正、反覆迭代,這才是科學防禦的態度。

三、 實務點撥:大眾最易犯的視覺化與查核誤區

  • 誤區一:盲目相信 AI 生成的精美圖表
    • 實務點撥:「AI 在直接繪製圖表時極易出錯!」 。AI 具備強大的美化與繪圖模型,它生成的圖表可能極其精美、色彩亮麗,但背後的數據比例、對應座標與數值卻常常漏洞百出 。因此,我們絕不能看到圖表漂亮就直接採用,必須進行本地端的手動檢核與數據對齊。
  • 誤區二:對分析報告做出過度的不實推論
    • 實務點撥:在使用 AI 撰寫分析報告時,必須善用追問提示詞(Prompt),要求 AI 將分析整理成表格,並嚴格標示:「觀察重點|支持數字|可以怎麼說|目前不能推論什麼」 。例如:從 1 到 6 月的數據中,我們「不能推論全年度的受傷人數」,因為資料時間尚未完整 ;看到 2 月受傷人數高,「不能直接得出 2 月出門很危險」的結論,因為必須考慮到假期與交通密度的綜合影響 ``。這能防止求學者被片面的數據假象誤導。

四、 提問與激勵

「諸位研習之士,兩日的訓練,我們從第一天的『如何與 AI 安全溝通、隱私不外洩』 ,走到了第二天的『如何辨識 AI 的假話、確保自己手裡拿的是真話』 。

治國與治學,皆不容半點虛假與疏漏。當諸位在未來的職場與日常中,面對 AI 一本正經的回答時,是否能時時警醒,舉起我們今天所學的『品質六大維度』與『最低懷疑』的盾牌呢 ?


上一篇
Day 41:AI 工具使用的資安素養與數據隱私防禦
下一篇
Day43:雲端資料外洩防護(DLP)與個資保護守則
系列文
資訊安全 共 43 篇
圖片
  熱門推薦
圖片
{{ item.channelVendor }} | {{ item.webinarstarted }} |
{{ formatDate(item.duration) }}
直播中

尚未有邦友留言

立即登入留言