
本日文章的內容脈絡
透過前兩天先把一件每天都在做的工作攤開來看。
第一天問的是,我到底怎麼把這件事情做完?
第二天再往下追,這件每天重複發生的工作,每一次真的都一樣嗎?
到了今天想再停在其中一個更容易被忽略的地方。
判斷。
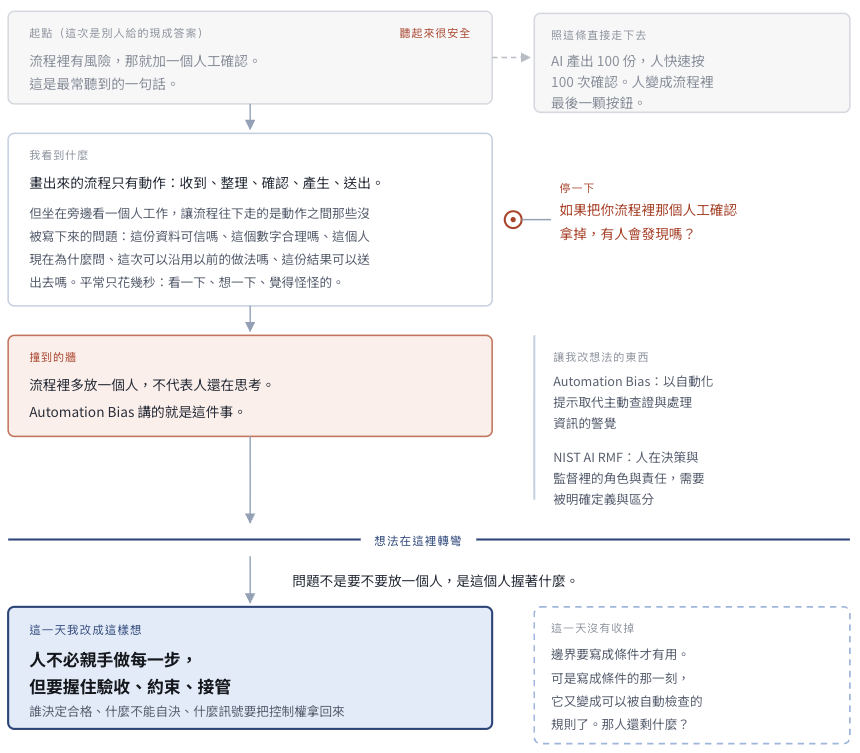
很多流程畫出來之後看起來其實很簡單,從收到資料、整理資料、確認內容、產生結果、送出去。
但真的坐在旁邊看一個人工作,很快就會發現真正讓流程往下走的不只有這一些動作,而是動作之間有一些沒有被寫下來的問題像是以下這幾點。
平常不一定會注意這些事情,因為做久了之後,很多判斷只需要幾秒鐘。
然後決定換一種方式處理。
直到今天真的要把這段工作交給自動化或 AI,才會突然發現:
原來流程裡最重要的地方,不只有那些看得見的動作,而是在決定下一步能不能發生的瞬間。
NIST 在 AI Risk Management Framework 裡特別指出:
“Human roles and responsibilities in decision making and overseeing AI systems need to be clearly defined and differentiated.”
而且在把複雜的人類現象轉換成模型可以處理的量化資訊時,也可能發生:
“removing necessary context.”
也就是昨天提到的那些脈絡,不只決定一份工作好不好自動化,也可能決定自動化之後,人應該在哪裡留下來。
但這裡我不太想簡單地把答案寫成「所以一定要 Human-in-the-loop」。
因為流程裡多放一個人工確認,並不代表人真的還在思考。
Automation Bias 的研究早就發現,當人開始過度依賴自動化系統時,可能降低自己主動尋找與檢查資訊的警覺性。
“the tendency to use automated cues as a heuristic replacement for vigilant information seeking and processing.”
所以如果今天 AI 產生 100 份結果,再讓一個人快速按 100 次確認,我們可能沒有留下真正的 Human Judgment。
只是把人變成流程裡最後一顆按鈕,所以現在反而更在意另外三個問題。
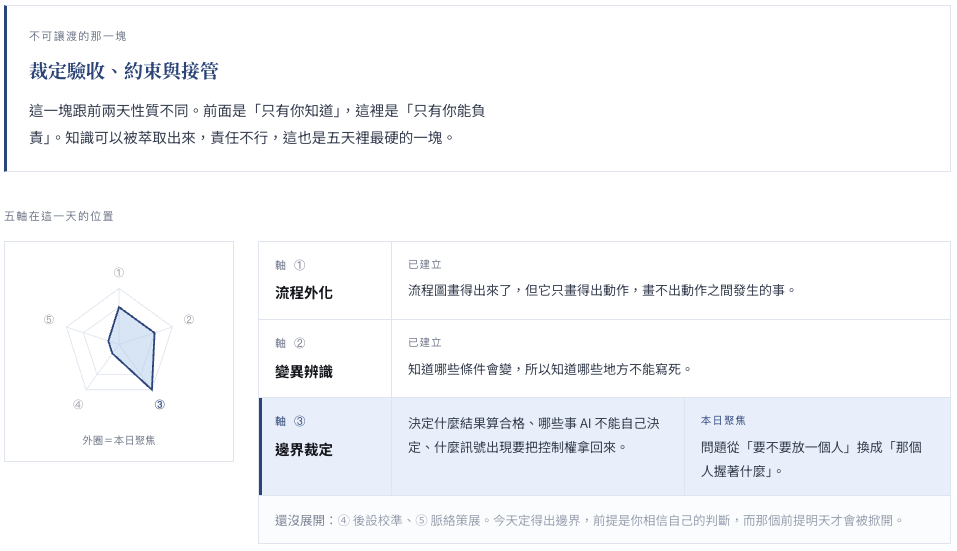
第一問:誰決定這份結果什麼樣子才算合格?
第二問:哪些事情 AI 從一開始就不能自己決定?
第三問:什麼訊號出現時,人必須把控制權拿回來?
這三個問題分別代表驗收、約束與接管,例如 AI 可以整理會議紀錄,但人要先決定什麼資訊不能遺漏,或者是 AI 可以產生客戶回信,但是涉及價格承諾時不能自行寄出。
然後當提到全自動化的時候 AI 可以處理大部分正常資料,但是來源衝突或數值超過特定範圍時,流程必須停下來。
這時候人的角色開始有一點不一樣,人不一定需要親手完成每一個步驟。
但是人仍然必須知道:
什麼結果可以接受。
系統最多可以走到哪裡。
什麼情況不能再讓它自己往下走。
所以今天可以回頭找昨天那件工作,不要再把整條流程重新畫一次,只找出所有曾經讓你停下來「想一下」的位置。
然後在旁邊寫下三件事情:
我剛剛看到了什麼?
什麼條件改變了我的決定?
如果沒有人注意到這件事,最壞會發生什麼?
這些地方,很可能就是未來設計 AI 自動化時真正需要留下邊界的位置。
第一天,我們開始看見工作。
第二天,我們開始看見每一次工作的不同。
第三天,我想再多看見一件事:
一件看起來很簡單的工作,其實可能一直由很多微小的判斷撐著。
而當我們開始把執行交出去,任何目標能夠在幾分鐘或者是幾秒間生成的那瞬間
人真正需要掌握住的不是在於緊盯每一個步驟,而是決定什麼可以發生,以及什麼時候必須停下來的權力


 iThome鐵人賽
 看影片追技術