
文章的內容脈絡
前四天一路拆下來,已經從一件看起來很普通的工作裡,看見流程、變化、判斷,也開始意識到人與 AI 各自都有看不見的地方。
到了這裡就會開始思考一件事情,如果已經知道要做什麼也願意把意圖說清楚,那是不是就可以把事情交給 AI 了?
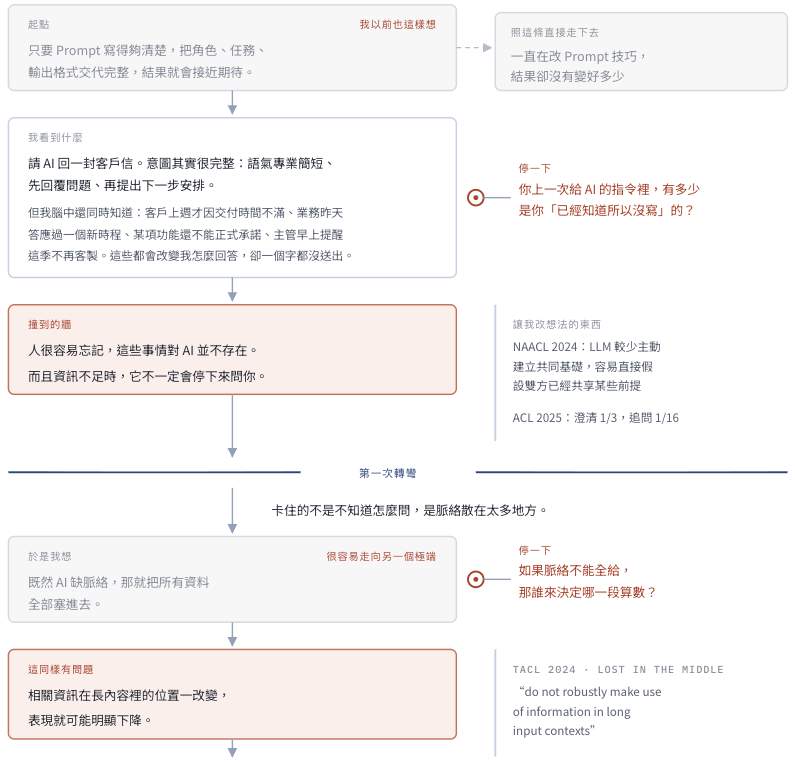
個人以前也很容易把問題想成這樣,只要 Prompt 寫得夠清楚,把角色、任務、輸出格式交代完整,結果應該就會愈來愈接近期待。
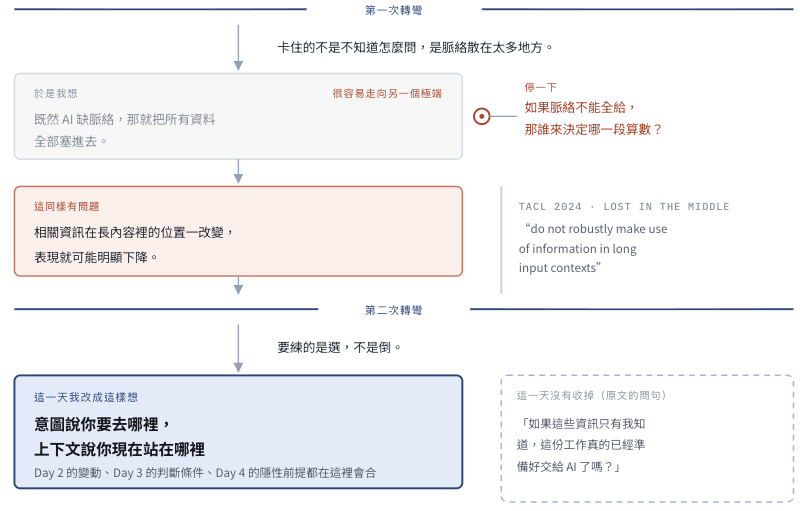
但真正放回每天的工作裡,經常卡住我們的其實不是不知道怎麼問,而是完成這件工作需要的資訊,散落在太多地方。
這個認知非常非常非常的重要
假設今天請 AI 幫忙寫一封回覆客戶的 Email,你可能已經很清楚地告訴它,希望語氣專業、簡短,希望先回覆客戶的問題,再提出下一步安排,意圖其實已經很完整。
但是你自己在真正回信之前,腦中可能還同時知道很多事情,這個客戶上週才因為交付時間不滿,業務昨天答應過一個新的時程,目前某項功能其實還不能正式承諾,而主管早上才提醒這一季不要再提供額外客製需求。
這些資訊不一定存在客戶寄來的那封 Email 裡,但它們都會改變你最後怎麼回答。
所以問題的本質在於人很容易忘記這些資訊對 AI 並不存在。
因為對自己而言,這些事情早就知道了。
這其實延續了昨天談到的人機認知落差,2024 年 NAACL 的研究專門分析語言模型在對話中的 grounding,也就是雙方如何建立共同理解。研究發現相較於人類,LLM 產生的對話更少主動建立共同基礎,反而容易直接假設雙方已經共享某些前提。
“LLMs generate language with less conversational grounding, instead generating text that appears to simply presume common ground.”
這裡最值得帶回工作現場的提醒是,我們不能把自己已經知道的事情,自動等同於 AI 也已經知道。
2025 年 ACL 對 Human-LLM grounding 的進一步研究也發現:
“LLMs were three times less likely to initiate clarification and sixteen times less likely to provide follow-up requests than humans.”
也就是資訊不足時,我們不能預設 AI 一定會停下來追問,它可能仍然利用眼前的資訊繼續完成任務,而且產生一個表面上相當完整的結果。
這也是為什麼會開始覺得真正卡住很多 AI 自動化的地方
往往不是缺少了另一個更厲害的工具,而是缺少一個可以讓工作脈絡重新被找到的方法。
每天完成一件工作需要的資訊,可能散落在 Email、聊天紀錄、會議筆記、Excel、Ticket、文件,甚至只是某個同事昨天口頭提醒的一句話裡。
人工作久了之後會自然在這些資訊之間建立關聯,看到客戶名字就想起上次會議,看到某個專案就知道目前卡在哪裡,看到一個數字異常也可能立刻想起兩週前有人改過資料來源。
這些東西加在一起,才形成我們實際工作時使用的 context。
所以當我們跟生成式 AI 對話時,只說:
幫我分析這份資料。
或者更進一步說:
幫我分析這份資料,我想找出這個月業績下滑的原因。
第二句確實多了意圖,但可能還是不夠。
因為真正會影響分析結果的資訊也許是,上個月調整過計算方式、其中一個市場剛換代理商、這份資料缺少兩天交易紀錄,而主管這次真正想確認的是下降來自需求還是供應限制。
意圖告訴 AI 你想去哪裡,上下文才告訴它現在究竟站在哪裡。
談到這裡很容易走向另一個極端,就是既然 AI 缺少脈絡,那就把所有資料全部塞進去,也是會有問題。
2024 年刊登於《Transactions of the Association for Computational Linguistics》的《Lost in the Middle》研究測試語言模型如何使用長上下文,研究發現,相關資訊在長內容中的位置改變,就可能顯著影響模型表現。
“performance can degrade significantly when changing the position of relevant information”
研究甚至觀察到,即使是支援長上下文的模型,在相關資訊位於大量內容中間時,表現仍可能下降。
“current language models do not robustly make use of information in long input contexts.”
所以建立工作脈絡並不等於把所有東西丟給 AI。
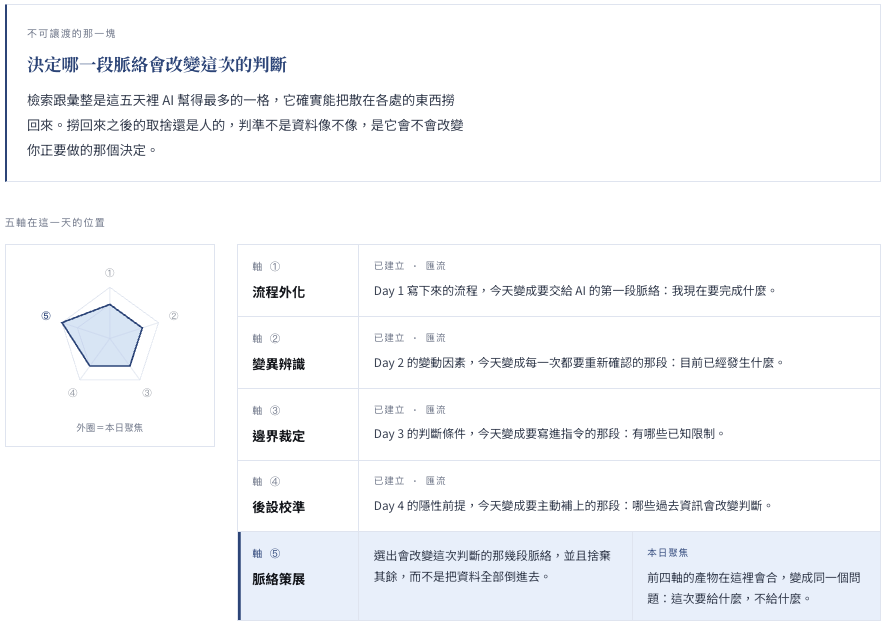
真正需要培養的能力,是知道這一次工作需要哪些脈絡,而且哪些資訊會真正改變下一個判斷。
這與前幾天其實是同一件事情的延伸。
Day 2 找出的那些變動因素,Day 3 找出的判斷條件,Day 4 找出的隱性前提,到了今天都開始變成需要主動提供的 Context。
今天可以挑一個原本就會使用生成式 AI 處理的工作。先不要改 Prompt 技巧,也不用加入一堆複雜指令,只是在送出問題之前,多補四件事情。
我現在真正要完成什麼。
除了描述動作,也說明最後拿這個結果來做什麼決定。
目前已經發生什麼。
補上會影響這次工作的近期事件、前一個步驟與目前狀態。
有哪些已知限制。
例如不能承諾的事情、不可使用的資料、時間與權限邊界。
有哪些過去資訊會改變判斷。
例如前一次決策、客戶歷史、特殊例外,以及團隊已經確定不再重複討論的事情。
再看看這一次得到的結果,和單純描述意圖時有什麼不同。
長期來看真正有價值的甚至不只是每一次多寫這四段話,而是開始思考,這些資訊原本散落在哪裡,為什麼每一次都需要靠人重新尋找,以及哪些脈絡值得被留下來,讓下一次工作可以更快重新建立。
因為當我們開始談 AI 自動化,真正需要被傳遞的從來不只有一個 Task,還需要包含讓這個 Task 在當下成立的 Context。
前四天一直在學著把工作裡原本看不見的東西找出來,到了第五天可以開始問下一個問題:
如果這些資訊只有我知道,這份工作真的已經準備好交給 AI 了嗎?


 iThome鐵人賽
 看影片追技術