
目前我們已經知道context window是有上限的,丟太多內容給模型不一定有用,因此對上下文(context)的管理格外重要。context engineering就是因此而誕生。
之前提到的prompt engineering是針對模型的指令內容做優化,關注單一次請求內的訊息內容。context engineering處理的問題層次更高,旨在正確的時間為LLM提供相關的資訊、工具描述以及結構化的指令,確保LLM完成任務。
從今天開始會分享目前在業界中比較有共識的框架,主要參考LangChain發表關於agent context engineering 的文章。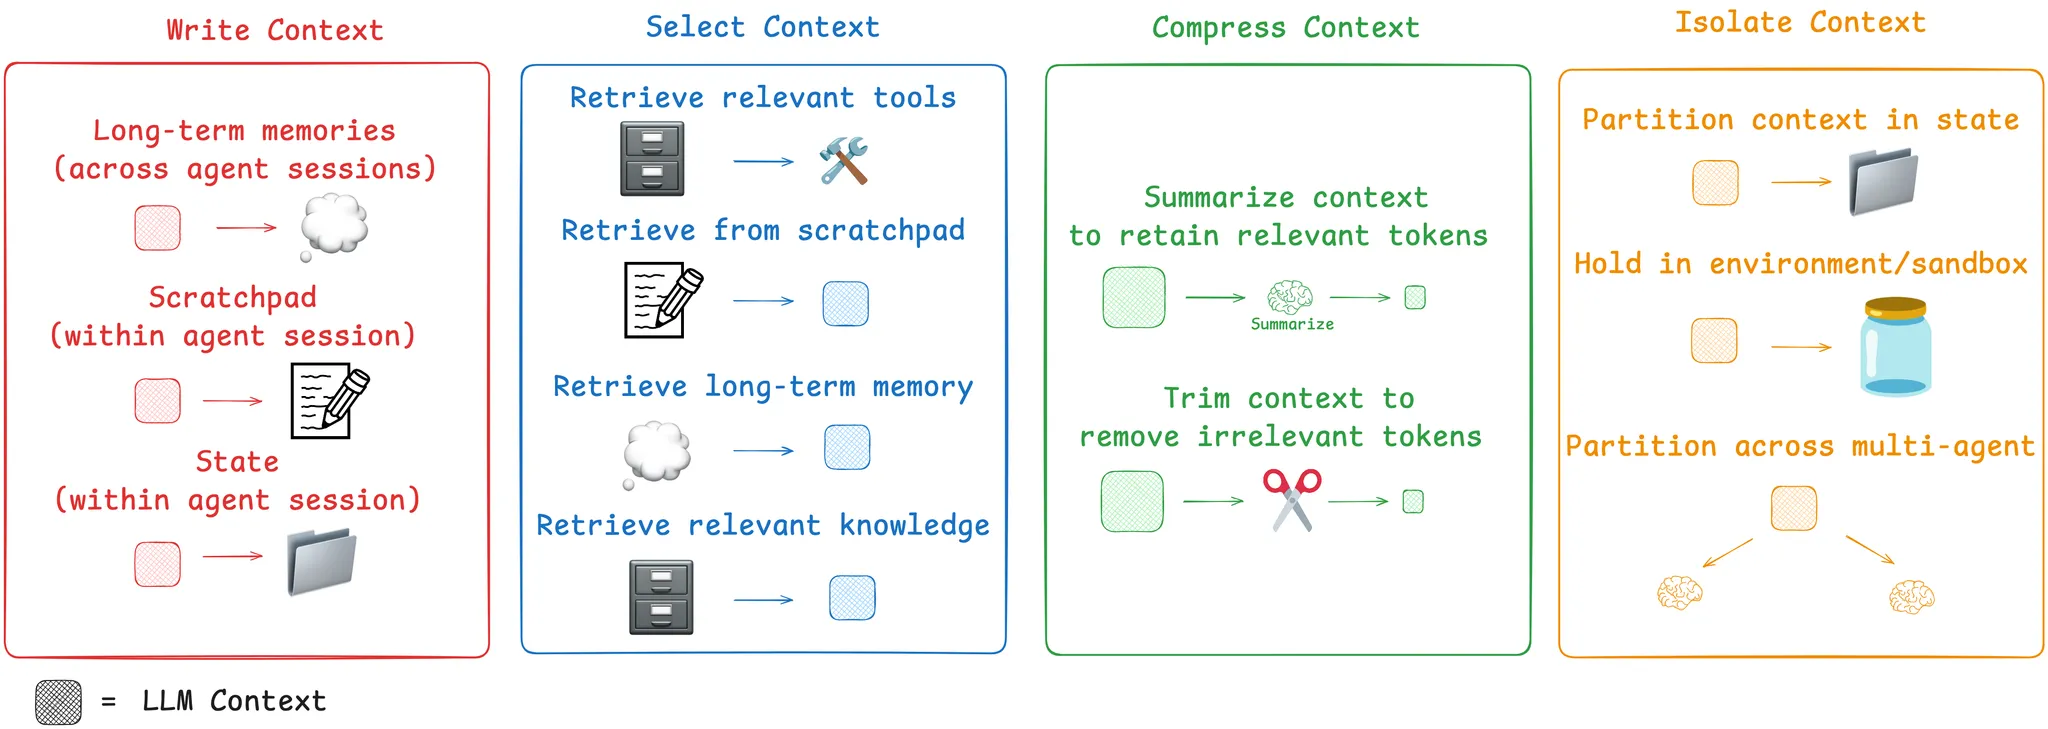
文章內把管理context的手法分成四大類,Write(寫入)、Select(挑選)、Compress(壓縮)、Isolate(隔離)。接下來會依序分享,首先來講第一個:Write。
Write 的核心概念很直覺:不是所有東西都得留在對話裡,該存起來的,先存到 context window 之外。
想像一個要跑很久的任務——例如一個 agent 要研究一個主題、逐步收集資料、最後整理成報告。如果它把每一步的想法、每一次查到的東西都留在對話歷史裡,對話會越滾越長,遲早會撞到 Day 10 講過的上限,甚至更早之前就已經被 Day 10 提到的「lost in the middle」現象拖累品質。Write 的做法是:把這些中間過程「寫」到一個外部的地方存起來,而不是全部塞在當下的 context 裡。
常見的兩種形式:
Scratchpad 是任務執行期間用的暫存空間,用來記錄計畫、進度、中間結果,不需要每次都完整攤在對話裡。例如 Anthropic 的多代理研究系統,會把當下的執行計畫寫進一個獨立的 memory,而不是全部塞進對話——因為一旦對話累積到一定長度就會被截斷,先寫下來,才不怕被截斷之後就找不回來。
一個簡化的示意:
scratchpad = {}

def save_progress(task_id, note):
    scratchpad[task_id] = scratchpad.get(task_id, []) + [note]

save_progress("research_llm", "已查到 A 論文的重點:xxx")
save_progress("research_llm", "已查到 B 論文的重點:yyy")

# 對話裡不需要每次都帶著這些細節,需要時再從 scratchpad 讀回來
長期記憶處理的是另一個時間尺度的問題:這次 session 學到的東西,怎麼留給下一次 session 用,而不是每次對話都從零開始。像 ChatGPT、Cursor 這類工具會自動累積使用者的偏好、過去互動裡的重點,就是這個概念的實際應用——這次對話裡使用者提到自己是後端工程師、習慣用某種寫法,下次對話開啟時,這些資訊已經在那裡,不用重講一次。
Write 解決的是「先把東西放到一個不佔用當下 context 的地方」,但存起來的東西終究要在對的時機被拿回來用。如何在對的時機把對的內容拉回來,就是明天要談的 Select。
Write 的重點是「把資訊存到context window外的地方」,scratchpad 處理任務進行中的暫存資訊,長期記憶處理跨 session 的累積。這兩種形式都是為了同一個目的,讓當下的 context window 不用一次扛下所有資訊,把不急著用的部分先放到別處。
明天會接著分享 Select:如何在對的時機,將需要的內容放回context中。
參考內容:LangChain


 iThome鐵人賽
 看影片追技術